
Hermes Agent メモリシステム:永続的AIメモリの動作原理
メモリこそが、ツールとパートナーとの違いを創り出す。
AI エージェントとのチャットを開始し、プロジェクトの概要を説明し、好みを共有し、いくつかの作業を行い、タブを閉じる。その翌週にもう一度戻ってくると、まるで見知らぬ人と話しているかのようですね。すべてのコンテキストが失われ、すべての好みは忘れられ、プロジェクトはゼロから再説明しなければなりません。
これはバグではありません。大規模言語モデル(LLM)の本質的な動作原理です。それらはステートレス(状態非依存)であり、各リクエストは独立しています。各レスポンスは、現在のコンテキストウィンドウ内のトークンを超えて、メモリや履歴、連続性を持たず、まさにその瞬間に送信したプロンプトから生成されます。
シングルターンのやり取りであれば、それで問題はありません。質問をして、答えを得て、次に進めばいいだけです。しかし、エージェント——つまりセッション間で作業を行うこと、ミスから学び、ユーザーと共に進化することが求められるシステム——にとって、ステートレスさはハードウェア的な建築的制限です。これは、セルフホスト AI システムにおける中心的な未解決課題の一つです。
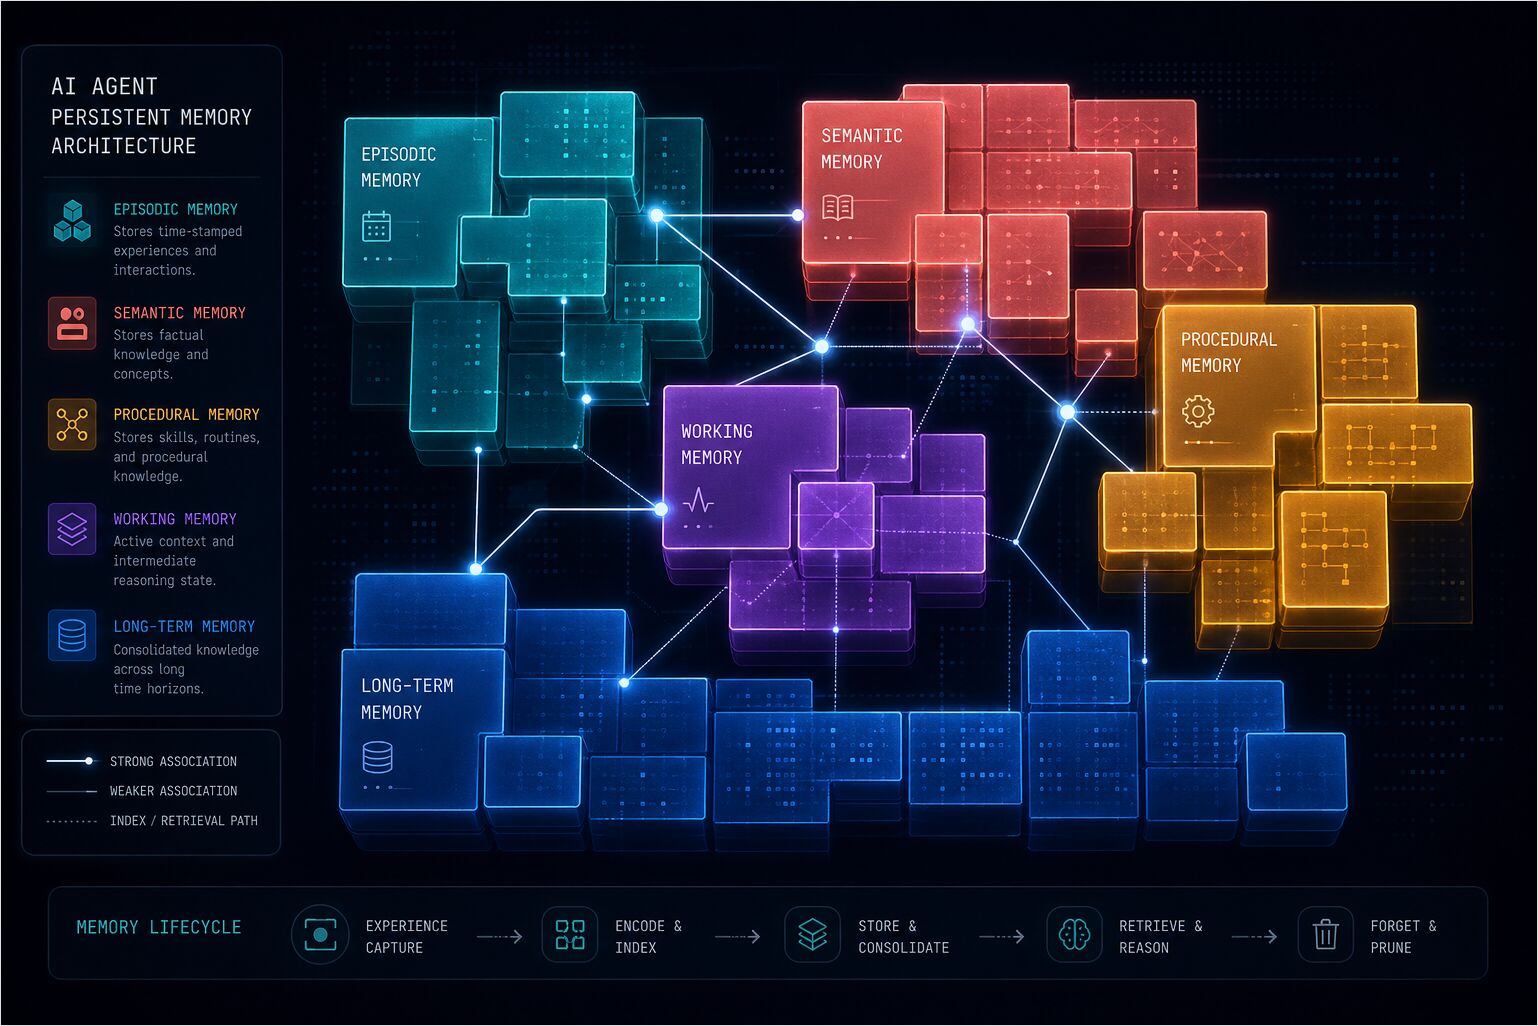
業界はこの問題を解決するためにさまざまな試みを行ってきました。LangChain はメモリモジュールを追加しました。OpenAI はスレッドを備えたアシスタントを導入しました。Letta、Zep、Cognee などのフレームワークは、永続メモリを中心に据えたアーキテクチャ全体を構築しました。Databricks は「メモリスケーリング」について論文を発表しました。これは、蓄積された経験によってエージェントのパフォーマンスが向上するという考え方です。2024 年以降、エージェント AI における中心的な未解決課題として認識されつつあるこの問題を対処するために、専用のベンチマーク論文、エピソード記憶のサーベイ、そして急速に成長するツールエコシステムが登場しました。
これらのアプローチの多くは、共通の問題点を抱えています。メモリを「後から追加するもの」として扱っている点です。クエリするデータベース、詰め込むコンテキストウィンドウ、明確さではなく遅延やノイズを追加する検索システムとして扱われているのです。
Hermes Agentは、根本的に異なるアプローチを採用しています。メモリは、エージェントが必要な時に取得するものではありません。エージェントが常に有するものです——システムプロンプトに組み込まれ、キュレーションされ、制限付きであり、常にアクティブです。それは速く保つのに十分小さく、有用に保つのに十分に構造化され、何々を忘れるべきかを知るのに十分に規律正しくあります。
この記事では、その仕組みを正確に説明します。AI アシスタントにおけるメモリシステムにあるクロスフレームワークモデルの内部にある Hermes 固有のレイヤー、および AI アシスタントアーキテクチャのより広いスタックです。起動とインスペクションコマンド(hermes memory、hermes dump、ログテール表示)については、Hermes Agent CLI チートシートと併せてご使用ください。Hermes の「長期知識」の補完的な側面——キュレーションされたメモリファイルではなく、再利用可能な手順である SKILL.md —については、Hermes Agent Skill Authoring — SKILL.md 構造とベストプラクティスを参照してください。
Part 1: AI エージェントのメモリ問題
なぜエージェントには「コンテキストを追加するだけ」では拡張できないのか
ステートレスな AI に対する明らかな解決策は、コンテキストを追加することです。以前の会話をつなぎます。プロジェクトドキュメントを含めます。全履歴を送信します。
しばらくの間、それは機能します。128K のコンテキストウィンドウがあると仮定しましょう。そこには大量のテキストを収容できます。
しかし、コンテキストはメモリではありません——それらには実際の、重要な違いがあります。コンテキストとは、まさに今見せられているすべてであり、メモリとは、あなたが能動的に保持し、持ち運ぶものです。
コンテキストにはキュレーションがありません。それはダンプです:それが成長するにつれて、モデルは必要な 1 つの事実を見つけるために、無関連な履歴の何千ものトークンを処理しなければなりません。それは トークンと金銭のコストを発生させ、遅延を増幅し、最終的には上限に達します。
メモリはキュレーションされています。それは経験をコンパクトで実行可能な何らかに蒸留したものです。それは無限に成長しません——統合し、更新し、忘れます。
人間のメモリも同じように機能します。あなたが今までに持ったすべての会話を覚えているわけではありません。重要な部分を覚えています:誰と話をしているか、彼らが何に関心を持っているか、何が合意されたか、何を学んだか。残りは、必要になれば検索可能か、単に忘れ去られます。
研究の現状
AI エージェントメモリ領域は 2024 年以降、爆発的に成長し、専用のベンチマークスイート、成長する研究文献、そして異なるアーキテクチャアプローチ間の測定可能なパフォーマンスのギャップを生み出しています。現在の状況は以下の通りです。
Letta(旧 MemGPT)は、永続メモリを第一級関心事として扱う最も初期のフレームワークの一つであり、GitHub でのスター数が 21.7K に達しています。OS に着想を得た 3 層モデルを使用します:コアメモリ(小さく、常にコンテキスト内)、リコールメモリ(検索可能な会話履歴)、アーカイブメモリ(長期のコールドストレージ)。すべてのメモリが等価ではないというインサイトは正しかったです。しかし、実装としては、エージェントが完全に Letta ランタイム内で実行されることを必要とします——それを採用することは、メモリレイヤーだけでなく、プラットフォーム全体を採用することを意味します。
Zep / Graphiti は、時間的エンティティトラッキングを伴う会話メモリに焦点を当てています——事実には有効期間ウィンドウが伴うため、グラフはいつ何が真実であったかを知ることができます。関係グラフを必要とするチャットボットには強力ですが、環境事実とプロジェクト規約をトラッキングする自律エージェントにはあまり適していません。
Cognee は、ドキュメントと構造化データからの知識抽出のために構築されており、30 以上の取り込みコネクタとナレッジグラフバックエンドを備えています。組織的知識と RAG パイプラインに優れていますが、パーソナルエージェントメモリにはあまり焦点が当てられていません。実用的なセットアップガイドについては、ローカル LLM を用いた Cognee のセルフホスティングを参照してください。
Hindsight は、エンティティ関係と、複数メモリの統合を新しいインサイトに変換する独自の reflect 統合ツールを備えた、知識グラフベースのリコールを行います。エージェントメモリベンチマークにおいてトップクラスの性能を誇り、Hermes Agent のメモリプロバイダーとして利用可能です。
Mem0 は、LLM 分析を通じてサーバーサイドでメモリ抽出を処理し、最小限の設定で済みます。Mem0 の研究論文は ECAI 2025 で発表され(arXiv:2504.19413)、AI メモリへの 10 つの異なるアプローチをベンチマークし、選択的抽出アプローチ——離散的な事実を保存し、重複を除去し、関連するもののみを検索すること——を検証しました。Mem0 は現在約 48K の GitHub スター数を有し、21 のフレームワーク統合をサポートしています。トレードオフはクラウドへの依存とコストです。
Databricks のメモリスケーリング研究は、蓄積された経験によってエージェントのパフォーマンスが向上するという概念を導入しました。彼らのアーキテクチャは、組織レベルとユーザーレベルでスコープ設定されたシステムプロンプト、エンタープライズ資産、エピソード/意味的メモリを保持し、メモリ品質がモデル能力と同様に重要であるという考え方を検証しました。
ほとんどのフレームワークに共通する点として、メモリを検索問題として扱っていることが挙げられます:どこかに保存し、必要時にクエリし、コンテキストに注入する。Hermes はその逆をします——メモリはオンデマンドで取得されるのではなく、セッション開始時に注入され、常に存在します。常にアクティブで、常に利用可能で、有用性を維持するのに十分キュレーションされています。
Part 2: アーキテクチャ
このパートは上から下へお読みください——まずレイヤーとターンごとのリコール/ストア、次にMEMORY.md と USER.md に何が存在するか、最後に外部プロバイダーをどうアタッチするかです。
2 つのレイヤー
Hermes はメモリを2 つのレイヤーにスタックしています:
- 組み込み —
MEMORY.mdとUSER.md、ファイルバックド、常にアクティブ。エージェントノートは2,200文字、ユーザープロファイルは1,375文字というハードキャップ。 - 1 つの外部プロバイダー(オプション) — Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、Supermemory など、設定で有効化できる同種のプロバイダー。一度に 1 つのみの外部バックエンドが実行されます。これはファイルの横に検索と保持を追加しますが、それらを置き換えるものではありません。
メンタルモデルは加法的です——凍結されたコアファイルに、最大 1 つのプラグインが加わります。プリフェッチとシンクフックが外部レイヤーをオーケストレーションし、2 つのファイルは凍結システムプロンプトの一部として個別に注入され続けます。
ランタイムフロー(プリフェッチとシンク)
リコールはモデルが回答する前に行われ、永続化はアシスタントメッセージの後に行われます。Hermes Agent のメモリマネージャでは、これは入力時のプリフェッチと出力時のシンクに映射されます。以下に示す名前は実装サーフェス(MemoryManager、プロバイダーごとの prefetch / sync_turn / queue_prefetch)と一致しています。
User message
    |
    v
MemoryManager.prefetch_all(query)        <-- リコールフェーズ
    |
    +-- provider.prefetch(query)        <-- 各外部プロバイダーがそのストアを検索
    |
    v
コンテキストが LLM ターンに注入
    |
    v
LLM が応答(アシスタントメッセージ)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- ストアフェーズ
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- 次のターンに向けたバックグラウンド検索
組み込みの MEMORY.md と USER.md は prefetch_all を通じて取得されません——それらはすでに凍結システムプロンプトの一部です。外部バックエンドは prefetch_all / sync_all に接続し、queue_prefetch は現在の応答をブロックせずに次のターンへの検索をウォームアップするためにプロバイダーを使用できます。
長期メモリへの 3 つの経路
-
組み込み
memoryツール。 モデルは、指示が何か永続化するべきことを示している場合(永続的な事実、好み、修正、環境ノート)、memoryをadd、replace、またはremoveで呼び出します。target='user'は USER.md を維持し、target='memory'は MEMORY.md を維持します。例の形:memory(action='add', target='user', content='…')。 -
外部プロバイダーのパッシブ保持。 各ターンでフレームワークはプロバイダーのシンクパスを呼び出し、モデルがすべての事実を明示的に命名しなくても、会話がチャンク化、要約、または抽出され得ます。挙動はバックエンドによって異なります——例えば Hindsight はターンをバッチ処理し、エンティティと関係を持つ構造化保持を実行し、Honcho は対話をその弁証法的パイプラインを通し、Mem0- や Supermemory- スタックはターンからパッシブに事実を抽出します。
-
プロバイダー固有のツール。 プラグインがそれらを公開する場合、
honcho_conclude、hindsight_retain、またはhoncho_profileといった明示的な書き込みが、オンデマンドで永続的なスライスを保存します。
自動リコール versus プロバイダーツール
コアメモリは読み取りツールを必要としません——それはすでにプロンプト内にあります。外部バックエンドは、プリフェッチからの自動注入(そのコンテキストスライスに対する個別のリコールツール呼び出しなし)、またはモデルがプリフェッチ単独よりも鋭いクエリを必要とする場合の明示的な検索ツール(honcho_search、honcho_reasoning、honcho_context、hindsight_recall、hindsight_reflect、および同僚たち)のいずれかを追加します。
リコールモード(外部プロバイダー)
プラグインは、制御のためにトークンを交換する設定可能なリコールモード(通常は設定内の memory.provider の横にある recall_mode)をサポートしています。
| モード | プリフェッチからの自動注入 | 利用可能なプロバイダーツール | 典型的な適用例 |
|---|---|---|---|
| context | はい | いいえ | ハンドズオフ、予測可能なコンテキスト |
| tools | いいえ | はい | モデルがいつ検索するか選択 |
| hybrid | はい | はい | 最もリッチなコンテキスト;トークン使用量が高い |
外部プロバイダーが設定されていない場合(memory.provider が空または未設定)、適用されるのは組み込みファイルとセッション検索のみです——プラグインからのプリフェッチ/シンクはありません。
ディスク上のパスと予算
Hermes Agent の組み込みメモリは 2 つのファイル内に存在します。
~/.hermes/memories/MEMORY.md— エージェントの個人ノート(2,200 文字、約 800 トークン)~/.hermes/memories/USER.md— ユーザープロファイル(1,375 文字、約 500 トークン)
これが永続メモリサーフェスのすべてです:2 つのファイル、合計 3,600 文字未満、1,300 トークン未満。意図的に小さく見えるのは、それがそうだからです——そしてまさにそれが設計意図なのです。
MEMORY.md: エージェントのノート
ここには、エージェントがその環境、プロジェクト、ツール、規約、学んだ教訓について学習したすべてを保存します。それの見た目はこのようになります:
User's project is a Go microservice at ~/code/gateway using gRPC + PostgreSQL
This machine runs Ubuntu 22.04, has Docker and kubectl installed
User prefers snake_case for variable names and avoids camelCase
これらはログではありません。それらは事実です。密で、宣言的であり、情報過多です。タイムスタンプも、無駄も、「1 月 5 日にユーザーは私に〜と言いました」という類のものもありません。
USER.md: ユーザープロファイル
ここには、エージェントがあなたについて知っているすべてを保存します。
User is a full-stack developer comfortable with TypeScript, Go, and Python.
User prefers snake_case for variable names and avoids camelCase.
User primarily uses Linux Ubuntu 22.04.
User deploys to AWS using Terraform.
アイデンティティ、役割、好み、技術スキル、コミュニケーションスタイル、嫌いなこと。エージェントがあなたに対して、他の誰かとは異なるように反応させるものです。
凍結スナップショットパターン
セッション開始時、両方のファイルはディスクから読み込まれ、システムプロンプトに凍結ブロックとして注入されます。それの見た目はこのようになります:
══════════════════════════════════════════════
MEMORY (your personal notes) [7% — 166/2,200 chars]
══════════════════════════════════════════════
User's project is a Go microservice at ~/code/gateway using gRPC + PostgreSQL
§
This machine runs Ubuntu 22.04, has Docker and kubectl installed
§
User prefers snake_case for variable names and avoids camelCase
§
══════════════════════════════════════════════
USER PROFILE (who the user is) [8% — 110/1,375 chars]
══════════════════════════════════════════════
User is a full-stack developer comfortable with TypeScript, Go, and Python.
§
User prefers snake_case for variable names and avoids camelCase.
§
このフォーマットは、ヘッダー、使用率、文字数、および §(セクションシグン)区切りを使用します。エントリは複数行であることができます。それはモデルによってパース可能でありながら、人間にとって読みやすいように設計されています。
なぜ凍結なのか?プレフィックスキャッシュのためです。システムプロンプトはセッション内のすべてのターンで同じです。セッション開始後にメモリを静的に保つことで、モデルはプレフィックス計算をキャッシュし、可変な部分——つまり会話——のみを処理できます。これは顕著なパフォーマンス最適化です。あなたは各ターンで同じメモリトークンに対して注意を再計算しているわけではありません。
セッション中にされた変更は即座にディスクに永続化されますが、それらは次のセッション開始時のみシステムプロンプトに現れます。ツールレスポンスは常にライブステータスを表示しますが、モデルの「心」はセッション中に変わりません。これにより、モデルが自身の尻尾を追うことを防ぎます——メモリを更新し、そして同じ会話の中でその自身の更新に反応すること。
文字数制限という機能
2,200 文字。1,375 文字。これらは恣意的な制限ではありません。キュレーションを強制する設計制約です。
無制限のメモリは負資産です。すべてのものを突っ込み、決して統合せず、最終的にノイズになることを助長します。制限付きメモリは、エージェントを選択的にすることを強制します。実際に重要なのは何か?次に必要になりそうなのは何か?意味を失わずに圧縮できるのは何か?
メモリが満杯になると、エージェントはただ静かに失敗するわけではありません。現在のエントリと使用率を伴うエラーを受け取り、その後ワークフローに従います:
- エラーレスポンスから現在のエントリを読み取る
- 削除可能または統合可能なエントリを識別する
replaceを使用して関連するエントリを短いバージョンに統合する- 新しいエントリを追加する
これがメモリが有用性を保つ方法です。それはデータベースではありません。それは重要で、重要な事実のキュレーションされたコレクションです。
セキュリティ:プロンプトインジェクションのスキャン
すべてのメモリエントリは、承認前にスキャンされます。システムは、プロンプトインジェクションの試み、認証情報の流出、SSH バックドア、および見えない Unicode 文字をブロックします。
メモリも重複排除されます。完全な重複エントリは自動的に拒否されます。これにより、敵対者が繰り返し送信を通じて悪意のある内容を注入しようとするのを防ぎます。
外部メモリプロバイダー(アクティベーションとリンク)
組み込みの MEMORY.md と USER.md のほかに、Hermes Agent は一度に1 つの外部メモリプラグインをアタッチできます——Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、または Supermemory——永続的かつセッション間の知識のために。一度に 1 つのみの外部プロバイダーがアクティブです;2 つのコアファイルはそれと並んで読み込まれ続けます(加法的であり、置き換えではありません)。
hermes memory setup、hermes memory status、および hermes memory off を使用してプロバイダーをアクティベーションし、インスペクションしたり、または ~/.hermes/config.yaml で memory.provider と recall_mode を設定します。認証情報のパターンは異なります(例えば HINDSIGHT_API_KEY、$HERMES_HOME/honcho.json 配下の Honcho キーなど);対話的な配線には hermes memory setup を使用します。
最小限の組み込みのみ YAML 形:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
1 つのバックエンドのアクティベーション例(インストールがサポートする hindsight を honcho、mem0、supermemory、または他のものに置き換えます):
memory:
  provider: "hindsight"
完全な比較表、LLM とエンベディング依存関係の注記、プロバイダーごとの詳細、およびこれらのバックエンドが OpenClaw と他のスタックにどのように関連するかについては、**エージェントメモリプロバイダーの比較を参照してください。異常に細粒度な書き込み制御を備えたローカル、セルフホストプロバイダーについては、Mnemosyne for Hermes Agent: Local Memory Quickstartを参照し——なぜ Hermes 自身の MEMORY.md のような制限付き、キュレーションされたメモリが、構築上、いくつかのフィードバックループ障害モードを回避するのかについては、AI エージェントにおける自己強化メモリループ**を参照してください。
プロファイル固有の配線と本番環境ワークフローについては、Hermes Agent production setupを参照してください。**AI Systems Memory hub**は、このガイドと関連する Cognee およびナレッジレイヤーの記事をリストしています。
Part 3: メモリが発火するとき — トリガーと判断
Hermes Agent のメモリに関する最も一般的な質問は、実際に何かが保存されるのはいつかというものです。
答えは:絶えず、しかし選択的にです。エージェントは memory ツールを通じて自身のメモリを管理し、保存の判断は明示的なシグナルと暗黙のパターンの組み合わせによって駆動されます。
書き込みトリガー:エージェントは何をトリガーに保存するの決定するのか
エージェントは能動的にメモリを保存します。あなたが尋ねるのを待ちません。何がトリガーになるかを示します。
ユーザーの修正。 あなたがエージェントを修正したとき、それは記憶するためのシグナルです。「またそのことをしないでください。」「代わりにこれを使用してください。」「これ覚えておいてください。」これらはメモリを更新する明示的な指示です。
例:あなたが Python 環境を設定するようにエージェントに求めます。それは pip を提案します。あなたが「私はすべてで poetry を使っている」と言います。エージェントは保存します:User prefers using the 'poetry' package manager for all Python projects.
発見された好み。 エージェントはパターンを観察し、好みを推測します。あなたが一定のツール、フレームワーク、またはワークフローを一貫して使用する場合、それは保存されます。
例:異なるプロジェクト間で poetry を複数回使用するのを確認した後、エージェントはそれを好みとして保存します。
環境事実。 マシン、プロジェクト、インストールされたツールについてのこと。これらは探索を通じて発見され、事実として保存されます。
例:エージェントは何がインストールされているかを確認し、保存します:This machine runs Ubuntu 22.04, has Docker and kubectl installed.
プロジェクト規約。 プロジェクトがどのように構造化されているか、どのようなツールを使用しているか、どのようなパターンに従っているか。これらはコードインスペクションを通じて発見され、保存されます。
例:User's project is a Go microservice at ~/code/gateway using gRPC + PostgreSQL.
完了した複雑なワークフロー。 5 回以上のツール呼び出しを要したタスクを完了した後、エージェントはそのアプローチをスキルとして保存するか、少なくとも何が機能したかを注記することを検討します。
ツールのクセとワークアラウンド。 エージェントがツール、API、またはシステムについて自明でない何か——制限、ワークアラウンド、規約——を発見したとき、それは保存されます。
何がスキップされるか:
- 自明または明白な情報
- 簡単に再発見できるもの
- 生データのダンプ
- セッション固有の一時的なもの
- コンテキストファイル(SOUL.md、AGENTS.md)にすでにある情報
読み取りトリガー:エージェントは何をトリガーにリコールするのか
メモリは検索されません——それは常に那里にいます。しかし、アクセスには異なるレベルがあります。
セッション開始(自動)。 MEMORY.md と USER.md はシステムプロンプトに注入されます。エージェントは最初のトークンからそれを持っています。クエリも、遅延も、ツール呼び出しも必要ありません。これがコアメモリです——常にアクティブです。
session_search(オンデマンド)。 エージェントがコアメモリになくて、過去の会話から何かを見つけたい場合、session_search ツールを使用します。これは SQLite(~/.hermes/state.db)を FTS5 フルテキスト検索と Gemini Flash 要約でクエリします。「これについて以前話し合った」のような音する質問に対して、かつ「この事実を永遠に覚えておいて」という場合ではなく、これを使用します。
例:あなたが「先週 Docker ネットワーキングについて話し合いましたか?」と尋ねます。エージェントはセッション履歴を検索し、関連する会話の要約を返します。
外部プロバイダーツール(設定された場合)。 外部メモリプロバイダーがアクティブである場合、フレームワークは各応答の前に自動的なプリフェッチステップを実行もします(Part 2 参照)。honcho_search、hindsight_recall、または mem0_search といった追加のツールは、エージェントが明示的な検索を選択する場合の標的のある検索用です——recall_mode に応じて、自動注入、ツール、またはその両方がアクティブになり得ます。
意思決定木
エージェントが「これは記憶する価値があるのか?」をどう重み付けするかを示します:
Is this a correction or explicit instruction?
  YES → Save to memory
  NO → Is this a preference or pattern?
    YES → Save to user profile
    NO → Is this an environment fact or convention?
      YES → Save to memory
      NO → Is this easily re-discovered?
        YES → Skip
        NO → Is this session-specific?
          YES → Skip
          NO → Save to memory
エージェントはこれを深く考えません。能動的に保存し、満杯になると統合し、文字数制限が物事を引き締めてくれることを信じています。
Part 4: 内部メモリ versus 外部ナレッジベース
ここにはしばしば混乱が起きます。Hermes Agent は内部メモリ(MEMORY.md、USER.md、外部プロバイダー)と外部ナレッジベース(LLM Wiki、Obsidian、Notion、ArXiv、ファイルシステム)を有し、それらは完全に異なる役割を果たします。これは 検索拡張生成パイプラインとエージェントワークメモリとの区別に似ています——外部検索は深い知識の検索には良いですが、アイデンティティと好みを運ぶためではありません。内部メモリはエージェントの脳です——常にアクティブで、キュレーションされ、すべてのセッションに持ち込まれます。外部ナレッジベースはその図書館です——オンデマンドで参照される膨大なリファレンスリソースです。
区別
内部メモリ(脳):
- 小さく、永続的で、システムプロンプトに注入される
- 含むもの:ユーザー好み、エージェント規約、即座の教訓
- 会話中に常に「頭の中」にある
- キュレーションされ、制限付きで、能動的に管理される
- 例:MEMORY.md、USER.md、Honcho、Hindsight、Mem0
外部ナレッジベース(図書館):
- 膨大で、リファレンス専用で、オンデマンドでアクセスされる
- 含むもの:ドキュメント、論文、コード、ノート、データベース
- 必要時にツール経由でアクセスされる
- 「記憶」されるのではなく——参照される
- 例:LLM Wiki、Obsidian、Notion、ArXiv、ファイルシステム、GitHub
関連性
エージェントは必要に応じてツール経由で外部ベースにアクセスします。それらを「記憶」するのではなく——それらを参照します。
LLM Wiki (llm-wiki): カルパthy による、ドメイン知識の構築とクエリのための相互リンクされた Markdown ナレッジベース。エージェントは llm-wiki スキルを使用してそれを読み、検索し、クエリします。それはリファレンスリソースであり、メモリではありません。
Obsidian: 双方向リンクを備えたパーソナルノートボルト。エージェントは obsidian スキルを使用してノートを読み、検索し、作成します。Obsidian は、Hermes が図書館リソースとして活用できるより広い パーソナルナレッジマネジメントエコシステムの一部分です。
Notion/Airtable: API 経由でアクセスされる構造化データベースとウィキ。エージェントは必要時にそれらをクエリします。
ArXiv: 学術論文リポジトリ。エージェントはトピックを調査する際に論文を検索し、抽出します。
ファイルシステム: プロジェクトコード、ドキュメント、設定。エージェントはプロジェクト作業中にファイルを読みます。
蒸留パターン
ここが主要なインサイトです:外部ベースからの重要なインサイトは、内部メモリに蒸留され得ます。
例:エージェントは AI エージェントのメモリスケーリングに関する ArXiv の論文を読みます。それは論文全体をメモリに保存しません。重要な要点を保存します:Memory scaling: agent performance improves with accumulated experience through user interaction and business context stored in memory.
外部リソースは膨大です。内部メモリはその蒸留です。
いつ何を使用するか
内部メモリには:
- 「誰を助けているのか?」
- 「彼らは何を好むのか?」
- 「たった今何学んだか?」
- 「プロジェクトセットアップは何か?」
- 「どのようなツールが利用可能か?」
外部ナレッジベースには:
- 「X について最新の研究は何か?」
- 「プロジェクトのドキュメントには何が書いてあるか?」
- 「先月何を話し合ったか?」
- 「このサービスの API は何か?」
- 「コード構造は何か?」
エージェントは違いを理解し、それぞれを適切に使用します——ドキュメントの参照を、あなたとあなたの環境について学んだ何かをリコールすることと混同しません。
Part 5: それは実際にどのように機能するのか
メカニクスを見てみましょう。
memory ツール
エージェントは、3 つのアクション——add、replace、remove——を持つ単一のツールを通じてメモリを管理します。
read アクションはありません——メモリ内容はシステムプロンプトに自動注入されます。エージェントはそれを読む必要はありません。なぜなら、それが常に那里にあるからです。
add — 新しいエントリを追加します。
memory(action="add", target="memory",
       content="User runs macOS 14 Sonoma, uses Homebrew, has Docker Desktop installed.")
replace — サブストリングマッチングを使用して既存のエントリを置き換えます。
memory(action="replace", target="memory",
       old_text="dark mode",
       content="User prefers light mode in VS Code, dark mode in terminal")
remove — サブストリングマッチングを使用してエントリを削除します。
memory(action="remove", target="memory",
       old_text="temporary project fact")
サブストリングマッチング
replace と remove は old_text 経由の短いユニークなサブストリングを使用します。完全なエントリテキストは必要ありません。これにより、正確な内容を知る必要なく、外科的な編集が可能になります。
サブストリングが複数のエントリにマッチする場合は、より具体的なマッチを要求するエラーが返されます。その後、エージェントはクエリを洗練させます。
ターゲットストア:memory versus user
target パラメータがどのファイルが更新されるかを決定します。
memory— エージェントの個人ノート。環境事実、プロジェクト規約、ツールのクセ、学んだ教訓。user— ユーザープロファイル。アイデンティティ、役割、タイムゾーン、コミュニケーション好み、嫌いなこと、ワークフロー習慣。
容量管理
メモリが 80% 以上満たされている場合、エージェントは統合します。関連するエントリを統合し、古い事実を削除し、情報を圧縮します。
良いメモリエントリはコンパクトで情報密度が高いです:
User runs macOS 14 Sonoma, uses Homebrew, has Docker Desktop installed. Shell: zsh with oh-my-zsh. Editor: Neovim with Telescope plugin.
悪いメモリエントリは曖昧または冗長です:
User has a project.
On January 5th, 2026, the user asked me to look at their project which is located at ~/code/gateway and it uses Go with gRPC and PostgreSQL for the database layer.
最初のは密で有用です。2 つ目のは、曖昧すぎるか、冗長すぎます。
セッション検索 versus 永続メモリ
session_search と永続メモリは異なる目的を提供します。
| 機能 | 永続メモリ | セッション検索 |
|---|---|---|
| 容量 | 合計約 1,300 トークン | 無制限(すべてのセッション) |
| 速度 | 即座(システムプロンプト内) | 検索 + LLM 要約が必要 |
| 使用例 | 常に利用可能な重要な事実 | 特定の過去の会話を見つける |
| 管理 | エージェントによって手動キュレーション | 自動——すべてのセッションが保存される |
| トークンコスト | セッションあたり固定(約 1,300 トークン) | オンデマンド(必要時に検索) |
指針:常にコンテキスト内にあるべき重要な事実にメモリを使用します。履歴検索にはセッション検索を使用します。
Part 6: 哲学
なぜ制限付きメモリが無制限メモリに勝つのか
直感は、メモリをできるだけ大きくすることです。すべてを保存し、必要なものを取り出すこと。
制限付きメモリの方が良く機能します。その理由を示します。
キュレーションが品質を強制する。 限られたスペースがある場合、あなたは重要なことのみを保存します。圧縮し、統合し、優先順位付けします。無制限メモリはすべてを突っ込み、決して片付けないことを助長します。
速度は重要です。 システムプロンプト内の 1,300 トークンは速いです。データベースから取得される 100,000 トークンは遅いです。メモリはクエリではなく、即座であるべきです。
ノイズはパフォーマンスを劣化させる。 より多くのメモリはより良いメモリではありません。それはよりノイズの多いメモリです。モデルはシグナルとノイズを区別しなければならず、それは注意を必要とします——実際のタスクに費やすべき注意を。
忘却は機能である。 人間のメモリは忘れます。それはバグではなく——それが私たちの優先順位付けの方法です。エージェントも忘れてべきです。すべてが記憶される価値があるわけではありません。
「忘却」問題
エージェントは学習を取り除く必要があります。単に忘れるだけでなく、能動的に古い情報を削除すること。
Hermes Agent はそれをどう処理するのかを示します:
removeアクション: もう関連のないエントリを削除します。replaceアクション: 新しい情報でエントリを更新します。- 容量圧力: メモリが満杯になると、エージェントは統合し、古いエントリを削除します。
- セキュリティスキャン: 悪意あるまたは破損したエントリをブロックします。
忘却は失敗ではなく——それは保守です。学習を取り除くことのできないエージェントは、最終的にシグナルと同じだけのノイズを運びます。
メモリスケーリング
Databricks は「メモリスケーリング」の概念を導入しました:何千人ものユーザーを有するエージェントは、単一のユーザーを有するものよりも良く機能するのか?
彼らの研究は、そうであると示唆しますが、いくつかの留保事項を伴います。メモリスケーリングには以下が必要です:
- 品質のある抽出: すべてのやり取りが記憶する価値があるわけではありません。エージェントはログではなく、インサイトを抽出しなければなりません。
- 効果的な検索: 取得されたメモリは関連していなければなりません。ノイズはパフォーマンスを劣化させます。
- 汎化: メモリは特定の話ではなく、パターンであるべきです。「ユーザーは Python を好む」はスケーリングされます。「ユーザーはタイムスタンプ Y にコマンド X を実行した」はスケーリングされません。
Hermes Agent の制限付きメモリは、自然にメモリスケーリングをサポートします。キュレーションを強制することで、メモリが汎化可能で、コンパクトで、有用であることを保証します。
これが未来に何を意味するか
メモリは、エージェント AI における競争上の堀(モート)になりつつあります——モデル自体ではなく、モデルがセッション間に運ぶものです。同一の基盤モデルを有する 2 つのエージェントは、非常に異なるパフォーマンスを示し得ます:一方はあなたの好み、あなたの環境、あなたの過去のミスを記憶し;もう一方は毎回コールドスタートします。
質問はもう、エージェントが永続メモリを持つべきかどうかではありません。それは決着しています:持つべきです。開かれた質問は、そのメモリをどう設計するかです——何を保持し、何を破棄し、それを即座にどうするか、そしてそれがノイズになるのをどう防ぐか。
Hermes Agent の答えは、メモリを小さく、キュレーションされ、常にアクティブに保つことです——クエリするデータベースではなく、エージェントがすべての会話に持ち込むユーザーのワークモデルです。
結論
Hermes Agent のメモリシステムは意図的にシンプルです:2 つのファイル、確固たる文字数制限、検索パイプラインなし、ベクトルデータベースなし、クエリごとの遅延なし。制約のように聞こえることが、全体の要点です。
それは、データベースがするようにではなく、脳がするようにメモリを扱うためです——小さく、キュレーションされ、常にアクティブ。エージェントは必要時にメモリを検索するのではなく、メモリは単に常に那里にあり、すべてのセッションの最初のトークンからシステムプロンプトに織り込まれています。
外部メモリプロバイダーは、より多くのものを必要とするユーザーのためにこのシステムを拡張します:ナレッジグラフ、マルチエージェントサポート、セルフホストストレージ、エンタープライズ機能。しかし、コアは同じままです:制限付き、キュレーションされ、常に利用可能。
そして外部ナレッジベース——LLM Wiki、Obsidian、Notion、ArXiv——は異なる役割を果たします。それらは図書館であり、脳ではありません。エージェントはそれらを参照しますが、記憶しません。重要なインサイトは内部メモリに蒸留され;残りは図書館に残ります。
これが AI エージェントがあなたを記憶する方法です。すべてを保存するのではなく、重要なことを記憶することで。
Hermes Agent は 2026 年 2 月に Nous Research によってリリースされ、2026 年 4 月までに(v0.9.0)64,000 以上の GitHub スター数を達成し、242 人以上の貢献者を持ちます。それはオープンソースであり、github.com/NousResearch/hermes-agentで利用可能です。インストール、設定、ワークフローガイドについては、Hermes Agent の概要を参照してください。
