
Memoria auto-ospitata con LLM locali per Hermes Agent
Memoria persistente di Hermes sul proprio hardware.
Un agente AI self-hosted ha bisogno di più di una lunga finestra di contesto. Ha bisogno di un modo per trattenere fatti utili, recuperare decisioni precedenti e rivedere ciò che ritiene di sapere man mano che i progetti evolvono.
Hermes Agent viene fornito con file di memoria integrati, ma un provider esterno può fornire un recupero molto più ricco tra le sessioni. Hindsight è una delle opzioni più interessanti in questo ambito. Questa guida lo installa per Hermes senza inferenza nel cloud, inizialmente come un contenitore Docker tutto-in-uno e poi contro un server PostgreSQL esistente con endpoint di modelli locali separati.
La guida copre la distribuzione, la scelta e il collegamento di modelli locali per embedding, reranking e generazione, il controllo di ciò che auto-retain scrive nella banca dati, il collegamento di Hermes e lo strato operativo: backup, spostamento di una banca dati incorporata sul proprio server PostgreSQL e manutenzione ordinaria della banca dati. Gli esempi utilizzano uno schema di porte deliberato — 8080 per il server principale llama.cpp, 8081 per gli embedding, 8082 per il reranking, 11434 per Ollama — quindi modificali in base alle porte che già utilizzi e tieni i piccoli server separati dalla porta del modello principale.
Cosa fa Hindsight
Hindsight è un motore di memoria persistente per agenti con tre operazioni principali: retain (memorizza), recall (ricorda) e reflect (riflette). Retain estrae e memorizza informazioni; recall combina il recupero semantico, per parole chiave, per grafo e temporale; reflect sintetizza una risposta dalla memoria accumulata. La consolidazione in background può trasformare osservazioni sovrapposte in un livello di conoscenza più utile.
Non è solo un database di embedding. Un vettore store può localizzare passaggi simili, ma un sistema di memoria deve anche preservare la cronologia, i confini del progetto, le prove contraddittorie e i cambiamenti nelle decisioni. Queste modalità di fallimento sono esplorate in loop di memoria auto-rinforzanti.
Per il mercato più ampio, consulta confronto dei provider di memoria per agenti. La memoria integrata di Hermes, MEMORY.md, USER.md e le modalità di memoria sono coperte nella guida sul sistema di memoria di Hermes Agent, quindi questo articolo presuppone che tu sappia come funziona lo strato integrato.
Perché andare oltre Mnemosyne
Mnemosyne per Hermes offre idee accattivanti locali-first, inclusa l’archiviazione SQLite e il recupero ibrido. Nella pratica, i vincoli di installazione, la compatibilità delle versioni, il comportamento di approvazione della scrittura e i rapidi cambiamenti intorno ai pre-release 4.0 possono renderlo difficile da gestire in modo prevedibile. Queste sono preoccupazioni operative, non prove che il modello di memoria di Mnemosyne sia fondamentalmente difettoso.
Hindsight non è nemmeno privo di dipendenze: la sua immagine Docker e i modelli locali possono consumare molto spazio su disco. L’esecuzione della sua API come servizio indipendente, con l’inferenza altrove, mantiene aggiornamenti e risoluzione dei problemi isolati dall’agente stesso.
Scegliere una distribuzione
| Componente | A: Contenitore tutto-in-uno | B: Server PostgreSQL esistente |
|---|---|---|
| API e UI di Hindsight | Contenitore Docker | Contenitore Docker |
| PostgreSQL | pg0 incorporato nel contenitore |
Macchina PostgreSQL esistente |
| LLM generativo | llama.cpp esterno | llama.cpp esterno |
| Embedding | Locale predefinito o esterno | Ollama esterno o llama.cpp |
| Reranking | Locale predefinito o esterno | Server di reranking esterno |
| Ideale per | Valutazione rapida | Installazione a lungo termine, isolata |
Qui, “tutto-in-uno” significa che l’API di Hindsight, l’UI e il database sono in un unico contenitore; l’LLM di inferenza viene ancora ospitato altrove. Questo è intenzionale: l’immagine ufficiale Hindsight di Docker non include un server llama.cpp generativo locale pronto all’uso.
Utilizza indirizzi raggiungibili dalla LAN, non localhost, per i servizi in esecuzione su un host diverso. Restringi queste porte a client fidati; le chiavi dummy di esempio sono placeholder di compatibilità, non autenticazione.
Opzione A: Contenitore Hindsight Tutto-in-Uno
Questo è il modo più semplice per valutare Hindsight senza riempire la VM di Hermes con Python, Torch e dipendenze di modelli locali. Il contenitore esegue Hindsight e PostgreSQL incorporato, mentre il tuo LLM llama.cpp principale gestisce l’estrazione e la riflessione della memoria.
Due tag di immagine sono importanti qui. ghcr.io/vectorize-io/hindsight:latest è l’immagine grande — circa 9 GB su AMD64 — perché include un embedder BGE, un reranker MiniLM e PostgreSQL incorporato. latest-slim è circa 500 MB e prevede che quei due modelli esistano altrove, il che è ciò che vuoi una volta che punti Hindsight alla configurazione di embedding e reranking in Serve e collega i modelli locali. Una volta superato il controllo di salute, fissa un tag specifico: un tag in movimento è una scarsa corrispondenza per un database che intendi mantenere.
Crea una directory e un file Compose sull’host di Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API Memoria
      - "9999:9999"  # UI Control-plane
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Sostituisci WORKSTATION_IP con l’host che esegue llama.cpp. Su Linux, host.docker.internal viene risolto solo se il contenitore dichiara la mappatura host-gateway mostrata sopra; senza di essa, una base URL di http://host.docker.internal:8080/v1 non punta da nessuna parte. La prenotazione di memoria condivisa da 1 GB è particolarmente utile per l’indicizzazione di PostgreSQL incorporato; il piccolo /dev/shm predefinito di Docker può causare fallimenti. Un volume nominato preserva il database quando il contenitore viene ricreato, e un’alternativa a bind mount deve essere di proprietà dell’uid 1000, l’utente all’interno dell’immagine.
HINDSIGHT_API_WORKER_ID dovrebbe rimanere stabile tra le ricreazioni — il valore predefinito di Docker è il nome host del contenitore, e un compito che era in corso quando un contenitore è morto rimane bloccato sotto il vecchio id worker.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Se la tua versione installata di Hindsight espone la salute a un percorso diverso, ispeziona http://localhost:8888/docs e i log del contenitore. Il control plane è normalmente disponibile a http://HINDSIGHT_HOST:9999. Una volta che la distribuzione di base funziona, puoi anche puntare i suoi provider di embedding e reranking alla configurazione in Serve e collega i modelli locali invece di caricare i modelli predefiniti all’interno del contenitore.
Non esporre direttamente le porte 8888 o 9999 a Internet. Utilizza una rete privata o un reverse proxy autenticato. PostgreSQL incorporato è comodo per i test, ma un database gestito esternamente è più facile da backup e mantenere. Una banca dati che esiste già in questo volume si sposta con il dump e restore in Sposta il database incorporato su un server dedicato.
Opzione B: Hindsight contro un Server PostgreSQL Esistente
Per un’installazione a lungo termine, preferisco mantenere l’API di Hindsight, il database e gli endpoint di inferenza separati. La VM di Hindsight può rimanere piccola perché esegue orchestrazione e servizi HTTP piuttosto che modelli pesanti. I passaggi seguenti partono contro un server vuoto. Una banca dati che esiste già nel volume dell’Opzione A viene spostata in Sposta il database incorporato su un server dedicato.
Prepara PostgreSQL e pgvector
Hindsight richiede PostgreSQL 14 o successivo e un’estensione vettore nel database hindsight. L’estensione è per database: l’installazione del pacchetto sul server non fa nulla finché CREATE EXTENSION non viene eseguita lì. Su un server PostgreSQL Debian o Ubuntu, installa il pacchetto pgvector corrispondente alla versione maggiore effettiva di PostgreSQL; ad esempio, su PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Il nome del pacchetto e la disponibilità dipendono dai tuoi repository apt configurati. Se non è disponibile, segui le istruzioni per l’installazione di pgvector, oppure installa un pacchetto compatibile dal repository PostgreSQL PGDG. Non cambiare acriticamente la versione maggiore di PostgreSQL su un server condiviso. I pacchetti PostgreSQL 18 PGDG includono pg_trgm e btree_gin dentro postgresql-18. Nei pacchetti della distribuzione sono in postgresql-contrib per quella versione maggiore. Il database incorporato usa entrambi, più vector.
Crea un ruolo e un database dedicati come amministratore PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
Connettiti al nuovo database e abilita le estensioni:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
Queste estensioni normalmente richiedono privilegi elevati per l’installazione; il ruolo dell’applicazione non deve essere un superuser. Hindsight usa pgvector in modo predefinito e vuole 0.8.0 o successivo per le scansioni ANN iterative; i server più vecchi rifiutano quella impostazione. HINDSIGHT_API_VECTOR_EXTENSION può in alternativa selezionare pgvectorscale (un’opzione DiskANN che Hindsight documenta per banche dati molto grandi) o vchord, entrambi dei quali necessitano di packaging extra su questa build esatta di PostgreSQL. Il passaggio di algoritmo dopo che esistono memorie arresta l’avvio e richiede una migrazione, quindi scegli prima del primo retain. Per una banca dati personale di Hermes, pgvector è l’unica da installare e poi fermarsi.
Consenti solo l’host di Hindsight tramite pg_hba.conf, ad esempio:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Imposta listen_addresses di PostgreSQL in modo appropriato e usa TLS o una rete privata fidata per le connessioni tra host. Esegui il backup di questo database indipendentemente dal contenitore Docker di Hindsight. Se il server è condiviso con altre applicazioni, tieni Hindsight nel suo proprio database, oppure imposta HINDSIGHT_API_DATABASE_SCHEMA su uno schema di tua proprietà; lo schema predefinito è public.
Esegui Hindsight contro PostgreSQL
Crea compose.yaml sulla VM di Hindsight. Questa versione deliberatamente non avvia PostgreSQL localmente:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Conserva l’URL del database esterno in un file chiamato .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Se la tua password contiene @, :, / o altri caratteri riservati URL, codificala in URL prima di inserirla nella stringa di connessione. Testa che la VM di Hindsight possa raggiungere la porta 5432 di PostgreSQL, e che pg_hba.conf consenta l’host di Hindsight — un server legato solo a 127.0.0.1 rifiuta la connessione anche quando l’URL sembra giusto. Consenti al primo avvio di eseguire le migrazioni del database; le migrazioni vengono eseguite all’avvio a meno che non imposti HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Con API e database avviati, continua con Scegli i Modelli per Hindsight e Serve e Collega i Modelli Locali prima di collegare Hermes.
Scegliere i Modelli per Hindsight
Deploy mette API e database sulla rete. La decisione successiva è quali modelli riempiono i tre ruoli di inferenza: embedding per i candidati recall, un reranker per riordinarli e un LLM generativo per retain, reflect e consolidazione. Un predefinito pratico per un host Hindsight CPU la cui GPU è già occupata dalla conversazione è Qwen/Qwen3-Embedding-0.6B in-process, BAAI/bge-reranker-v2-m3 in-process e un modello chat llama.cpp condiviso per il lavoro generativo.
Modelli di embedding
Hindsight legge la dimensione di embedding all’avvio e dimensiona la banca dati per corrispondere, quindi il modello che scegli al primo retain è il modello che la banca dati mantiene finché non la ricostruisci. La dimensionalità e il comportamento delle istruzioni contano più del ranking in classifica: un embedder 8B più forte non vale la pena di una migrazione se la banca dati è già una a 384 o 1024 dimensioni. Le righe sottostanti sono ordinate dalla più leggera alla più pesante; le figure di RAM sono il footprint caricato approssimativo su CPU (FP16 / caricamento locale tipico), non la dimensione del file GGUF.
| Modello | Parametri | Dim | Contesto | Caricato | Esegue su | Note |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Predefinito Hindsight; incluso in hindsight:latest. Percorso locale più veloce. La distribuzione dei punteggi calibra ancora molti predefiniti recall_min_scores dopo che lo hai lasciato. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | BGE inglese di fascia media; blocca una banca dati a 768 dimensioni. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | MiniLM multilingue documentato da Hindsight; 50+ lingue con la stessa larghezza di banca dati a 384 dimensioni di BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Predefinito per il provider onnx; percorso multilingue CPU leggero quando hai un export ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Embedder Ollama comune; contesto più lungo rispetto al classico BGE, ancora focalizzato sull’inglese. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 solo testo (disabilita le torri visione/audio). 100+ lingue + codice; MRL tronca a 512/256/128; prefissi di istruzione per ricerca vs documento. Il caricamento multimodale completo è 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU o GPU | Dual-encoder multilingue forte; stessa larghezza di Qwen3-0.6B, quindi uno scambio con le stesse dimensioni richiede comunque un re-embed completo. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | Il predefinito di questa guida. Consapevole delle istruzioni (istruzione di ricerca sul lato query); comodo su CPU. Il provider locale applica automaticamente l’istruzione; i server compatibili OpenAI necessitano di HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Fascia di qualità Qwen3; blocca una banca dati a 2560 dimensioni. Non fattibile quando la GPU conversazionale è già saturata. |
Come viene eseguito il modello è l’altra metà della scelta. I provider di embedding di Hindsight, dal più semplice al più complesso:
| Provider | Come viene eseguito | Ideale quando | Note |
|---|---|---|---|
local |
SentenceTransformers in-process; nessun sidecar | Single Hindsight host, embedder CPU | Percorso predefinito. Imposta HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Nessun llama.cpp, Ollama o TEI. |
onnx |
ONNX Runtime in-process | CPU più leggera di Torch; hai già un export ONNX | Necessita di hindsight-api-slim[local-onnx] e HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Endpoint OpenAI-compatible esterno o HF TEI | Embedding fuori dal processo API; host GPU/CPU condiviso | Ciò che Serve e Collega i Modelli Locali configura per Ollama / llama.cpp / TEI. Vale solo per il sidecar se vuoi isolamento o una macchina diversa. |
Qwen3-Embedding-0.6B non ha bisogno di un servizio di embedding esterno. Su un host Hindsight CPU viene caricato dentro il processo API con il provider local — Hugging Face scarica i pesi al primo avvio, e il provider applica l’istruzione di ricerca del modello stesso:
# Ambiente Compose (o chiavi .env equivalenti)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Usa un endpoint esterno compatibile OpenAI solo quando vuoi l’embedder su un’altra macchina o fuori dal processo API. Ollama è uno di tali host:
# Embedding: Qwen3-Embedding-0.6B su Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Sostituisci host, porta e tag con ciò che mostra ollama list sulla tua macchina di inferenza.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX dipende dal provider:
| Percorso | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Lascia non impostato / vuoto — il provider in-process applica l’istruzione di ricerca di Qwen stesso | Lascia non impostato / vuoto |
| Ollama esterno / llama.cpp / compatibile OpenAI | Istruzione di retrieval Qwen3 ufficiale (nuova riga reale prima di Query:) |
Lascia vuoto — le memorie archiviate restano testo grezzo |
| Il server avvolge già gli input nel template di Qwen | Lascia entrambi vuoti — altrimenti l’istruzione viene applicata due volte | Lascia vuoto |
Per il percorso esterno, imposta:
# Nuova riga reale prima di Query:. Bash $'...' è il modo affidabile per passarla.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
In Compose YAML la stessa stringa necessita di un \n esplicito (o un valore multilinea letterale). Imposta i prefissi prima del primo retain: cambiarli in seguito significa che i vecchi vettori e le nuove query non stanno più nello stesso spazio.
Due proprietà decidono più della posizione in classifica. Sensibilità alle istruzioni: gli embedding Qwen3 applicano un’istruzione di ricerca sul lato query; senza il prefisso corrispondente su un server compatibile OpenAI, il lato archiviato e il lato query smettono di stare nello stesso spazio. Blocco delle dimensioni: perché la larghezza viene letta una volta all’avvio, passare da 0.6B a 4B in seguito è una migrazione della banca dati, non un cambiamento di configurazione — e anche uno scambio con le stesse dimensioni (BGE-M3 ↔ Qwen3-0.6B, o EmbeddingGemma 2 ↔ nomic a 768) cambia lo spazio vettoriale, quindi i vettori della banca dati non vengono ricomputati automaticamente. Pianifica una banca dati fresca o un re-embed/reindex manuale; consulta Esporta, importa e migrare la banca dati della memoria. Dopo aver lasciato BGE-small, esplora recall_min_scores contro la nuova distribuzione dei punteggi — le soglie calibrate su BGE-small possono essere troppo strette per Qwen3-0.6B e affamare il reranker di candidati. Per benchmark e sfondo GGUF/Ollama sulla famiglia Qwen3, consulta Modelli Qwen3 Embedding e Reranker su Ollama.
Modelli di reranking
Gli embedding richiamano un set di candidati; il reranker punteggi ogni coppia query/passage e la riordina prima che Hindsight la inietti. Con il provider local, Hindsight carica un cross-encoder SentenceTransformers (o un reranker generativo dove supportato). Con un endpoint esterno compatibile Cohere, pubblica il corpo completo in stile Cohere a HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Il reranker è facoltativo, ma una volta fissato l’embedder è solitamente la leva più grande per la qualità del recall — e, su CPU, spesso la maggior parte del tempo di recalls. Le righe sono ordinate dalla più leggera alla più pesante.
| Modello | Parametri | Tipo | Contesto | Esegue su | Note |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | Predefinito Hindsight; incluso in hindsight:latest. Sub-second per ~20 candidati. Tieni come fallback nominato se un modello BGE più pesante è troppo lento. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | Stessa famiglia, accuratezza più alta; ancora incentrato su MS MARCO inglese. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Reranker MiniLM multilingue documentato da Hindsight. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Upgrade moderato rispetto a MiniLM; en/zh. Discusso spesso; saltato quando v2-m3 si adatta già al budget di latenza. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU o GPU | Predefinito multilingue pratico su CPU. Su una banca dati di ~500 memorie, ~2.6–2.8 s per recall a un limite di 20 candidati (~140 ms/candidato; ~93–99% del tempo di recall). Limiti candidati 20/40/80; abbassare il limite da 20 → 10 dimezza approssimativamente il costo del rerank. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Generativo (token sì) | 32k | GPU preferita | Consapevole delle istruzioni, contesto lungo. Non è un cross-encoder plug-and-play: necessita del supporto generative-reranker di SentenceTransformers recenti, e il scoring /rerank di llama.cpp ha bug noti di punteggio errato (hindsight-benchmarks#11). Valida prima dell’adozione. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-encoder | 8k | GPU preferita | Qualità multilingue forte; eccessivo per una banca dati personale di poche centinaia di memorie quando la GPU è già piena. |
Qwen/Qwen3-Reranker-4B |
4B | Generativo | 32k | GPU | Candidato Qwen di qualità superiore; non fattibile senza VRAM dedicata. |
Qwen/Qwen3-Reranker-8B |
8B | Generativo | 32k | GPU | Fascia superiore della famiglia; stesse avvertenze di scoring generativo, più grande ancora. |
I reranker delle API cloud (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe, e simili) funzionano in Hindsight ma inviano il testo della memoria fuori dalla scatola. Per un layout locale-only cross-domain sono fuori portata.
Due vincoli operativi dominano la scelta. VRAM: se il modello conversazionale satura già la GPU (ad esempio un Qwen3.8-27B Q5 su una scheda da 16 GB senza margine), ogni riga “GPU preferita” è fuori discussione e la scelta live si riduce a MiniLM o BGE-v2-m3 su CPU. Numero di candidati: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 nell’esempio di endpoint esterno sotto) limita quante passate il modello ri-puntesca; ogni candidato è un forward pass completo, quindi taglia il limite prima di saltare una fascia di modello. Per Qwen3 tramite llama.cpp, il GGUF deve mantenere la testa di ranking — un vecchio convert_hf_to_gguf.py che la elimina punteggia ogni passata vicino allo zero — e anche una conversione corretta necessita di un test di passata nota-buona/nota-cattiva finché il percorso di scoring generativo non è confermato.
Fasce di LLM generativo
I modelli di embedding e reranking non sono sostituti per l’LLM generativo usato per estrarre e ragionare sulle memorie. Hindsight supporta un LLM predefinito e override specifici per operazione, che possono puntare allo stesso server llama.cpp o a endpoint indipendenti.
| Operazione Hindsight | Scopo | Fascia di modello pratica | Esempi Qwen |
|---|---|---|---|
| Retain | Estrae fatti, entità, decisioni e cronologia | Minimo 4B per test; 9B preferito | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Recupero semantico, parole chiave, grafo e temporale | Nessun LLM generativo richiesto | Qwen3-Embedding-0.6B + reranker |
| Reflect | Risponde a domande sintetizzando le memorie recuperate | Da 9B a 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidazione | Riconcilia e comprime i fatti correlati | 9B preferito | Qwen3.5-9B / Qwen3.8-27B |
| Aggiornamento del modello mentale | Aggiorna la comprensione sintetica a vita più lunga | Da 9B a 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Queste sono raccomandazioni operative, non conteggi di parametri minimi ufficiali di Hindsight. Un modello piccolo può estrarre correttamente un numero di porta ma perdere che una precedente decisione architettonica sia stata superata. L’affidabilità dell’output strutturato e la gestione fedele della negazione contano più del solo conteggio nominale dei parametri. I predefiniti di temperatura di Hindsight stessi vale la pena lasciarli intatti — 0.1 per retain, 0.0 per consolidazione, 0.9 per reflect — e per retain e consolidazione, l’alias non-thinking vale la pena servirlo se la tua build llama.cpp ne ha uno, perché i checkpoint piccoli di Qwen3.5 spendono molti token in modalità thinking.
Per una distribuzione con un endpoint llama.cpp esistente Qwen3.8-27B, inizia condividendolo tra i task generativi di Hindsight con bassa concorrenza:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
In seguito, instrada l’estrazione routine a un modello 9B indipendente e riserva il 27B per la riflessione difficile:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Il modello 4B più piccolo è economico ma necessita di test; 9B è un compromesso sensato qualità/prestazioni. Se retain e consolidazione condividono un modello piccolo, abbassa HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE a 2 — il batch predefinito di 8 è un prompt lungo per una piccola finestra di contesto. Qwen3.6-35B-A3B è allettante per un server di inferenza ben provisionato separato (è un modello mixture-of-experts con circa 3 miliardi di parametri attivi, quindi budgetalo come un modello attivo piccolo), mentre un modello denso 27B è solitamente non necessario per ogni evento routine di retain. Limitare la concorrenza in background protegge il modello conversazionale di Hermes dalle esplosioni di manutenzione della memoria.
Serve e Collega i Modelli Locali
Se le impostazioni in-process local di embedding e reranker in Scegli i Modelli sono sufficienti, puoi saltare le sottosezioni esterne Ollama e llama.cpp e saltare al collegamento — o lasciare Compose sui predefiniti local mostrati lì. Gli endpoint esterni contano quando l’embedder o il reranker dovrebbero vivere su un altro host.
Embedding esterni: Ollama o llama.cpp
Gli embedding esterni sono per quando vuoi Qwen3-Embedding-0.6B (o un altro modello) su un host separato. Due opzioni pratiche sono Ollama, che gestisce l’acquisizione e il serving del modello con poca configurazione, e llama.cpp, che dà controllo preciso sulla quantizzazione GGUF, thread CPU, collocazione del dispositivo e batching. Lo sfondo dei modelli e i benchmark per entrambi i modelli Qwen3 sono in Modelli Qwen3 Embedding e Reranker su Ollama.
Qwen3-Embedding-0.6B restituisce vettori a 1024 dimensioni, e Hindsight legge quella larghezza all’avvio e dimensiona il database per corrispondere. Una banca dati creata con il modello BGE incorporato a 384 dimensioni non può accettare questo modello — inizia da un database o volume vuoto, e decidi il modello di embedding prima del primo retain. Un cambio di provider di embedding in seguito richiede il re-embedding dei record archiviati anche se entrambi i modelli usano la stessa dimensionalità.
Opzione 1: Ollama per Qwen3-Embedding-0.6B
Installa Ollama sull’host di inferenza usando la sua documentazione ufficiale per l’installazione Linux, poi avvia il modello di embedding:
ollama pull qwen3-embedding:0.6b
ollama serve
Per l’accesso remoto, configura OLLAMA_HOST=0.0.0.0:11434 di Ollama nel suo ambiente di servizio, riavvia il servizio e proteggilo con firewall alla VM di Hindsight — la procedura è coperta in Accesso remoto a Ollama. Un daemon legato solo a 127.0.0.1 è invisibile al contenitore di Hindsight. Prima controlla il nome del modello con ollama list, e testa l’endpoint standard di embedding:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Il provider di embedding OpenAI di Hindsight chiama invece l’endpoint /v1/embeddings compatibile OpenAI di Ollama. Verifica che quell’endpoint funzioni con la tua versione di Ollama prima di configurare Hindsight. Ollama è semplice per gli embedding; non dare per scontato che la sua API offra un endpoint di reranking compatibile. Per il reranking, preferisci il percorso BGE local in-process sotto, o un endpoint separato llama.cpp / TEI dopo aver validato i punteggi.
Opzione 2: llama.cpp per Qwen3-Embedding-0.6B
Scarica una conversione Qwen3-Embedding-0.6B GGUF verificata. Usa il nome del file GGUF che hai effettivamente scaricato:
#!/bin/sh
# start-embedding.sh - server di embedding solo CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Gli embedding Qwen3 usano last-token pooling, a differenza del pooling CLS usato da alcuni modelli BGE. Una build llama.cpp solo CPU è preferibile se vuoi assolutamente nessuna inizializzazione CUDA su una workstation la cui GPU è occupata da un grande modello conversazionale. Non abilitare --reranking su questo server di embedding: quella combinazione è un modo noto per ottenere un vettore di zeri.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Un’output completa di dimensioni di Qwen3-Embedding-0.6B dovrebbe contenere 1024 float. Verifica che la conversione GGUF e la tua gestione delle istruzioni query/document di Hindsight siano compatibili; i modelli di embedding sensibili alle istruzioni possono perdere accuratezza se sollecitati in modo errato.
Reranker: BGE locale o Qwen3 tramite llama.cpp
Il reranking è diverso dagli embedding: il modello punteggi ogni coppia documento/query e restituisce un punteggio di rilevanza. Su un host Hindsight solo CPU — o ogni volta che la GPU conversazionale non ha margine VRAM — il percorso pratico è il provider local di Hindsight con BAAI/bge-reranker-v2-m3 (o il predefinito MiniLM più leggero). Nessun sidecar è richiesto:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B è uno scorer generativo token-sì, non un cross-encoder classico. Può essere servito tramite llama.cpp con una conversione GGUF progettata per il ranking, ma trattare quel percorso come sperimentale finché non confermi i punteggi su una coppia nota-buona/nota-cattiva: un vecchio convert_hf_to_gguf.py che elimina la testa di ranking punteggia ogni passata vicino allo zero, e il percorso nativo /rerank di llama.cpp ha segnalazioni note di punteggi errati per questa famiglia.
#!/bin/sh
# start-reranker.sh - GPU o CPU come selezionato da --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Imposta --n-gpu-layers 0 per eseguirlo su CPU. La versione GPU necessita di VRAM aggiuntiva per i buffer di calcolo e il contesto, non solo per i pesi del modello; evita di dare per scontato che la dimensione del file sia l’allocazione totale della GPU.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Il documento PostgreSQL dovrebbe posizionarsi sopra il documento non correlato; i punteggi di rilevanza tutti a zero significano che il GGUF è la conversione sbagliata, e il recall sembrerà casuale anche quando i fatti sono archiviati. Controlla la forma esatta di results[].index e results[].relevance_score: Hindsight si aspetta una risposta di rerank compatibile Cohere, e la compatibilità di llama.cpp può variare tra le build.
Collega gli endpoint a Hindsight
Aggiungi le seguenti impostazioni di ambiente al servizio Compose di Hindsight, o conservalo nel suo file .env. Scegli un percorso di embedding — in-process local, Ollama o llama.cpp — mai due alla volta.
# Opzione A: Qwen3 in-process sull'host di Hindsight (CPU; nessun sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Opzione B: servizio di embedding llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opzione C: Ollama su un altro host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opzione: reranker BGE locale (nessun sidecar; preferito su CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Opzione: endpoint di rerank compatibile Cohere llama.cpp (valida prima i punteggi Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
I nomi delle variabili sono specifici del provider, e un errore quasi-silenzioso è silenzioso: HINDSIGHT_API_EMBEDDINGS_BASE_URL è la chiave sbagliata, e Hindsight punta silenziosamente verso l’endpoint di embedding di OpenAI stesso invece che verso il tuo server locale. Usa HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Con il percorso di reranker compatibile Cohere, Hindsight pubblica il corpo completo in stile Cohere a HINDSIGHT_API_RERANKER_COHERE_BASE_URL; se il log del contenitore mostra un 404 per /v1/rerank/rerank, la tua build aggiunge /rerank da sola e il valore dovrebbe fermarsi a /v1.
Per le Opzioni B e C, usa il valore di HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX da Modelli di embedding (l’Opzione A lo lascia non impostato). Testa il recupero da query a passaggio sulle tue memorie effettive dopo il primo retain.
Controllare Cosa Viene Ricordato
Con lo stack in esecuzione, la prossima modalità di fallimento è solitamente il percorso di scrittura: Hermes predefinisce auto_retain: true, quindi ogni turno di conversazione può essere estratto nella banca dati. Supposizioni errate, piani scartati e dichiarazioni esplorative diventano fatti ricercabili, e un recall successivo li tratta come prove — il loop descritto in loop di memoria auto-rinforzanti. La politica di acquisizione per Hindsight tra gli altri provider è riassunta in confronto dei provider di memoria per agenti.
Modalità di acquisizione che esistono oggi
Non esiste un’interruttore Hermes o Hindsight chiamato “sintesi di sessione”. Il plugin o auto-memorizza i turni di conversazione grezzi (opzionalmente batched) o aspetta una chiamata esplicita al tool hindsight_retain con qualsiasi content tu gli dia.
| Modalità | Impostazioni Hermes / Hindsight | Cosa ottieni |
|---|---|---|
| Continua | auto_retain: true, retain_every_n_turns: 1 |
Ogni turno viene memorizzato ed estratto come testo della trascrizione |
| Auto batched | auto_retain: true, aumenta retain_every_n_turns |
I turni si accumulano nel plugin; ogni N-esimo turno invia un payload di retain più grande di quei turni grezzi — ancora estrazione automatica, non un riassunto curato |
| Solo esplicito | auto_retain: false + tool hindsight_retain |
Nulla viene archiviato finché l’agente non chiama il tool con content (e opzionale context / tags) |
L’auto batched non è un riassunto di sessione. Con retain_every_n_turns > 1, il plugin Hindsight di Hermes accumula i turni in memoria e li memorizza come JSON di conversazione; su /new, /reset, /branch e simili cambi di sessione svuota qualsiasi buffer residuo sotto il vecchio documento di sessione. Non c’è un riassuntore dedicato a fine sessione, e lo smontaggio della sessione inattiva storicamente ha potuto far cadere un buffer non svuotato quando N > 1 (nessun hook on_session_end nel plugin). Preferisci N: 1 a meno che non accetti quel compromesso.
“Ricorda questa sessione” curato è un pattern di prompt + tool, non una flag di configurazione. Imposta auto_retain: false, poi chiedi a Hermes di riassumere le decisioni durevoli e di chiamare hindsight_retain con quel testo — o chiama il tool tu stesso tramite il percorso tool dell’agente. reflect e consolidazione della banca dati sono operazioni separate del server Hindsight che sintetizzano da ciò che è già nella banca dati; non sostituiscono una scrittura a fine sessione, e non sono abilitate da una chiave di config.json di Hermes.
Impostare auto_retain su false disabilita l’archiviazione automatica dei turni. Non aggiunge un dialogo di approvazione umana prima di ogni scrittura. L’agente può ancora chiamare hindsight_retain ogni volta che i suoi tool lo consentono; tratta il retain esplicito come acquisizione deliberata, non come coda in attesa.
Il vuoto della coda di approvazione
Un desiderio comune è una coda in attesa di memorie candidate che tu rivedi e approvi prima che entrino nella banca dati. Hindsight sotto Hermes non fornisce quel contratto oggi. Mnemosyne per Hermes implementa scritture staged specifiche del provider in alcune versioni; quel percorso non è uno standard condiviso di Hermes e non si applica al plugin Hindsight. Finché non esiste un flusso di approvazione upstream, il pattern fattibile è auto_retain: false, hindsight_retain deliberato, e ispezione o eliminazione nell’UI di control-plane di Hindsight prima che la sessione successiva si affidi a un fatto cattivo. Non c’è una chiave write_approval mancante da cercare per Hindsight in config.json.
Guida della banca dati (missioni, etichette, direttive, modelli mentali)
Le persone spesso chiamano il prossimo strato “finetuning”. In Hindsight è in gran parte configurazione della banca dati, non solo config.json di Hermes: le missioni e le impostazioni di estrazione guidano ciò che retain mantiene; le etichette strutturano le entità; le direttive e i modelli mentali modellano la sintesi successiva.
| Controllo | Dove si trova | Come aiuta |
|---|---|---|
Missione di retain (retain_mission / bank_retain_mission di Hermes) |
Config della banca dati | “Prendi nota di X, ignora Y” in linguaggio piano iniettato nell’estrazione |
Modalità di estrazione (concise, verbose, custom, …) |
Config della banca dati | concise (predefinito) mantiene fatti degni di lungo termine; custom sostituisce le regole integrate tramite retain_custom_instructions |
| Etichette di entità | Config della banca dati | Vocabolario controllato key:value al momento del retain → collegamenti del grafo e tag opzionali; migliora la struttura del recupero, non rifiuta di per sé affermazioni errate |
| Direttive (“regole rigide”) | API direttive della banca dati | Istruzioni esplicite applicate durante reflect (a livello di tag); vincolano la sintesi, non una gate di approvazione della scrittura |
| Modelli mentali | API modello mentale della banca dati | Risposte stabili a domande ricorrenti, aggiornate tramite reflect da memorie corrispondenti; derivati, quindi i fatti sorgente cattivi li avvelenano ancora |
| Missione di reflect / osservazioni | Config della banca dati | Guida la sintesi e la consolidazione, non il getto d’acqua grezzo di retain |
Le missioni, l’estrazione concisa e le etichette riducono il rumore e migliorano il recupero. Non sostituiscono il disattivare auto-retain quando l’accuratezza conta più della completezza. Preferisci una missione di retain breve che nomini decisioni di progetto durevoli e ignori la logistica della chat; aggiungi etichette di entità solo quando hai una tassonomia reale; aggiungi modelli mentali per due o tre domande ricorrenti dopo che la banca dati detiene già fatti puliti.
Profilo di igiene raccomandato
Un punto di partenza concreto per una banca dati personale di Hermes:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Sulla banca dati, imposta una missione di retain e lascia l’estrazione in modalità concise (tramite il control plane o l’API delle banche dati). Dopo un retain esplicito, apri l’UI, conferma l’osservazione ed elimina gli errori prima che venga eseguita la consolidazione o l’aggiornamento del modello mentale. Lascia recall_prefetch_method a recall — reflect spende una chiamata al modello chat prima di ogni turno e inietta la sintesi piuttosto che i fatti sottostanti.
Collegare Hermes Agent a Hindsight
Sulla VM di Hermes, installa il plugin del catalogo, poi esegui la configurazione guidata. Seleziona Hindsight e la modalità local_external; il plugin non deve avviare PostgreSQL incorporato o eseguire lo stack di modelli di Hindsight localmente, e local_embedded avvierebbe un secondo daemon di Hindsight accanto al contenitore che hai appena eseguito.
hermes plugins install hindsight
hermes memory setup hindsight
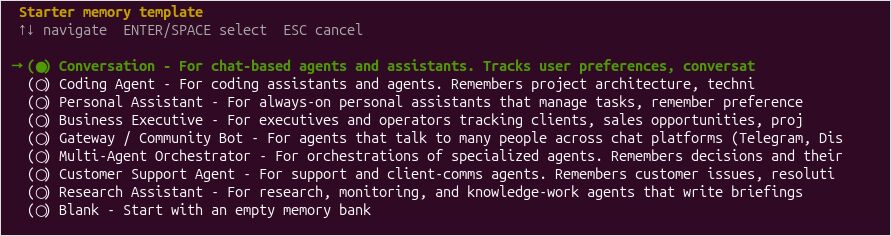
Ci sarà un’interessante serie di opzioni per il ruolo dell’agente che usa hindsight
hermes memory status
La connessione esterna di Hindsight vive in ~/.hermes/hindsight/config.json. Una configurazione illustrativa che mantiene l’acquisizione continua (predefiniti di Hermes) è:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Per il retain solo esplicito e la guida della banca dati, usa il profilo di igiene in Controlla Cosa Viene Ricordato invece di lasciare auto_retain attivo. recall_sync: false dà priorità alla reattività interattiva ma potrebbe iniettare il contesto ricordato nel turno successivo. Usa il recall sincrono quando la richiesta corrente deve incorporare le memorie più recenti prima che il modello inizi a rispondere. retain_async: true evita di bloccare le risposte ordinarie mentre le memorie vengono elaborate.
Il predefinito di recall del plugin è solo le osservazioni; i fatti grezzi di mondo ed esperienza restano nella banca dati e fuori dal prompt finché la consolidazione non ha scritto un’osservazione, o finché non allarghi recall_types a observation,world,experience. Allargarlo per la prima settimana e osservare il control plane, poi restringerlo, è un ordine ragionevole.
La memoria integrata di Hermes resta attiva accanto al provider; mantenere MEMORY.md e USER.md attivi mentre impari cosa aggiunge Hindsight va bene, e l’articolo sul sistema di memoria è il posto per decidere se i file piatti dovrebbero restare.
Riavvia il gateway se è già in esecuzione:
hermes gateway restart
hermes memory status
Lo stato dovrebbe identificare Hindsight come provider attivo. Per un riferimento di comandi più ampio, inclusa la TUI di Hermes e i comandi del plugin, consulta la scheda rapida CLI di Hermes Agent.
Valida la Memoria, Non Solo l’Installazione
Chiedi a Hermes di ricordare un fatto sacrificale su un progetto di test, avvia un’altra sessione e chiedi di nuovo quel fatto. La retention è asincrona in modo predefinito e l’estrazione aspetta il modello chat, quindi dai al server principale llama.cpp un momento prima di giudicare. Poi testa un caso più difficile: dì a Hermes che una decisione precedente è cambiata e chiedi quale decisione è attuale e perché. Controlla l’UI di Hindsight e le osservazioni archiviate piuttosto che dare per scontato che memory status dimostri che ingestione e recall sono corretti.
Se la risposta torna vuota, ispeziona il control plane prima di cambiare modelli. Un retain può riuscire e restare invisibile al recall mentre recall_types è solo osservazioni e la consolidazione non è stata eseguita — allargare recall_types è il primo controllo. Un rifiuto di connessione nel log del server di embedding significa che il contenitore non può raggiungere la porta di embedding, e i punteggi di reranker tutti a zero significano che il GGUF è la conversione sbagliata.
Le scelte del percorso di scrittura (auto_retain, missioni, vuoto di approvazione) sono coperte in Controlla Cosa Viene Ricordato.
Risoluzione dei Problemi e Note Operative
| Sintomo | Causa probabile | Primo controllo |
|---|---|---|
| Hermes dice provider non disponibile | URL local_external errato o regola di rete |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker avvia, errori PostgreSQL | Estensione mancante, credenziali errate o memoria condivisa insufficiente | Log del contenitore e pg_extension |
| Gli embedding restituiscono 401 o 404 | URL compatibile OpenAI errato, nome chiave env errato o alias modello non corrispondente | Test diretto /v1/embeddings e nomi delle variabili |
| Il reranking fallisce | Endpoint o formato di risposta non corrispondente, incluso percorso /rerank raddoppiato |
Test diretto /v1/rerank e log del contenitore |
| Il recall restituisce nulla di utilizzabile | recall_types limitato a osservazioni, o punteggi di reranker a zero |
Control plane, poi recall_types, poi conversione reranker |
| Una banca dati esistente riporta non corrispondenza di dimensioni | Modello di embedding cambiato | Ricostruisci vettori/reimporta con un modello coerente |
| Le risposte di Hermes rallentano | Recall sincrono o contenzione condivisa dell’LLM | Disattiva recall sync; limita la concorrenza di retain |
| Memorie irrilevanti si ripetono | Estrazione debole, recupero rumoroso o consolidazione insufficiente | Ispeziona osservazioni e punteggi di rilevanza |
| La connessione a PostgreSQL è rifiutata | listen_addresses è ancora localhost, o il client ha usato la porta dell’altro cluster |
ss -lntp sull’host del database; riavvia quel cluster dopo aver cambiato listen_addresses |
no pg_hba.conf entry per una connessione SSL |
Nessuna riga host o hostssl per l’indirizzo del client, o la riga non ha /32 ed è stata saltata |
Aggiungi la riga, ricarica e leggi il log di PostgreSQL |
pg_restore non può aprire il dump |
L’utente postgres non può entrare nella directory home che contiene il file |
Copia il dump in /tmp e ripristinalo da lì |
must be owner of extension btree_gin |
COMMENT ON EXTENSION è stato eseguito come ruolo dell’applicazione |
Ricrea il database vuoto e ripristina con --no-comments |
Pacchetti PostgreSQL 18 installati, pg_lsclusters mostra solo 14 |
Una nuova versione maggiore non crea un cluster se ne esiste già uno | sudo pg_createcluster 18 main |
Una distribuzione pratica piccola è 2-4 vCPU e 4-6 GB RAM per la VM di Hindsight API quando PostgreSQL e tutta l’inferenza sono esterni. L’allocazione del disco dipende ancora dall’immagine Docker scelta e dai layer di immagine ritenuti; alloca circa 30-40 GB inizialmente con spazio per espandere. Dimensiona l’host di PostgreSQL in base al volume di memoria effettivo, alle prestazioni di archiviazione e agli altri database che serve.
Backup e ripristino della banca dati Hindsight
La banca dati della memoria è l’unico stato che conta, e vive in PostgreSQL. Nell’Opzione B è un database che amministrì; nell’Opzione A è il volume nominato incorporato pg0 all’interno del contenitore. Fanne il backup indipendentemente dal contenitore di Hindsight — ricreare il contenitore senza prima catturare il volume o il database scarta la banca dati, e hermes backup non raggiunge una banca dati che gira in un servizio separato.
Opzione B — PostgreSQL esterno. Esegui il dump del database hindsight in formato custom, poi ripristinalo in un database scratch per verificare l’archivio prima di fidarti di esso:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# ripristina in un database scratch per dimostrare che il dump è utilizzabile
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
Conferma l’estensione pgvector e un campione di recall esistente nella copia ripristinata prima di eliminare l’obiettivo del dump originale. Mantieni il dump su un host diverso dalla VM di Hindsight, ed esegui questo come amministratore di PostgreSQL (un ruolo che può creare database) piuttosto che come ruolo dell’applicazione.
Opzione A — contenitore tutto-in-uno. Il database incorporato è un volume nominato, quindi ferma il contenitore e fai il tar del volume tramite un’immagine monouso:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Il punto di montaggio all’interno del contenitore tar (/data) è arbitrario; semplicemente alia il volume nominato in modo che tar possa leggerlo. Per ripristinare sullo stesso volume, ferma il contenitore, svuota il volume e disfa l’archivio di nuovo al suo interno. Spostare quella banca dati su un server che amministrì è il dump e restore in Sposta il database incorporato su un server dedicato.
Fai uno snapshot in tre momenti piuttosto che su una pianificazione calendario: prima di cambiare il modello di embedding, prima di un upgrade importante di Hindsight o PostgreSQL, e prima di un passaggio reflect o di consolidazione che riscrive la banca dati. Un backup che hai ripristinato in una banca dati scratch vale più di uno che hai solo scritto.
Sposta il Database Incorporato su un Server Dedicato
La banca dati tutto-in-uno è il volume nominato montato a /home/hindsight/.pg0. Impostare HINDSIGHT_API_DATABASE_URL fa sì che quel contenitore apra il database nominato nell’URL ed esegua le migrazioni. Il volume non cambia. Sposta le righe con pg_dump e pg_restore, poi mantieni lo stesso contenitore e puntalo verso il nuovo server.
La guida all’installazione descrive pg0 incorporato e un URL esterno come due modi per avviare un server vuoto. hindsight-admin backup e restore copiano tabelle tra database; restore tronca lo schema di destinazione e necessita che le tabelle esistano prima. Esporta, importa e migrare la banca dati della memoria è il cambio di modello di embedding: quell’archivio lascia fuori i vettori e la destinazione li ricalcola. Un movimento che mantiene lo stesso modello di embedding mantiene i vettori, e pg_dump è il file che li trasporta.
Abbina la versione maggiore all’interno del contenitore
pg0 ascolta su 127.0.0.1:5432 all’interno del contenitore. I suoi binari vivono sotto /home/hindsight/.pg0/installation/<version>/bin, e i dati del cluster sono /home/hindsight/.pg0/instances/hindsight/data. Il ruolo, la password e il nome del database predefiniscono a hindsight. Leggi la versione del server con quel client. Se ls /home/hindsight/.pg0/installation mostra una build diversa, usa quella directory al posto di 18.1.0:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
Un dump in formato custom da quel server ripristina nella stessa versione maggiore o in una più nuova. Un’immagine ghcr.io/vectorize-io/hindsight:latest attuale riporta PostgreSQL 18.1. Il pacchetto archivio di Ubuntu 22.04 è PostgreSQL 14, che non può caricare un archivio 18.
Installa 18 dal repository Apt di PostgreSQL accanto al cluster della distribuzione. Quando 14/main esiste già, il pacchetto postgresql-18 non crea un cluster:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters dovrebbe mostrare 18/main sulla prossima porta libera, 5433 quando 14 è ancora su 5432. SELECT version(); su quella porta dovrebbe riportare PostgreSQL 18. postgresql-contrib-18 è un nome di pacchetto transitorio: apt seleziona postgresql-18, e quel pacchetto contiene pg_trgm e btree_gin.
Crea il ruolo, il database e le estensioni da Prepara PostgreSQL e pgvector, e passa -p 5433 su ogni psql in modo che i comandi colpiscano il cluster 18. Il database incorporato ha vector, pg_trgm e btree_gin. Un pacchetto pgvector più nuovo della sorgente, come 0.8.7 sul server contro 0.8.5 nell’immagine, accetta ancora il dump.
Lascia che il contenitore raggiunga quella porta
Il nuovo cluster ascolta su localhost finché listen_addresses in /etc/postgresql/18/main/postgresql.conf non include l’indirizzo LAN o *. Quella impostazione viene applicata quando il cluster 18 si avvia, quindi riavvialo con sudo pg_ctlcluster 18 main restart e controlla ss -lntp per 0.0.0.0:5433. “Connection refused” da un altro host significa che nulla sta accettando TCP su quell’indirizzo e porta.
In /etc/postgresql/18/main/pg_hba.conf, consenti l’host di Hindsight. La maschera è parte della riga; senza /32 PostgreSQL salta la riga all’avvio.
host hindsight hindsight HINDSIGHT_HOST_IP/32 scram-sha-256
host corrisponde alle connessioni SSL che i client aprono in modo predefinito. Ricarica con sudo pg_ctlcluster 18 main reload. L’indirizzo in un errore successivo “no pg_hba.conf entry … SSL encryption” è l’indirizzo da scrivere in quella riga. Da Docker, quell’indirizzo è l’host che esegue il contenitore: il bridge traduce la connessione in uscita del contenitore all’indirizzo LAN dell’host.
Dump, poi ripristina con il client 18
Sospendi gli scrittori, poi esegui il dump con il binario pg0. Le righe ritenute dopo che pg_dump apre il suo snapshot sono assenti dall’archivio.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
Sull’host del database, pg_restore deve essere il binario 18. Il client 14 non può leggere questo archivio. Copia prima il file in /tmp. L’utente di sistema postgres non può entrare nella directory home di un altro utente, quindi pg_restore riporta “Permission denied” su un dump che ls -l mostra come leggibile da tutti.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight fa sì che le tabelle ripristinate appartengano al ruolo dell’applicazione. --no-comments salta COMMENT ON EXTENSION, che fallisce con “must be owner of extension btree_gin” quando il superuser ha creato l’estensione e il ruolo dell’applicazione non l’ha fatto. --single-transaction annulla un caricamento fallito, quindi l’esecuzione successiva parte da uno schema vuoto. Un caricamento parziale lasciato da un tentativo precedente necessita di DROP DATABASE e le tre istruzioni CREATE EXTENSION di nuovo prima di un nuovo tentativo.
Confronta SELECT bank_id FROM banks ORDER BY 1 e SELECT count(*) FROM memory_units con le stesse query eseguite all’interno del contenitore prima del passaggio.
Passa il contenitore e mantieni il volume
Aggiungi l’URL al .env di Compose dall’Opzione B, usando la porta su cui il cluster 18 è effettivamente legato:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:URL_ENCODED_PASSWORD@POSTGRES_IP:5433/hindsight
Passalo nell’ambiente del servizio come HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL}. Mantieni HINDSIGHT_API_WORKER_ID invariato. Resta su ghcr.io/vectorize-io/hindsight:latest quando il servizio imposta HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL o HINDSIGHT_API_RERANKER_LOCAL_MODEL. latest-slim è l’immagine dell’Opzione B per gli endpoint di embedding e reranking che girano fuori dal contenitore. Lascia il volume hindsight-pg0 montato.
docker compose up -d ricrea il contenitore. Il log dovrebbe nominare POSTGRES_IP sulla riga “Connecting to database”, e curl -f http://localhost:8888/health dovrebbe includere "database":"connected". GET /v1/default/banks elenca le banche dati ripristinate. Ricorda un fatto che hai già archiviato. Le porte API e UI pubblicate restano le stesse, quindi Hermes e una config di coding-agent mantengono il loro URL di base esistente.
Partire di nuovo senza HINDSIGHT_API_DATABASE_URL usa il volume, che non ha ricevuto scritture mentre l’URL era impostato. Rimuovi il volume dopo quel recall riuscito. Restringi pg_hba.conf alla riga single-host una volta che il contenitore si è collegato, e ricarica.
Esporta, Importa e Migra la Banca Dati della Memoria
Spostare una banca dati incorporata su un server dedicato, e mantenere i vettori già archiviati, è coperto in Sposta il database incorporato su un server dedicato. I passaggi sottostanti sono il cambio di modello di embedding.
Cambiare il modello di embedding non è un’edit di configurazione. I vettori nella banca dati sono stati calcolati con il vecchio modello, e un modello diverso — ad esempio l’embedder BGE incorporato a 384 dimensioni contro Qwen3-Embedding-0.6B a 1024 dimensioni — scrive in uno spazio diverso e solitamente in una larghezza diversa. Non puoi ripuntare l’istanza esistente verso il nuovo embedder e mantenere i vecchi vettori; le dimensioni devono essere ricalcolate re-embeddendo ogni memoria con il nuovo modello di embedding.
Perché l’embedder e la sua configurazione sono impostati per istanza Hindsight, il percorso pulito è avviare un’istanza fresca con la nuova configurazione di embedding e migrare la banca dati in essa, piuttosto che ricostruire i vettori all’interno di quella che è già in servizio di recall. L’API di Hindsight può spostare la banca dati anche, ma per un cambio una tantum l’export/import è la via più facile e ispezionabile:
# esporta la banca dati dalla vecchia istanza
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# importa la banca dati nella nuova istanza
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t verifica l’archivio prima di spedirlo alla nuova istanza. Dopo l’import, ripunta Hermes verso l’api_url della nuova istanza in ~/.hermes/hindsight/config.json, riavvia il gateway ed esegui la convalida della memoria di prima: un fatto ritenuto dovrebbe richiamarsi attraverso il nuovo embedder. Lascia la vecchia banca dati e i suoi vettori nella vecchia istanza finché la nuova non si comporta, così hai ancora un fallback funzionante.
Monitora, Potatura e Mantieni la Banca Dati Stabile
Con la banca dati in esecuzione, il lavoro quotidiano è osservare ciò che il modello di estrazione ha deciso di archiviare e mantenere lo stato derivato sotto controllo. Usa l’UI di control plane (hindsight-embed -p hermes ui start) per ispezionare osservazioni, punteggi di rilevanza e output di consolidazione piuttosto che dare per scontato che memory status dimostri che ingestione e recall sono corretti. Le memorie duplicate o vecchie sono solitamente un’estrazione debole o una consolidazione sotto-eseguita, quindi correggi la fascia di estrazione o la cadenza di consolidazione prima di allargare il recupero.
Due trappole di manutenzione vale la pena testare prima di affidarsi alla banca dati. Primo, l’eliminazione di un’osservazione non garantisce che ogni rappresentazione derivata scompaia con essa — un fatto reflect o un bordo del grafo costruito da esso può sopravvivere all’eliminazione, quindi verifica l’eliminazione end-to-end, la stessa preoccupazione di provenienza coperta in loop di memoria auto-rinforzanti. Secondo, mantieni HINDSIGHT_API_WORKER_ID stabile tra le ricreazioni e fissa un tag di immagine specifico: un compito che era in corso quando il contenitore è morto rimane bloccato sotto il vecchio id worker, e un tag in movimento è una scarsa corrispondenza per un database che intendi mantenere.
Riferimenti
- Codice sorgente e documentazione di Hindsight
- Guida all’installazione ufficiale di Hindsight
- CLI di amministrazione Hindsight (backup e ripristino)
- Riferimento di configurazione di Hindsight
- Integrazione di Hermes in Hindsight
- Modelli di inferenza e provider di reranking di Hindsight
- pgvector
- Server llama.cpp
- Ollama
