Selfhosting

Boucles mémoire autoréinforcées dans les agents IA : causes et correctifs

Boucles mémoire autoréinforcées dans les agents IA : causes et correctifs

Lorsque des conclusions mémorisées deviennent de nouvelles preuves.

La mémoire persistante transforme un agent en un outil qui transmet le contexte au lieu de devoir réexpliquer — mais elle ouvre la porte à un mode d’échec évité par la conversation sans état : une interprétation peut devenir mémoire, être récupérée comme un fait, et justifier une version plus forte d’elle-même.
Mnemosyne pour l’agent Hermes : démarrage rapide de la mémoire locale

Mnemosyne pour l’agent Hermes : démarrage rapide de la mémoire locale

Mémoire locale Hermes avec écritures contrôlées.

Mnemosyne est un fournisseur de mémoire local-first pour Hermes Agent. Il stocke la mémoire de travail, les faits structurés, les données temporelles et l’historique épisodique dans une base SQLite locale — sans service hébergé, sans appel réseau obligatoire, et avec un contrôle d’écriture d’une granularité inhabituelle.

Comment migrer d’OpenClaw à Hermes Agent en toute sécurité

Comment migrer d’OpenClaw à Hermes Agent en toute sécurité

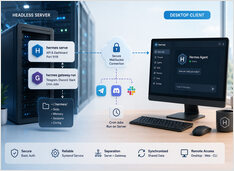
Une bascule en toute sécurité au-delà de l’importation sur une ligne

La migration d’un assistant IA ne se résume pas à la copie d’une configuration d’application. La difficulté réside dans la préservation de l’identité, de la mémoire, du comportement des outils, des tâches planifiées et de l’accès à la messagerie, tout en évitant que deux passerelles ne se comportent comme le même bot.

llama.cpp vs Ollama en 2026 : Quel runtime choisir ?

llama.cpp vs Ollama en 2026 : Quel runtime choisir ?

« Quand llama-server surpasse Ollama »

Ollama et llama.cpp sont souvent comparés comme s’ils étaient des moteurs d’inférence rivaux. Le véritable choix se fait entre un service de gestion de modèles et un kit d’outils que vous pilotez directement.

Le KV Cache sur des GPU de 16 Go : faire tenir réellement les contextes longs

Le KV Cache sur des GPU de 16 Go : faire tenir réellement les contextes longs

Pourquoi le contexte de 128 Ko échoue sur 16 Go

Un modèle peut revendiquer une fenêtre de contexte de 128K et échouer pourtant à 40K jetons sur un GPU de 16 Go. La limite architecturale ne promettait jamais que les poids, le cache KV, les tampons de calcul et le compositeur de bureau tiendraient simultanément sur votre carte.

Gravité des données : le vrai coût de l'IA API-First

Gravité des données : le vrai coût de l'IA API-First

Pourquoi votre stack IA devient plus collante chaque mois.

Chaque appel d’API semble être une transaction simple — jusqu’à ce que leur nombre accumulé fasse en sorte que vos données de réglage fin, vos outils d’évaluation et vos schémas d’outils soient tous conçus autour d’un seul fournisseur, et que le changement cesse d’être une simple modification de routage.

GPU pour l’IA en 2026 : NVIDIA, AMD et Intel comparés

GPU pour l’IA en 2026 : NVIDIA, AMD et Intel comparés

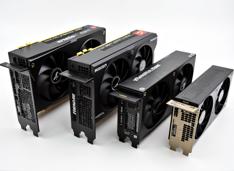
Comparaison des GPU IA entre trois fournisseurs

Le paysage du matériel pour l’IA a considérablement évolué en 2026, avec NVIDIA, AMD et Intel qui rivalisent tous pour attirer les développeurs ayant besoin de GPU capables d’exécuter localement de grands modèles de langage (LLM) et des charges de travail d’inférence IA.

Installer Docker sur Ubuntu : APT, Snap, Rootless — Guide complet 2026

Installer Docker sur Ubuntu : APT, Snap, Rootless — Guide complet 2026

Choisissez le bon chemin d'installation de Docker sur Ubuntu.

L’installation de Docker sur Ubuntu devrait être simple, mais en pratique, plusieurs options « en forme de Docker » rivalisent pour le même nom de commande, chacune avec sa propre gestion des paquets, son comportement de mise à jour et ses implications en matière de sécurité.

Systèmes de mémoire dans les assistants IA

Systèmes de mémoire dans les assistants IA

Mémoire de travail, structurée et de récupération pour les assistants.

La mémoire transforme les assistants d’entités réactives en entités persistantes, mais c’est aussi là que beaucoup de systèmes se dégradent silencieusement. Les enquêtes soutiennent que la distinction entre mémoire à court terme et mémoire à long terme n’est plus suffisante pour la mémoire des agents modernes ; les SDK d’OpenAI et de LangGraph pointent vers une pile plus simple — mémoire de travail, état durable et récupération.