Ollama et llama.cpp sont souvent comparés comme s’ils étaient des moteurs d’inférence rivaux. Le véritable choix se fait entre un service de gestion de modèles et un kit d’outils que vous pilotez directement.
ROCm et Vulkan accélèrent tous deux les GPU AMD pour l’hébergement local de LLM, mais ils ne sont pas interchangeables. Le bon choix dépend du moteur, du GPU et de la charge de travail.
Un modèle peut revendiquer une fenêtre de contexte de 128K et échouer pourtant à 40K jetons sur un GPU de 16 Go. La limite architecturale ne promettait jamais que les poids, le cache KV, les tampons de calcul et le compositeur de bureau tiendraient simultanément sur votre carte.
Pourquoi votre stack IA devient plus collante chaque mois.
Chaque appel d’API semble être une transaction simple — jusqu’à ce que leur nombre accumulé fasse en sorte que vos données de réglage fin, vos outils d’évaluation et vos schémas d’outils soient tous conçus autour d’un seul fournisseur, et que le changement cesse d’être une simple modification de routage.
Ollama est l’une des méthodes les plus simples pour exécuter un modèle de langage local, mais la praticité peut masquer le moment où une expérience locale se transforme en service de déduction partagé nécessitant une meilleure planification et une meilleure observabilité.
Vane est l’une des entrées les plus pragmatiques dans le domaine de la « recherche IA avec citations » : un moteur de réponse auto-hébergé qui combine la récupération web en direct avec des LLM locaux ou cloud, tout en gardant toute la pile sous votre contrôle.
Ollama est à son meilleur lorsque l’on le traite comme un démon local : la CLI et vos applications communiquent avec une API HTTP en boucle locale (loopback), et le reste du réseau ignore son existence.
Serveur Ollama orienté composition, avec GPU et persistance.
Ollama fonctionne parfaitement sur du matériel nu. Cela devient encore plus intéressant lorsque vous le traitez comme un service : une extrémité stable, des versions figées, un stockage persistant et une GPU qui est soit disponible, soit non.
HTTPS Ollama sans interrompre les réponses en flux.
Exécuter Ollama derrière un proxy inversé est le moyen le plus simple d’obtenir HTTPS, un contrôle d’accès facultatif et un comportement de streaming prévisible.
Si vous travaillez sur la génération augmentée par récupération (RAG), cette section explique les incorporations de texte (text embeddings) en termes simples : ce qu’elles sont, comment elles s’intègrent dans la recherche et la récupération, et comment appeler deux configurations locales courantes depuis Python en utilisant Ollama ou une API HTTP compatible OpenAI (comme le font de nombreux serveurs basés sur llama.cpp).
Test LLM OpenCode — statistiques de codage et de précision
J’ai testé comment OpenCode fonctionne avec plusieurs LLM hébergés localement sur Ollama et llama.cpp, et j’ai ajouté pour comparaison quelques modèles gratuits provenant d’OpenCode Zen.
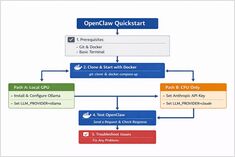
OpenClaw est un assistant IA auto-hébergé conçu pour fonctionner avec des runtime de LLM locaux comme Ollama ou avec des modèles cloud tels que Claude Sonnet.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Contrôlez vos données et modèles avec des LLM auto-hébergés
L’auto-hébergement des LLMs permet de garder les données, les modèles et l’inférence sous votre contrôle, ouvrant ainsi une voie pratique vers la souveraineté de l’IA pour les équipes, les entreprises et les nations.
Test de vitesse de LLM sur RTX 4080 avec 16 Go de VRAM
Exécuter de grands modèles de langage localement offre de la confidentialité, une capacité hors ligne et des coûts API nuls.
Ce benchmark révèle exactement ce que l’on peut attendre de 14 modèles
LLM sur Ollama avec une RTX 4080.