
Postériorité pour l’agent Hermes : Mémoire auto-hébergée avec des LLM locaux
Mémoire persistante Hermes sur votre propre matériel.
Un agent IA auto-hébergé a besoin de plus que d’une large fenêtre de contexte. Il lui faut un moyen de retenir des faits utiles, de retrouver des décisions antérieures et de réviser ce qu’il croit savoir au fur et à mesure que les projets évoluent.
Hermes Agent est livré avec des fichiers de mémoire intégrés, mais un fournisseur externe peut offrir une récupération beaucoup plus riche entre les sessions. Hindsight est l’une des options les plus intéressantes dans ce domaine. Ce guide l’installe pour Hermes sans inférence cloud, d’abord en tant que conteneur Docker tout-en-un, puis en l’interfaçant avec un serveur PostgreSQL existant et des points de terminaison de modèles locaux distincts.
Le guide couvre le déploiement, le choix et le câblage des modèles locaux d’encodage vectoriel (embeddings), de réordonnancement (reranking) et génératifs, le contrôle de ce que la fonction auto-retain écrit dans le dépôt (bank), la connexion de Hermes, et la couche opérationnelle : sauvegarde, déplacement d’un dépôt intégré vers son propre serveur PostgreSQL, et l’hygiène quotidienne du dépôt. Les exemples utilisent un schéma de ports délibéré — 8080 pour le serveur principal llama.cpp, 8081 pour les embeddings, 8082 pour le reranking, 11434 pour Ollama — modifiez-les donc en fonction des ports que vous utilisez déjà et gardez les petits serveurs sur des ports distincts de celui du modèle principal.
Ce que fait Hindsight
Hindsight est un moteur de mémoire d’agent persistant avec trois opérations principales : retain (conserver), recall (rappeler) et reflect (réfléchir/synthétiser). Retain extrait et stocke des informations ; recall combine la récupération sémantique, par mots-clés, par graphe et temporelle ; reflect synthétise une réponse à partir des mémoires accumulées. La consolidation en arrière-plan peut transformer les observations superposées en une couche de connaissance plus utile.
Ce n’est pas juste une base de données vectorielle. Un magasin vectoriel peut localiser des passages similaires, mais un système de mémoire doit également préserver la chronologie, les limites de projet, les preuves contradictoires et les changements de décisions. Ces modes d’échec sont explorés dans les boucles de mémoire auto-renforçantes.
Pour le marché plus large, consultez la comparaison des fournisseurs de mémoire d’agent. Le fichier MEMORY.md intégré à Hermes, le USER.md et les modes de mémoire sont couverts dans le guide sur le système de mémoire de Hermes Agent. Cet article suppose donc que vous savez comment la couche intégrée fonctionne.
Pourquoi aller au-delà de Mnemosyne
Mnemosyne pour Hermes offre des idées locales attrayantes, y compris le stockage SQLite et la récupération hybride. En pratique, les contraintes d’installation, la compatibilité des versions, le comportement d’approbation d’écriture et les changements rapides autour de ses préversions 4.0 peuvent rendre son exploitation prédictive difficile. Ce sont des préoccupations opérationnelles, et non des preuves que le modèle de mémoire de Mnemosyne est fondamentalement défectueux.
Hindsight n’est pas non plus exempt de dépendances : son image Docker et ses modèles locaux peuvent consommer beaucoup d’espace disque. Exécuter son API comme un service indépendant, avec l’inférence ailleurs, isole les mises à niveau et le dépannage de l’agent lui-même.
Choisir un déploiement
| Composant | A : Conteneur tout-en-un | B : Serveur PostgreSQL existant |
|---|---|---|
| API et IHM Hindsight | Conteneur Docker | Conteneur Docker |
| PostgreSQL | pg0 intégré au conteneur |
Machine PostgreSQL existante |
| LLM génératif | llama.cpp externe | llama.cpp externe |
| Encodage vectoriel (Embeddings) | Local par défaut ou externe | Ollama ou llama.cpp externe |
| Réordonnancement (Reranking) | Local par défaut ou externe | Serveur de reranking externe |
| Idéal pour | Évaluation rapide | Installation longue durée, isolée |
Ici, « tout-en-un » signifie que l’API, l’IHM et la base de données Hindsight sont dans un seul conteneur ; le LLM d’inférence est toujours hébergé ailleurs. C’est délibéré : l’image officielle Docker de Hindsight n’inclut pas de serveur llama.cpp génératif local prêt à l’emploi.
Utilisez des adresses accessibles depuis le LAN, et non localhost, pour les services exécutés sur un hôte différent. Restreignez ces ports aux clients de confiance ; les clés dummy des exemples sont des espaces réservés de compatibilité, et non de l’authentification.
Option A : Conteneur Hindsight tout-en-un
C’est la façon la plus simple d’évaluer Hindsight sans remplir la VM Hermes avec Python, Torch et les dépendances de modèles locaux. Le conteneur exécute Hindsight et PostgreSQL intégré, tandis que votre LLM llama.cpp principal gère l’extraction de la mémoire et la réflexion.
Deux étiquettes d’image sont importantes ici. ghcr.io/vectorize-io/hindsight:latest est l’image volumineuse — environ 9 Go sur AMD64 — car elle inclut un encodeur BGE, un réordonnanceur MiniLM et PostgreSQL intégré. latest-slim est d’environ 500 Mo et s’attend à ce que ces deux modèles vivent ailleurs, ce qui est ce que vous voulez une fois que vous pointez Hindsight vers la configuration d’encodage et de réordonnancement dans Servir et câbler les modèles locaux. Une fois le test de santé passé, fixez une étiquette spécifique : une étiquette mouvante est un mauvais choix pour une base de données que vous comptez conserver.
Créez un répertoire et un fichier Compose sur l’hôte Hindsight :
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API mémoire
      - "9999:9999"  # IHM du plan de contrôle
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_POSTSTATION:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Remplacez IP_POSTSTATION par l’hôte exécutant llama.cpp. Sur Linux, host.docker.internal ne se résout que si le conteneur déclare la correspondance host-gateway montrée ci-dessus ; sans cela, une URL de base http://host.docker.internal:8080/v1 ne pointe nulle part. La réservation de mémoire partagée de 1 Go est particulièrement utile pour l’indexation de PostgreSQL intégré ; le /dev/shm par défaut de Docker peut provoquer des échecs. Un volume nommé préserve la base de données lors de la recréation du conteneur, et une alternative par montage de dossier doit être possédée par l’uid 1000, l’utilisateur à l’intérieur de l’image.
HINDSIGHT_API_WORKER_ID doit rester stable entre les recréations — la valeur par défaut de Docker est le nom d’hôte du conteneur, et une tâche qui était en cours d’exécution lorsqu’un conteneur est mort reste bloquée sous l’ancien identifiant de travailleur.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Si votre version installée de Hindsight expose la santé sur un chemin différent, inspectez http://localhost:8888/docs et les journaux du conteneur. Le plan de contrôle est normalement disponible sur http://HOST_HINDSIGHT:9999. Une fois le déploiement de base fonctionnel, vous pouvez également pointer ses fournisseurs d’encodage et de réordonnancement vers la configuration dans Servir et câbler les modèles locaux plutôt que de charger les modèles par défaut à l’intérieur du conteneur.
N’exposez pas les ports 8888 ou 9999 directement à Internet. Utilisez un réseau privé ou un proxy inverse authentifié. PostgreSQL intégré est pratique pour les tests, mais une base de données gérée de manière externe est plus facile à sauvegarder et à maintenir. Un dépôt qui existe déjà dans ce volume se déplace avec la sauvegarde et la restauration dans Déplacer la base de données intégrée sur un serveur dédié.
Option B : Hindsight contre un serveur PostgreSQL existant
Pour une installation longue durée, je préfère garder l’API Hindsight, la base de données et les points de terminaison d’inférence séparés. La VM Hindsight peut rester petite car elle exécute l’orchestration et les services HTTP plutôt que des modèles lourds. Les étapes ci-dessous démarrent contre un serveur vide. Un dépôt qui vit déjà dans le volume de l’option A est déplacé dans Déplacer la base de données intégrée sur un serveur dédié.
Préparer PostgreSQL et pgvector
Hindsight a besoin de PostgreSQL 14 ou plus récent et d’une extension vectorielle dans la base de données hindsight. L’extension est propre à chaque base de données : installer le paquet sur le serveur ne fait rien tant que CREATE EXTENSION ne s’exécute pas là-bas. Sur un serveur PostgreSQL Debian ou Ubuntu, installez le paquet pgvector correspondant à la version majeure réelle de PostgreSQL ; par exemple, sur PostgreSQL 16 :
sudo apt update
sudo apt install postgresql-16-pgvector
Le nom du paquet et sa disponibilité dépendent de vos dépôts apt configurés. S’il n’est pas disponible, suivez les instructions d’installation de pgvector, ou installez un paquet compatible du dépôt PostgreSQL PGDG. Ne changez pas aveuglément la version majeure de PostgreSQL sur un serveur partagé. Sur les paquets PostgreSQL 18 de PGDG, pg_trgm et btree_gin sont livrés dans postgresql-18. Sur les paquets de distribution, ils sont dans postgresql-contrib pour cette version majeure. La base de données intégrée utilise les deux, plus vector.
Créez un rôle et une base de données dédiés en tant qu’administrateur PostgreSQL :
CREATE ROLE hindsight LOGIN PASSWORD 'REMPLACER_PAR_UN_MOT_DE_PASSE_LONG';
CREATE DATABASE hindsight OWNER hindsight;
Connectez-vous à la nouvelle base de données et activez les extensions :
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
Ces extensions ont normalement besoin de privilèges élevés pour l’installation ; le rôle d’application n’a pas besoin d’être superutilisateur. Hindsight utilise pgvector par défaut et exige 0.8.0 ou plus récent pour les scans ANN itératifs ; les serveurs plus anciens refusent ce paramétrage. HINDSIGHT_API_VECTOR_EXTENSION peut alternativement sélectionner pgvectorscale (une option DiskANN documentée par Hindsight pour les très grands dépôts) ou vchord, les deux nécessitant des paquets supplémentaires sur cette compilation exacte de PostgreSQL. Changer d’algorithme après l’existence de mémoires arrête le démarrage et demande une migration, choisissez donc avant la première conservation. Pour un dépôt Hermes personnel, pgvector est celui à installer et ensuite à oublier.
Autorisez uniquement l’hôte Hindsight via pg_hba.conf, par exemple :
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Configurez listen_addresses de PostgreSQL de manière appropriée et utilisez le TLS ou un réseau privé de confiance pour les connexions inter-hôtes. Sauvegardez cette base de données indépendamment du conteneur Docker Hindsight. Si le serveur est partagé avec d’autres applications, gardez Hindsight dans sa propre base de données, ou définissez HINDSIGHT_API_DATABASE_SCHEMA sur un schéma que vous possédez ; le schéma par défaut est public.
Exécuter Hindsight contre PostgreSQL
Créez compose.yaml sur la VM Hindsight. Cette version ne démarre pas PostgreSQL localement volontairement :
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_POSTSTATION:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Stockez l’URL de la base de données externe dans un fichier appelé .env :
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:VOTRE_MOT_DE_PASSE@IP_POSTGRES:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Si votre mot de passe contient @, :, / ou d’autres caractères réservés URL, encodez-les en URL avant de les mettre dans la chaîne de connexion. Testez que la VM Hindsight peut atteindre le port 5432 de PostgreSQL, et que pg_hba.conf autorise l’hôte Hindsight — un serveur lié uniquement à 127.0.0.1 refuse la connexion même si l’URL semble correcte. Autorisez le premier démarrage à exécuter les migrations de base de données ; les migrations s’exécutent au démarrage à moins que vous ne définissiez HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Avec l’API et la base de données en marche, continuez avec Choisir les modèles pour Hindsight et Servir et câbler les modèles locaux avant de connecter Hermes.
Choisir les modèles pour Hindsight
Le déploiement met l’API et la base de données sur le réseau. La prochaine décision est quels modèles remplissent les trois rôles d’inférence : des embeddings pour les candidats de rappel, un réordonnanceur pour les réordonner, et un LLM génératif pour conserver, réfléchir et consolider. Un défaut pratique pour un hôte Hindsight CPU dont le GPU est déjà occupé par la conversation est Qwen/Qwen3-Embedding-0.6B in-process, BAAI/bge-reranker-v2-m3 in-process, et un modèle de chat llama.cpp partagé pour les travaux génératifs.
Modèles d’encodage vectoriel (Embeddings)
Hindsight lit la dimension d’encodage au démarrage et taille le dépôt en conséquence, de sorte que le modèle que vous choisissez à la première conservation est le modèle que le dépôt conserve jusqu’à ce que vous le reconstruisiez. La dimensionnalité et le comportement des instructions sont plus importants que le rang dans les classements : un encodeur 8B plus fort ne vaut pas une migration si le dépôt est déjà une matrice de 384 ou 1024 dimensions. Les lignes ci-dessous sont triées du plus léger au plus lourd ; les chiffres de RAM sont l’empreinte chargée approximative sur CPU (FP16 / chargement local typique), et non la taille du fichier GGUF.
| Modèle | Paramètres | Dim | Contexte | Chargé | Fonctionne sur | Notes |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 Mo | CPU | Défaut Hindsight ; livré dans hindsight:latest. Chemin local le plus rapide. La distribution des scores calibre encore de nombreux défauts recall_min_scores après que vous l’avez quitté. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 Mo | CPU | BGE anglais intermédiaire ; verrouille un dépôt de 768 dimensions. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 Mo | CPU | MiniLM multilingue documenté par Hindsight ; 50+ langues à la même largeur de dépôt 384-dim que BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 Mo | CPU | Défaut pour le fournisseur onnx ; chemin multilingue CPU léger si vous avez une exportation ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 Mo | CPU | Encodeur Ollama commun ; contexte plus long que le BGE classique, toujours anglais prioritaire. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 Mo | CPU | EmbeddingGemma 2 texte uniquement (désactiver les tours de vision/audio). 100+ langues + code ; MRL tronque à 512/256/128 ; préfixes d’instruction pour la recherche vs document. Chargement multimodal complet est 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1,1 Go | CPU ou GPU | Encodeur dual multilingue fort ; même largeur que Qwen3-0.6B, donc un échange de même dimension nécessite tout de même un re-encodage complet. |
Qwen/Qwen3-Embedding-0.6B |
0,6B | 1024 | 32k | ~1,2 Go | CPU | Défaut de ce guide. Sensible aux instructions (instruction de recherche côté requête) ; confortable sur CPU. Le fournisseur local applique automatiquement l’instruction ; les serveurs compatibles OpenAI ont besoin de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 Go FP16 / ~2,5 Go quantifié | GPU | Niveau de qualité Qwen3 ; verrouille un dépôt de 2560 dimensions. Non viable lorsque le GPU conversationnel est déjà saturé. |
La façon dont le modèle est exécuté est l’autre moitié du choix. Les fournisseurs d’encodage de Hindsight, du plus simple au plus complexe :
| Fournisseur | Comment il s’exécute | Idéal quand | Notes |
|---|---|---|---|
local |
SentenceTransformers in-process ; pas de sidecar | Hôte Hindsight unique, encodeur CPU | Chemin par défaut. Définissez HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Pas de llama.cpp, Ollama ou TEI. |
onnx |
ONNX Runtime in-process | CPU plus léger que Torch ; vous avez déjà une exportation ONNX | Nécessite hindsight-api-slim[local-onnx] et HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Point de terminaison OpenAI-compatible externe ou HF TEI | Encodage hors du processus API ; hôte GPU/CPU partagé | Ce que Servir et câbler les modèles locaux configure pour Ollama / llama.cpp / TEI. Ne vaut le sidecar que si vous voulez l’isolation ou une autre machine. |
Qwen3-Embedding-0.6B n’a pas besoin d’un service d’encodage externe. Sur un hôte Hindsight CPU, il se charge dans le processus API avec le fournisseur local — Hugging Face télécharge les poids au premier démarrage, et le fournisseur applique l’instruction de recherche du modèle lui-même :
# Environnement Compose (ou équivalent clés .env)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Utilisez un point de terminaison externe compatible OpenAI uniquement si vous voulez l’encodeur sur une autre machine ou hors du processus API. Ollama est un tel hôte :
# Encodage : Qwen3-Embedding-0.6B sur Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Remplacez l’hôte, le port et l’étiquette par ce que montre ollama list sur votre machine d’inférence.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX dépend du fournisseur :
| Chemin | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Laisser non défini / vide — le fournisseur in-process applique l’instruction de recherche de Qwen lui-même | Laisser non défini / vide |
| Ollama externe / llama.cpp / compatible OpenAI | Instruction officielle de récupération Qwen3 (nouvelle ligne réelle avant Query:) |
Laisser vide — les mémoires stockées restent du texte brut |
| Le serveur enveloppe déjà les entrées dans le modèle Qwen | Laisser les deux vides — sinon l’instruction est appliquée deux fois | Laisser vide |
Pour le chemin externe, définissez :
# Nouvelle ligne réelle avant Query:. Bash $'...' est la façon fiable de la passer.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
Dans le YAML Compose, la même chaîne a besoin d’un \n explicite (ou d’une valeur multiligne littérale). Définissez les préfixes avant la première conservation : les changer plus tard signifie que les anciens vecteurs et les nouvelles requêtes ne se situent plus dans le même espace.
Deux propriétés déterminent plus que le positionnement dans le classement. Sensibilité aux instructions : les embeddings Qwen3 appliquent une instruction de recherche côté requête ; sans le préfixe correspondant sur un serveur compatible OpenAI, le côté stocké et le côté requête cessent de se situer dans le même espace. Verrouillage de dimension : parce que la largeur est lue une fois au démarrage, passer de 0,6B à 4B plus tard est une migration du dépôt, et non un changement de configuration — et même un échange de même dimension (BGE-M3 ↔ Qwen3-0.6B, ou EmbeddingGemma 2 ↔ nomic à 768) change l’espace vectoriel, de sorte que les vecteurs du dépôt ne sont pas recalculés automatiquement. Planifiez un nouveau dépôt ou un re-encodage/re-indexation manuel ; voir Exporter, importer et migrer le dépôt de mémoire. Après avoir quitté BGE-small, testez recall_min_scores contre la nouvelle distribution de scores — les seuils calibrés sur BGE-small peuvent être trop stricts pour Qwen3-0.6B et priver le réordonnanceur de candidats. Pour les benchmarks et le contexte GGUF/Ollama sur la famille Qwen3, voir Modèles d’encodage et de réordonnancement Qwen3 sur Ollama.
Modèles de réordonnancement (Reranking)
Les embeddings rappellent un ensemble de candidats ; le réordonnanceur note chaque paire requête/passage et le réordonne avant que Hindsight ne l’injecte. Avec le fournisseur local, Hindsight charge un cross-encoder SentenceTransformers (ou un réordonnanceur génératif si supporté). Avec un point de terminaison externe compatible Cohere, il envoie le corps complet de style Cohere à HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Le réordonnanceur est optionnel, mais une fois l’encodeur fixé, c’est généralement le levier le plus grand pour la qualité du rappel — et, sur CPU, souvent la majeure partie du temps réel du rappel. Les lignes sont triées du plus léger au plus lourd.
| Modèle | Paramètres | Type | Contexte | Fonctionne sur | Notes |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | Défaut Hindsight ; livré dans hindsight:latest. Inférieur à la seconde pour ~20 candidats. À garder comme repli nommé si un modèle BGE plus lourd est trop lent. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | Même famille, précision plus élevée ; toujours MS MARCO orienté anglais. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Réordonnanceur MiniLM multilingue documenté par Hindsight. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Amélioration modérée par rapport à MiniLM ; en/zh. Souvent discuté ; ignoré lorsque v2-m3 entre déjà dans le budget de latence. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU ou GPU | Défaut multilingue pratique sur CPU. Sur un dépôt de ~500 mémoires, ~2,6–2,8 s par rappel à un plancher de 20 candidats (~140 ms/candidat ; ~93–99% du temps de rappel). Plafonds de candidats 20/40/80 ; abaisser le plancher de 20 → 10 réduit environ de moitié le coût de réordonnancement. |
Qwen/Qwen3-Reranker-0.6B |
0,6B | Génératif (yes-token) | 32k | GPU recommandé | Sensible aux instructions, long contexte. Pas un cross-encoder en drop-in : nécessite le support du réordonnanceur génératif de SentenceTransformers récent, et la notation /rerank de llama.cpp a des bugs de scores faux connus (hindsight-benchmarks#11). Validez avant adoption. |
BAAI/bge-reranker-v2-gemma |
2,5B | Cross-encoder | 8k | GPU recommandé | Qualité multilingue forte ; excessif pour un dépôt personnel de quelques centaines de mémoires lorsque le GPU est déjà plein. |
Qwen/Qwen3-Reranker-4B |
4B | Génératif | 32k | GPU | Candidat Qwen de qualité supérieure ; non viable sans VRAM dédiée. |
Qwen/Qwen3-Reranker-8B |
8B | Génératif | 32k | GPU | Niveau supérieur de la famille ; mêmes avertissements de notation générative, encore plus gros. |
Les réordonnanceurs d’API cloud (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe, et similaires) fonctionnent dans Hindsight mais envoient le texte de la mémoire hors de la boîte. Pour une disposition locale uniquement inter-domaines, ils sont hors du périmètre.
Deux contraintes opérationnelles dominent le choix. VRAM : si le modèle conversationnel sature déjà le GPU (par exemple un Qwen3.8-27B Q5 sur une carte de 16 Go sans marge), chaque ligne « GPU recommandé » est hors table et le choix en direct se réduit à MiniLM ou BGE-v2-m3 sur CPU. Nombre de candidats : HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 dans l’exemple de point de terminaison externe ci-dessous) limite combien de passages le modèle renote ; chaque candidat est un passage avant complet, donc coupez le plancher avant de sauter d’un niveau de modèle. Pour Qwen3 via llama.cpp, le GGUF doit conserver la tête de classement — un ancien convert_hf_to_gguf.py qui la supprime note chaque passage proche de zéro — et même une conversion correcte a encore besoin d’un test de passage connu bon/connu mauvais jusqu’à ce que le chemin de notation générative soit confirmé.
Niveaux de LLM génératifs
Les modèles d’encodage et de réordonnancement ne sont pas des substituts du LLM génératif utilisé pour extraire et raisonner sur les mémoires. Hindsight prend en charge un LLM par défaut et des remplacements spécifiques aux opérations, qui peuvent cibler le même serveur llama.cpp ou des points de terminaison indépendants.
| Opération Hindsight | but | Niveau de modèle pratique | Exemples Qwen |
|---|---|---|---|
| Retain (Conserver) | Extraire des faits, entités, décisions et chronologie | 4B minimum pour les tests ; 9B préféré | Qwen3.5-4B / Qwen3.5-9B |
| Recall (Rappeler) | Récupération sémantique, mots-clés, graphe et temporelle | Pas de LLM génératif requis | Qwen3-Embedding-0.6B + réordonnanceur |
| Reflect (Réfléchir) | Répondre à des questions en synthétisant les mémoires récupérées | 9B à 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidation (Consolider) | Réconcilier et compresser les faits liés | 9B préféré | Qwen3.5-9B / Qwen3.8-27B |
| Renouvellement du modèle mental | Mettre à jour la compréhension synthétisée à plus long terme | 9B à 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Ce sont des recommandations opérationnelles, et non des nombres de paramètres minimaux officiels de Hindsight. Un petit modèle peut extraire correctement un numéro de port mais rater qu’une décision architecturale antérieure a été remplacée. La fiabilité de la sortie structurée et la gestion fidèle de la négation sont plus importantes que le nombre de paramètres nominal seul. Les défauts de température de Hindsight lui-même valent la peine d’être laissés tels quels — 0.1 pour conserver, 0.0 pour la consolidation, 0.9 pour réfléchir — et pour conserver et consolider, l’alias non-réfléchi vaut la peine d’être servi si votre compilation llama.cpp en a un, car les petits points de contrôle Qwen3.5 passent beaucoup de jetons en mode réflexion.
Pour un déploiement avec un point de terminaison llama.cpp Qwen3.8-27B existant, commencez par le partager entre les tâches génératives Hindsight avec une faible concurrence :
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://IP_POSTSTATION:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Plus tard, acheminez l’extraction de routine vers un modèle 9B indépendant et réservez le 27B pour la réflexion difficile :
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://HOST_LLM_MEMOIRE:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://IP_POSTSTATION:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Le plus petit modèle 4B est économique mais nécessite des tests ; 9B est un compromis qualité/performance raisonnable. Si conserver et consolider partagent un petit modèle, baissez HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE à 2 — le lot par défaut de 8 est un long prompt pour une petite fenêtre de contexte. Qwen3.6-35B-A3B est attrayant pour un serveur d’inférence séparé bien doté (c’est un modèle mixture-of-experts avec environ 3 milliards de paramètres actifs, donc budgétisez-le comme un petit modèle actif), tandis qu’un modèle dense 27B est généralement inutile pour chaque événement de conservation de routine. Limiter la concurrence en arrière-plan protège le modèle conversationnel Hermes des rafales de maintenance de la mémoire.
Servir et câbler les modèles locaux
Si les paramètres d’encodage et de réordonnanceur in-process local dans Choisir les modèles sont suffisants, vous pouvez sauter les sous-sections externes Ollama et llama.cpp et passer au câblage — ou laisser Compose sur les défauts local montrés là-bas. Les points de terminaison externes sont importants lorsque l’encodeur ou le réordonnanceur devrait vivre sur un autre hôte.
Encodage externe : Ollama ou llama.cpp
L’encodage externe est pour lorsque vous voulez Qwen3-Embedding-0.6B (ou un autre modèle) sur un hôte séparé. Deux options pratiques sont Ollama, qui gère l’acquisition et le service du modèle avec peu de configuration, et llama.cpp, qui donne un contrôle précis sur la quantification GGUF, les fils CPU, le placement des périphériques et le lot. Le contexte des modèles et les benchmarks pour les deux modèles Qwen3 sont dans Modèles d’encodage et de réordonnancement Qwen3 sur Ollama.
Qwen3-Embedding-0.6B retourne des vecteurs de 1024 dimensions, et Hindsight lit cette largeur au démarrage et taille la base de données en conséquence. Un dépôt créé avec le modèle BGE 384-dimensions inclus ne peut pas prendre ce modèle — commencez d’une base de données ou d’un volume vide, et choisissez le modèle d’encodage avant la première conservation. Un changement de fournisseur d’encodage plus tard nécessite le re-encodage des enregistrements stockés même si les deux modèles utilisent la même dimensionnalité.
Option 1 : Ollama pour Qwen3-Embedding-0.6B
Installez Ollama sur l’hôte d’inférence en utilisant sa documentation officielle d’installation Linux, puis démarrez le modèle d’encodage :
ollama pull qwen3-embedding:0.6b
ollama serve
Pour l’accès distant, configurez OLLAMA_HOST=0.0.0.0:11434 d’Ollama dans son environnement de service, redémarrez le service et verrouillez-le par pare-feu vers la VM Hindsight — la procédure est couverte dans Accès distant Ollama. Un démon lié uniquement à 127.0.0.1 est invisible pour le conteneur Hindsight. D’abord, vérifiez le nom du modèle avec ollama list, et testez le point de terminaison standard d’encodage :
curl http://HOST_ENCODE:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"Une mémoire de test"}'
Le fournisseur d’encodage OpenAI de Hindsight appelle plutôt le point de terminaison /v1/embeddings compatible OpenAI d’Ollama. Vérifiez que ce point de terminaison fonctionne avec votre version Ollama avant de configurer Hindsight. Ollama est simple pour l’encodage ; ne supposez pas que son API offre un point de terminaison de réordonnancement compatible. Pour le réordonnancement, préférez le chemin BGE local in-process ci-dessous, ou un point de terminaison llama.cpp / TEI séparé après avoir validé les scores.
Option 2 : llama.cpp pour Qwen3-Embedding-0.6B
Téléchargez une conversion GGUF Qwen3-Embedding-0.6B vérifiée. Utilisez le nom de fichier GGUF que vous avez réellement téléchargé :
#!/bin/sh
# start-embedding.sh - serveur d'encodage CPU uniquement
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Les embeddings Qwen3 utilisent le pooling du dernier jeton, contrairement au pooling CLS utilisé par certains modèles BGE. Une compilation llama.cpp CPU uniquement est préférable si vous voulez absolument aucune initialisation CUDA sur une station de travail dont le GPU est occupé par un grand modèle conversationnel. N’activez pas --reranking sur ce serveur d’encodage : cette combinaison est une façon connue de obtenir un vecteur de zéros.
curl -s http://HOST_ENCODE:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"Une mémoire de test"}' \
  | jq '.data[0].embedding | length'
Une sortie complète de Qwen3-Embedding-0.6B devrait contenir 1024 flottants. Vérifiez que la conversion GGUF et votre gestion d’instruction de requête/document de Hindsight sont compatibles ; les modèles d’encodage sensibles aux instructions peuvent perdre en précision lorsqu’ils sont promptés incorrectement.
Réordonnanceur : BGE local ou Qwen3 via llama.cpp
Le réordonnancement est différent des encodages : le modèle note chaque paire requête/document et retourne un score de pertinence. Sur un hôte Hindsight CPU uniquement — ou lorsque le GPU conversationnel n’a pas de marge VRAM — le chemin pratique est le fournisseur local de Hindsight avec BAAI/bge-reranker-v2-m3 (ou le défaut MiniLM plus léger). Aucun sidecar n’est requis :
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B est un scoreur génératif yes-token, et non un cross-encoder classique. Il peut être servi via llama.cpp avec une conversion GGUF conçue pour le classement, mais considérez ce chemin comme expérimental jusqu’à ce que vous confirmiez les scores sur une paire connue bonne/connue mauvaise : un ancien convert_hf_to_gguf.py qui supprime la tête de classement note chaque passage proche de zéro, et le chemin natif /rerank de llama.cpp a des rapports de scores faux connus pour cette famille.
#!/bin/sh
# start-reranker.sh - GPU ou CPU comme sélectionné par --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Définissez --n-gpu-layers 0 pour l’exécuter sur CPU. La version GPU a besoin de VRAM supplémentaire pour les tampons de calcul et le contexte, pas seulement des poids du modèle ; évitez de supposer que la taille du fichier est l’allocation GPU totale.
curl -s http://HOST_REORANK:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"Stockage PostgreSQL", "documents":["Hindsight stocke les mémoires dans PostgreSQL.","Une recette de pain."], "top_n":2}' \
  | jq
Le document PostgreSQL devrait classé au-dessus du document non lié ; des scores de pertinence tous à zéro signifient que le GGUF est la mauvaise conversion, et le rappel semblera aléatoire même si les faits sont stockés. Vérifiez la forme exacte results[].index et results[].relevance_score : Hindsight s’attend à une réponse de réordonnancement compatible Cohere, et la compatibilité llama.cpp peut varier entre les compilations.
Câbler les points de terminaison dans Hindsight
Ajoutez les paramètres d’environnement suivants au service Compose Hindsight, ou stockez-les dans son fichier .env. Choisissez un chemin d’encodage — local in-process, Ollama ou llama.cpp — jamais deux à la fois.
# Option A : Qwen3 in-process sur l'hôte Hindsight (CPU ; pas de sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Option B : service d'encodage llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://HOST_ENCODE:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option C : Ollama sur un autre hôte
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option : réordonnanceur BGE local (pas de sidecar ; préféré sur CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Option : point de terminaison de réordonnancement cohérent compatible llama.cpp (validez d'abord les scores Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://HOST_REORANK:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Les noms de variables sont spécifiques au fournisseur, et une erreur de frappe est silencieuse : HINDSIGHT_API_EMBEDDINGS_BASE_URL est la clé fausse, et Hindsight vise discrètement le point de terminaison d’encodage d’OpenAI au lieu de votre serveur local. Utilisez HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Avec le chemin de réordonnancement compatible Cohere, Hindsight envoie le corps complet de style Cohere à HINDSIGHT_API_RERANKER_COHERE_BASE_URL ; si le journal du conteneur montre une 404 pour /v1/rerank/rerank, votre compilation ajoute /rerank toute seule et la valeur devrait s’arrêter à /v1.
Pour les options B et C, utilisez la valeur de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX depuis Modèles d’encodage vectoriel (l’option A le laisse non défini). Testez la récupération de requête à passage sur vos mémoires réelles après la première conservation.
Contrôler ce qui est retenu
Avec la pile en marche, le prochain mode d’échec est généralement le chemin d’écriture : Hermes passe par défaut à auto_retain: true, de sorte que chaque tour de conversation peut être extrait dans le dépôt. Les suppositions incorrectes, les plans abandonnés et les déclarations exploratoires deviennent des faits recherchables, et le rappel ultérieur les traite comme des preuves — la boucle décrite dans les boucles de mémoire auto-renforçantes. La politique de capture pour Hindsight parmi d’autres fournisseurs est résumée dans la comparaison des fournisseurs de mémoire d’agent.
Modes de capture qui existent aujourd’hui
Il n’y a pas de bascule Hermes ou Hindsight nommée « synthèse de session ». Le plugin soit conserve automatiquement les tours de conversation bruts (optionnellement par lots) soit attend un appel d’outils explicite hindsight_retain avec le content que vous lui donnez.
| Mode | Paramètres Hermes / Hindsight | Ce que vous obtenez |
|---|---|---|
| Continu | auto_retain: true, retain_every_n_turns: 1 |
Chaque tour est conservé et extrait en texte de transcription |
| Auto par lots | auto_retain: true, élever retain_every_n_turns |
Les tours sont tamponnés dans le plugin ; le Nième tour envoie une charge de conservation plus grande de ces tours bruts — toujours une extraction automatique, et non un résumé curaté |
| Explicite uniquement | auto_retain: false + outil hindsight_retain |
Rien n’est stocké jusqu’à ce que l’agent appelle l’outil avec content (et optionnel context / tags) |
L’auto par lots n’est pas un résumé de session. Avec retain_every_n_turns > 1, le plugin Hindsight de Hermes accumule les tours en mémoire et les conserve en JSON de conversation ; à /new, /reset, /branch et des changements de session similaires, il purge tout tampon restant sous le document de session ancien. Il n’y a pas de résumateur dédié de fin de session, et la décomposition de session inactif a historiquement pu perdre un tampon non purgé lorsque N > 1 (pas de hook on_session_end dans le plugin). Préférez N: 1 à moins que vous n’acceptiez ce compromis.
Le « mémoriser cette session » curaté est un motif de prompt + outil, et non un drapeau de configuration. Définissez auto_retain: false, puis demandez à Hermes de résumer les décisions durables et d’appeler hindsight_retain avec ce texte — ou appelez l’outil vous-même via le chemin d’outils de l’agent. Les réflexions et consolidations du dépôt sont des opérations distinctes du serveur Hindsight qui synthétisent à partir de ce qui est déjà dans le dépôt ; elles ne remplacent pas une écriture de fin de session, et elles ne sont pas activées par une clé config.json Hermes.
Définir auto_retain sur false désactive le stockage automatique des tours. Cela n’ajoute pas de boîte de dialogue d’approbation humaine avant chaque écriture. L’agent peut toujours appeler hindsight_retain lorsque ses outils le permettent ; traitez la conservation explicite comme une capture délibérée, et non comme une file d’attente en attente.
Le vide de la file d’approbation
Un souhait commun est une file d’attente de mémoires candidates que vous réviserez et approuverez avant qu’elles n’entrent dans le dépôt. Hindsight sous Hermes ne fournit pas ce contrat aujourd’hui. Mnemosyne pour Hermes implémente des écritures en plusieurs étapes spécifiques au fournisseur dans certaines versions ; ce chemin n’est pas un standard partagé Hermes et ne s’applique pas au plugin Hindsight. Jusqu’à ce qu’un flux d’approbation amont existe, le motif utilisable est auto_retain: false, un hindsight_retain délibéré, et l’inspection ou la suppression dans l’IHM du plan de contrôle Hindsight avant que la prochaine session ne s’appuie sur un mauvais fait. Il n’y a pas de clé write_approval manquante pour Hindsight à chercher dans config.json.
Pilotage du dépôt (missions, étiquettes, directives, modèles mentaux)
Les gens appellent souvent la couche suivante « réglage fin ». Dans Hindsight, c’est surtout une configuration du dépôt, et non seulement config.json de Hermes : les missions et les paramètres d’extraction orientent ce que la conservation garde ; les étiquettes structurent les entités ; les directives et les modèles mentaux façonnent la synthèse ultérieure.
| Contrôle | Où il vit | Comment il aide |
|---|---|---|
Mission de conservation (retain_mission / bank_retain_mission de Hermes) |
Configuration du dépôt | « Faites attention à X, ignorez Y » en langage courant injecté dans l’extraction |
Mode d’extraction (concise, verbose, custom, …) |
Configuration du dépôt | concise (défaut) conserve les faits dignes de long terme ; custom remplace les règles intégrées via retain_custom_instructions |
| Étiquettes d’entité | Configuration du dépôt | Vocabulaire contrôlé clé:valeur au moment de la conservation → liens de graphe et étiquettes optionnelles ; améliore la structure de récupération, ne rejette pas à lui seul les déclarations fausses |
| Directives (« règles dures ») | API de directives du dépôt | Instructions explicites appliquées pendant réflexion (portée d’étiquette) ; contraignent la synthèse, pas une porte d’approbation d’écriture |
| Modèles mentaux | API de modèle mental du dépôt | Réponses constantes à des questions récurrentes, renouvelées via réflexion à partir de mémoires correspondantes ; dérivés, donc les faits sources mauvais les contaminent encore |
| Mission de réflexion / observations | Configuration du dépôt | Oriente la synthèse et la consolidation, pas le flux de conservation brut |
Les missions, l’extraction concise et les étiquettes réduisent le bruit et améliorent la récupération. Elles ne remplacent pas la désactivation de l’auto-conservation lorsque la précision compte plus que la complétude. Préférez une mission de conservation courte qui nomme les décisions de projet durables et ignore la logistique de discussion ; ajoutez des étiquettes d’entité seulement si vous avez une vraie taxonomie ; ajoutez des modèles mentaux pour deux ou trois questions récurrentes après que le dépôt contient déjà des faits propres.
Profil d’hygiène recommandé
Un point de départ concret pour un dépôt Hermes personnel :
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Sur le dépôt, définissez une mission de conservation et laissez l’extraction en mode concise (via le plan de contrôle ou l’API des Dépôts). Après une conservation explicite, ouvrez l’IHM, confirmez l’observation, et supprimez les erreurs avant que la consolidation ou le renouvellement du modèle mental ne s’exécute. Laissez recall_prefetch_method sur recall — reflect dépense un appel du modèle de chat avant chaque tour et injecte une synthèse plutôt que des faits sous-jacents.
Connecter Hermes Agent à Hindsight
Sur la VM Hermes, installez le plugin du catalogue, puis exécutez l’assistant de configuration. Sélectionnez Hindsight et le mode local_external ; le plugin n’a pas besoin de démarrer PostgreSQL intégré ou d’exécuter la pile de modèles Hindsight localement, et local_embedded démarrerait un second démon Hindsight à côté du conteneur que vous venez d’exécuter.
hermes plugins install hindsight
hermes memory setup hindsight
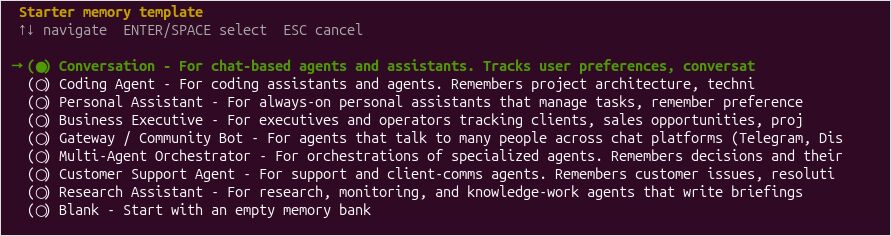
Il y aura un ensemble intéressant d’options de rôle d’agent utilisant hindsight
hermes memory status
La connexion Hindsight externe vit dans ~/.hermes/hindsight/config.json. Une configuration illustrative qui maintient la capture continue (défauts Hermes) est :
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Pour la conservation explicite uniquement et le pilotage du dépôt, utilisez le profil d’hygiène dans Contrôler ce qui est retenu au lieu de laisser auto_retain sur. recall_sync: false priorise la réactivité interactive mais peut injecter le contexte rappelé au tour suivant. Utilisez le rappel synchrone lorsque la requête actuelle doit incorporer les mémoires les plus récentes avant que le modèle ne commence à répondre. retain_async: true évite de bloquer les réponses ordinaires pendant que les mémoires sont traitées.
Le défaut de rappel du plugin est les observations uniquement ; les faits bruts du monde et de l’expérience restent dans le dépôt et hors du prompt jusqu’à ce que la consolidation ait écrit une observation, ou jusqu’à ce que vous élargissiez recall_types à observation,world,experience. L’élargir pour la première semaine et regarder le plan de contrôle, puis le resserrer, est un ordre raisonnable.
La mémoire intégrée de Hermes reste active à côté du fournisseur ; garder MEMORY.md et USER.md actifs pendant que vous apprenez ce que Hindsight ajoute est bien, et l’article sur le système de mémoire est l’endroit pour décider si les fichiers plats doivent rester.
Redémarrez la passerelle si elle est déjà en marche :
hermes gateway restart
hermes memory status
L’état devrait identifier Hindsight comme fournisseur actif. Pour une référence de commandes plus large, y compris les commandes de l’interface en ligne et du plugin de Hermes, voir la cheat sheet CLI de Hermes Agent.
Valider la mémoire, pas juste l’installation
Demandez à Hermes de retenir un fait jetable sur un projet de test, commencez une autre session, et demandez ce fait à nouveau. La conservation est asynchrone par défaut et l’extraction attend le modèle de chat, donc accordez un moment au serveur llama.cpp principal avant de juger. Puis testez un cas plus difficile : dites à Hermes qu’une décision antérieure a changé et demandez quelle décision est actuelle et pourquoi. Vérifiez l’IHM de Hindsight et les observations stockées plutôt que de supposer que memory status prouve que l’ingestion et le rappel sont corrects.
Si la réponse revient vide, inspectez le plan de contrôle avant de changer de modèles. Une conservation peut réussir et rester invisible au rappel tant que recall_types est observations uniquement et que la consolidation ne s’est pas exécutée — élargir recall_types est le premier contrôle. Une connexion refusée dans le journal du serveur d’encodage signifie que le conteneur ne peut pas atteindre le port d’encodage, et des scores de réordonnanceur tous à zéro signifient que le GGUF est la mauvaise conversion.
Les choix de chemin d’écriture (auto_retain, missions, vide d’approbation) sont couverts dans Contrôler ce qui est retenu.
Dépannage et notes opérationnelles
| Symptôme | Cause probable | Premier contrôle |
|---|---|---|
| Hermes dit fournisseur indisponible | Mauvaise URL local_external ou règle de réseau |
curl http://IP_VM_HINDSIGHT:8888/health |
| Docker démarre, erreurs PostgreSQL | Extension manquante, mauvais identifiants, ou mémoire partagée insuffisante | Journaux du conteneur et pg_extension |
| Les encodages retournent 401 ou 404 | URL compatible OpenAI incorrecte, mauvais nom de clé d’env, ou correspondance d’alias de modèle | Test direct /v1/embeddings et noms de variables |
| Le réordonnancement échoue | Décalage de point de terminaison ou format de réponse, y compris chemin /rerank doublé |
Test direct /v1/rerank et journal du conteneur |
| Le rappel ne retourne rien d’utilisable | recall_types limité aux observations, ou scores de réordonnanceur nuls |
Plan de contrôle, puis recall_types, puis conversion du réordonnanceur |
| Dépôt existant signale décalage de dimension | Modèle d’encodage changé | Reconstruire les vecteurs/reimporter avec un modèle cohérent |
| Les réponses de Hermes ralentissent | Rappel synchrone ou concurrence du LLM partagé | Désactiver le rappel synchrone ; plafonner la concurrence de conservation |
| Les mémoires non pertinentes se répètent | Extraction faible, récupération bruyante, ou consolidation insuffisante | Inspecter les observations et les scores de pertinence |
| Connexion à PostgreSQL refusée | listen_addresses est toujours localhost, ou le client a utilisé le port de l’autre grappe |
ss -lntp sur l’hôte de la base de données ; redémarrer cette grappe après avoir changé listen_addresses |
pas d'entrée pg_hba.conf pour une connexion SSL |
Pas de ligne host ou hostssl pour l’adresse du client, ou la ligne n’a pas /32 et a été ignorée |
Ajouter la ligne, recharger, et lire le journal PostgreSQL |
pg_restore ne peut pas ouvrir le déchargement |
L’utilisateur postgres ne peut pas entrer dans le répertoire personnel qui contient le fichier |
Copier le déchargement dans /tmp et restaurer d’ici |
doit être propriétaire de l'extension btree_gin |
COMMENT ON EXTENSION s’est exécuté en tant que rôle d’application |
Recréer la base de données vide et restaurer avec --no-comments |
Paquets PostgreSQL 18 installés, pg_lsclusters ne montre que 14 |
Une nouvelle majeure ne crée pas de grappe si une existe déjà | sudo pg_createcluster 18 main |
Un petit déploiement pratique est de 2 à 4 vCPU et de 4 à 6 Go de RAM pour la VM API Hindsight lorsque PostgreSQL et toute l’inférence sont externes. L’allocation de disque dépend encore de l’image Docker choisie et des couches d’image conservées ; allouez environ 30 à 40 Go initialement avec de la marge pour s’agrandir. Dimensionnez l’hôte PostgreSQL en fonction du volume de mémoire réel, des performances de stockage et des autres bases de données qu’il sert.
Sauvegarder et restaurer le dépôt Hindsight
Le dépôt de mémoire est le seul état qui compte, et il vit dans PostgreSQL. Dans l’option B, c’est une base de données que vous administrez ; dans l’option A, c’est le volume nommé pg0 intégré à l’intérieur du conteneur. Sauvegardez-le indépendamment du conteneur Hindsight — recréer le conteneur sans capturer d’abord le volume ou la base de données perd le dépôt, et hermes backup n’atteint pas un dépôt exécuté dans un service séparé.
Option B — PostgreSQL externe. Déchargez la base de données hindsight au format personnalisé, puis restaurez-la dans une base de données temporaire pour vérifier l’archive avant de vous y fier :
pg_dump -h IP_POSTGRES -U hindsight -Fc hindsight > hindsight-bank.dump

# restaurer dans une base de données temporaire pour prouver que le déchargement est utilisable
createdb -h IP_POSTGRES -U postgres hindsight-verify
pg_restore -h IP_POSTGRES -U postgres -d hindsight-verify hindsight-bank.dump
Confirmez que l’extension pgvector et un rappel d’échantillon existent dans la copie restaurée avant de supprimer la cible du déchargement d’origine. Gardez le déchargement sur un hôte différent de la VM Hindsight, et exécutez ceci en tant qu’administrateur PostgreSQL (un rôle capable de créer des bases de données) plutôt qu’en tant que rôle d’application.
Option A — conteneur tout-en-un. La base de données intégrée est un volume nommé, donc arrêtez le conteneur et tarrez le volume via une image jetable :
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Le point de montage à l’intérieur du conteneur tar (/data) est arbitraire ; il aliène simplement le volume nommé pour que tar puisse le lire. Pour restaurer sur le même volume, arrêtez le conteneur, videz le volume, et décompressez l’archive à l’intérieur. Déplacer ce dépôt sur un serveur que vous administrez est le déchargement et la restauration dans Déplacer la base de données intégrée sur un serveur dédié.
Prenez une instantanée à trois moments plutôt que selon un calendrier : avant de changer le modèle d’encodage, avant une mise à niveau majeure de Hindsight ou de PostgreSQL, et avant un passage reflect ou consolidation qui réécrit le dépôt. Une sauvegarde que vous avez restaurée dans un dépôt temporaire vaut plus qu’une que vous avez seulement écrite.
Déplacer la base de données intégrée sur un serveur dédié
Le dépôt tout-en-un est le volume nommé monté sur /home/hindsight/.pg0. Définir HINDSIGHT_API_DATABASE_URL fait que ce conteneur ouvre la base de données nommée dans l’URL et exécute les migrations. Le volume est inchangé. Déplacez les lignes avec pg_dump et pg_restore, puis gardez le même conteneur et pointez-le vers le nouveau serveur.
Le guide d’installation décrit pg0 intégré et une URL externe comme deux façons de démarrer un serveur vide. hindsight-admin sauvegarde et restauration copie les tables entre les bases de données ; restore tronque le schéma cible et a besoin que les tables existent d’abord. Exporter, importer et migrer le dépôt de mémoire est le changement de modèle d’encodage : cette archive laisse les vecteurs de côté et la destination les recalcule. Un déplacement qui garde le même modèle d’encodage garde les vecteurs, et pg_dump est le fichier qui les transporte.
Correspondre à la version majeure à l’intérieur du conteneur
pg0 écoute sur 127.0.0.1:5432 à l’intérieur du conteneur. Ses binaires vivent sous /home/hindsight/.pg0/installation/<version>/bin, et les données de la grappe sont /home/hindsight/.pg0/instances/hindsight/data. Le rôle, le mot de passe et le nom de la base de données sont par défaut hindsight. Lisez la version du serveur avec ce client. Si ls /home/hindsight/.pg0/installation montre une compilation différente, utilisez ce répertoire à la place de 18.1.0 :
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
Un déchargement au format personnalisé de ce serveur se restaure dans la même version majeure ou une plus récente. Une image ghcr.io/vectorize-io/hindsight:latest actuelle signale PostgreSQL 18.1. Le paquet d’archive d’Ubuntu 22.04 est PostgreSQL 14, qui ne peut pas charger une archive 18.
Installez 18 depuis le dépôt Apt PostgreSQL à côté de la grappe de distribution. Lorsque 14/main existe déjà, le paquet postgresql-18 ne crée pas de grappe :
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters devrait montrer 18/main sur le prochain port libre, 5433 lorsque 14 est encore sur 5432. SELECT version(); sur ce port devrait signaler PostgreSQL 18. postgresql-contrib-18 est un nom de paquet transitoire : apt sélectionne postgresql-18, et ce paquet contient pg_trgm et btree_gin.
Créez le rôle, la base de données et les extensions depuis Préparer PostgreSQL et pgvector, et passez -p 5433 sur chaque psql pour que les commandes touchent la grappe 18. La base de données intégrée a vector, pg_trgm, et btree_gin. Un paquet pgvector plus récent que la source, comme 0.8.7 sur le serveur contre 0.8.5 dans l’image, accepte encore le déchargement.
Permettre au conteneur d’atteindre ce port
La nouvelle grappe écoute sur localhost jusqu’à ce que listen_addresses dans /etc/postgresql/18/main/postgresql.conf inclue l’adresse LAN ou *. Ce paramétrage est appliqué lorsque la grappe 18 démarre, donc redémarrez-la avec sudo pg_ctlcluster 18 main restart et vérifiez ss -lntp pour 0.0.0.0:5433. « Connexion refusée » d’un autre hôte signifie que rien n’accepte les TCP sur cette adresse et ce port.
Dans /etc/postgresql/18/main/pg_hba.conf, autorisez l’hôte Hindsight. Le masque fait partie de la ligne ; sans /32, PostgreSQL ignore la ligne au démarrage.
host hindsight hindsight IP_HOTE_HINDSIGHT/32 scram-sha-256
host correspond aux connexions SSL que les clients ouvrent par défaut. Rechargez avec sudo pg_ctlcluster 18 main reload. L’adresse dans une erreur de suivi « pas d’entrée pg_hba.conf … chiffrement SSL » est l’adresse à écrire dans cette ligne. Depuis Docker, cette adresse est l’hôte exécutant le conteneur : le pont traduit la connexion sortante du conteneur vers l’adresse LAN de l’hôte.
Décharger, puis restaurer avec le client 18
Pausez les écrivains, puis déchargez avec le binaire pg0. Les lignes conservées après que pg_dump ouvre son instantané sont absentes de l’archive.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
Sur l’hôte de la base de données, pg_restore doit être le binaire 18. Le client 14 ne peut pas lire cette archive. Copiez d’abord le fichier dans /tmp. L’utilisateur système postgres ne peut pas entrer dans le répertoire personnel d’un autre utilisateur, donc pg_restore signale « Permission refusée » sur un déchargement que ls -l montre comme lisible par tous.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight fait que les tables restaurées appartiennent au rôle d’application. --no-comments saute COMMENT ON EXTENSION, qui échoue avec « doit être propriétaire de l’extension btree_gin » lorsque le superutilisateur a créé l’extension et que le rôle d’application ne l’a pas fait. --single-transaction annule un chargement raté, donc la prochaine exécution commence d’un schéma vide. Un chargement partiel laissé par une tentative antérieure a besoin de DROP DATABASE et des trois déclarations CREATE EXTENSION à nouveau avant une tentative.
Comparez SELECT bank_id FROM banks ORDER BY 1 et SELECT count(*) FROM memory_units avec les mêmes requêtes exécutées à l’intérieur du conteneur avant la bascule.
Basculer le conteneur et garder le volume
Ajoutez l’URL au .env Compose de l’option B, en utilisant le port que la grappe 18 a réellement lié :
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:MOT_DE_PASSE_ENCODE_URL@IP_POSTGRES:5433/hindsight
Passez-le dans l’environnement du service en tant que HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL}. Gardez HINDSIGHT_API_WORKER_ID inchangé. Restez sur ghcr.io/vectorize-io/hindsight:latest lorsque le service définit HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL ou HINDSIGHT_API_RERANKER_LOCAL_MODEL. latest-slim est l’image de l’option B pour les points de terminaison d’encodage et de réordonnancement qui s’exécutent hors du conteneur. Laissez le volume hindsight-pg0 monté.
docker compose up -d recrée le conteneur. Le journal devrait nommer IP_POSTGRES sur la ligne « Connexion à la base de données », et curl -f http://localhost:8888/health devrait inclure "database":"connecté". GET /v1/default/banks liste les dépôts restaurés. Rappelez un fait que vous avez déjà stocké. Les ports API et IHM publiés restent les mêmes, donc Hermes et une configuration d’agent de code gardent leur URL de base existante.
Démarrer à nouveau sans HINDSIGHT_API_DATABASE_URL utilise le volume, qui n’a reçu aucune écriture pendant que l’URL était définie. Supprimez le volume après que ce rappel a réussi. Resserrez pg_hba.conf sur la ligne d’hôte unique une fois que le conteneur s’est connecté, et rechargez.
Exporter, importer et migrer le dépôt de mémoire
Déplacer un dépôt intégré sur un serveur dédié, et garder les vecteurs déjà stockés, est couvert dans Déplacer la base de données intégrée sur un serveur dédié. Les étapes ci-dessous sont le changement de modèle d’encodage.
Changer le modèle d’encodage n’est pas une modification de configuration. Les vecteurs dans le dépôt ont été calculés avec l’ancien modèle, et un modèle différent — par exemple l’encodeur BGE 384-dimensions inclus contre Qwen3-Embedding-0.6B 1024-dimensions — écrit dans un espace différent et généralement une largeur différente. Vous ne pouvez pas rediriger l’instance existante vers le nouvel encodeur et garder les anciens vecteurs ; les dimensions doivent être recalculées en re-encodant chaque mémoire avec le nouveau modèle d’encodage.
Parce que l’encodeur et sa configuration sont définis par instance Hindsight, le chemin propre est de mettre en place une nouvelle instance avec la nouvelle configuration d’encodage et de migrer le dépôt dedans, plutôt que de reconstruire les vecteurs à l’intérieur de celle qui sert déjà le rappel. L’API Hindsight peut déplacer le dépôt aussi, mais pour un changement ponctuel, l’exportation/importation est le chemin plus facile et plus inspectable :
# exporter le dépôt de l'ancienne instance
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# importer le dépôt dans la nouvelle instance
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t vérifie l’archive avant de l’envoyer à la nouvelle instance. Après l’importation, redirigez Hermes vers l’api_url de la nouvelle instance dans ~/.hermes/hindsight/config.json, redémarrez la passerelle, et exécutez la validation de la mémoire d’avant : un fait conservé devrait rappeler via le nouvel encodeur. Laissez l’ancien dépôt et ses vecteurs dans l’ancienne instance jusqu’à ce que la nouvelle se comporte bien, afin d’avoir toujours un repli fonctionnel.
Surveiller, élaguer et garder le dépôt stable
Avec le dépôt en marche, le travail quotidien est de regarder ce que le modèle d’extraction a décidé de stocker et de garder l’état dérivé sous contrôle. Utilisez l’IHM du plan de contrôle (hindsight-embed -p hermes ui start) pour inspecter les observations, les scores de pertinence et la sortie de consolidation plutôt que de supposer que memory status prouve que l’ingestion et le rappel sont corrects. Les mémoires dupliquées ou périmées sont généralement une extraction faible ou une consolidation mal exécutée, donc corrigez le niveau d’extraction ou la cadence de consolidation avant d’élargir la récupération.
Deux pièges de maintenance valent la peine d’être testés avant de vous fier au dépôt. D’abord, supprimer une observation ne garantit pas que toute représentation dérivée disparaît avec elle — un fait reflect ou un bord de graphe construit à partir de lui peut survivre à la suppression, donc vérifiez la suppression de bout en bout, la même préoccupation de provenance couverte dans les boucles de mémoire auto-renforçantes. Deuxièmement, gardez HINDSIGHT_API_WORKER_ID stable entre les recréations et fixez une étiquette d’image spécifique : une tâche qui était en cours lorsqu’un conteneur est mort reste bloquée sous l’ancien identifiant de travailleur, et une étiquette mouvante est un mauvais choix pour une base de données que vous comptez conserver.
