
Prix de la RAM en Australie - décembre 2025
Court post, note simplement le prix.
Face à cette volatilité folle des prix de la RAM, afin de mieux comprendre la situation, commençons par suivre nous-mêmes l’évolution des prix de la RAM en Australie.
Court post, note simplement le prix.
Face à cette volatilité folle des prix de la RAM, afin de mieux comprendre la situation, commençons par suivre nous-mêmes l’évolution des prix de la RAM en Australie.
Les prix de la mémoire vive augmentent de 163 % à 619 % sous la pression de la demande en IA sur l'offre.
Le marché de la mémoire connaît une volatilité des prix sans précédent à la fin 2025, avec une flambée des prix de la RAM spectaculaire dans tous les segments.
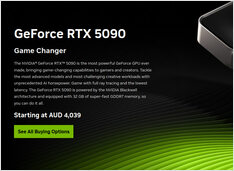
Prix des GPU grand public adaptés à l'IA - RTX 5080 et RTX 5090
Comparons les prix des GPU grand public de premier niveau, qui sont particulièrement adaptés aux LLM et à l’IA en général. Plus précisément, j’examine les prix des RTX-5080 et RTX-5090.
Déployez une IA d'entreprise sur du matériel abordable avec des modèles ouverts.
La démocratisation de l’IA est arrivée. Avec des LLM open-source comme Llama, Mistral et Qwen qui rivalisent désormais avec les modèles propriétaires, les équipes peuvent construire une puissante infrastructure IA utilisant du matériel grand public - réduisant les coûts tout en conservant un contrôle total sur la confidentialité des données et le déploiement.
Activez l'accélération GPU pour Docker Model Runner avec prise en charge NVIDIA CUDA
Docker Model Runner est l’outil officiel de Docker pour exécuter des modèles d’IA localement, mais l’activation de l’accélération GPU NVidia dans Docker Model Runner nécessite une configuration spécifique.
Benchmarks GPT-OSS 120b sur trois plateformes d'IA
J’ai découvert des tests de performance intéressants sur l’exécution du modèle GPT-OSS 120b avec Ollama sur trois plateformes différentes : NVIDIA DGX Spark, Mac Studio, et RTX 4080. Le modèle GPT-OSS 120b de la bibliothèque Ollama pèse 65 Go, ce qui signifie qu’il ne peut pas s’exécuter dans les 16 Go de VRAM d’un RTX 4080 (ou sur le plus récent RTX 5080).
Référence rapide des commandes Docker Model Runner
Docker Model Runner (DMR) est la solution officielle de Docker pour exécuter des modèles d’IA localement, introduite en avril 2025. Cette fiche pratique fournit un référentiel rapide pour toutes les commandes essentielles, les configurations et les bonnes pratiques.
Gestion simple de VM pour Linux avec GNOME Boxes
Dans le paysage actuel de l’informatique, la virtualisation est devenue essentielle pour le développement, les tests et le fonctionnement de plusieurs systèmes d’exploitation. Pour les utilisateurs de Linux souhaitant gérer des machines virtuelles de manière simple et intuitive, GNOME Boxes se distingue comme une option légère et conviviale qui privilégie l’ergonomie sans sacrifier la fonctionnalité.
Les ASIC et le silicium sur mesure boostent la vitesse et l’efficacité de l’inférence des LLM
L’avenir de l’IA ne concerne pas uniquement des modèles plus intelligents. Il s’agit également de la silice qui correspond à la manière dont ces modèles sont réellement servis. Le matériel spécialisé pour l’inférence LLM suit un chemin rappelant la transition du minage de Bitcoin des GPU vers les ASIC dédiés, avec des contraintes plus rigoureuses car les modèles et les recettes de précision continuent d’évoluer.
Disponibilité, prix de détail réels dans six pays et comparaison avec le Mac Studio.
NVIDIA DGX Spark est bien réel, en vente à partir du 15/10/2025, et destiné aux développeurs CUDA ayant besoin de travailler sur des LLM locaux avec un NVIDIA AI stack intégré. Le PPU aux États-Unis est de 3 999 $ ; le prix de détail en Royaume-Uni/Allemagne/Japon est plus élevé en raison de la TVA et des coûts de distribution. Les prix publics en AUD/KRW ne sont pas encore largement affichés.
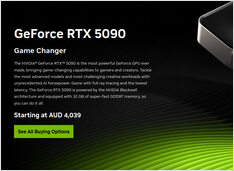
Prix des GPU grand public adaptés à l'IA - RTX 5080 et RTX 5090
Comparons les prix des GPU grand public haut de gamme, particulièrement adaptés aux LLM et à l’IA en général. Plus précisément, je me penche sur les prix des RTX-5080 et RTX-5090. Ils ont légèrement baissé.
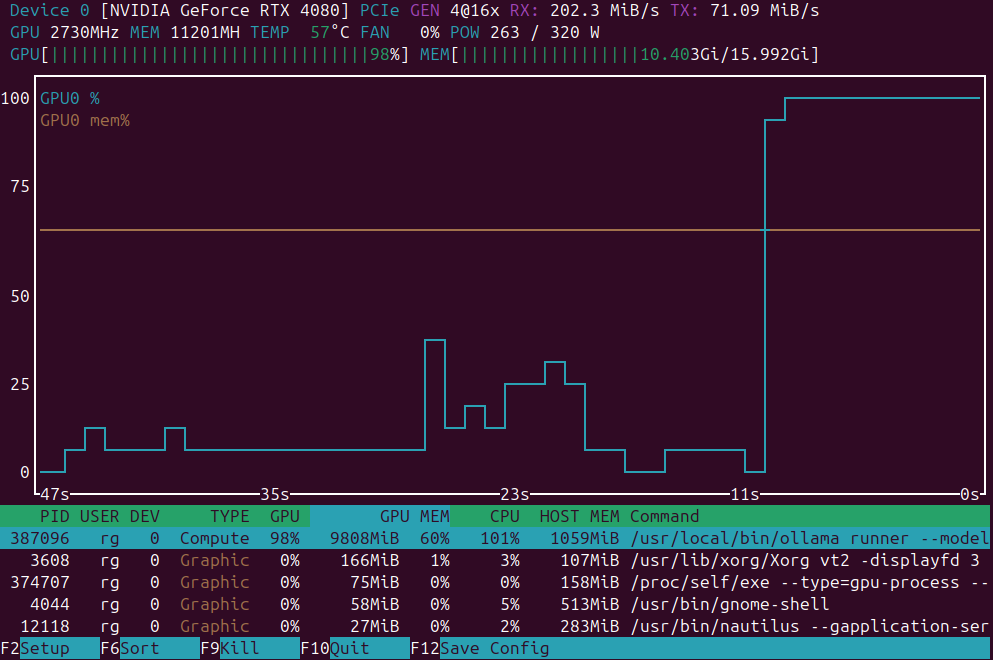
Petite liste d'applications pour le suivi de la charge du GPU
Applications de surveillance de la charge du GPU :
nvidia-smi vs nvtop vs nvitop vs KDE plasma systemmonitor.
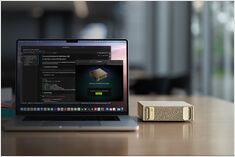
En juillet 2025, cela devrait bientôt être disponible.
Nvidia s’apprête à publier NVIDIA DGX Spark - un petit supercalculateur IA basé sur l’architecture Blackwell, doté de plus de 128 Go de mémoire unifiée et d’une performance IA de 1 PFLOPS. Un appareil idéal pour exécuter des LLM.
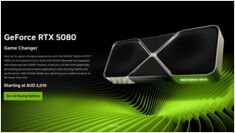
Mise à jour des prix de GPU adaptés à l'IA - RTX 5080 et RTX 5090
Comparons les prix des GPU grand public de première ligne, particulièrement adaptés aux LLM et à l’IA en général.
Examinons plus particulièrement les prix des RTX 5080 et RTX 5090. Ils ont légèrement baissé.
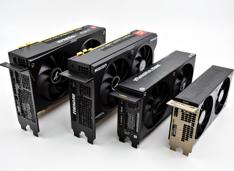
Vérification de la réalité des prix - RTX 5080 et RTX 5090
Il y a seulement 3 mois, nous ne voyions pas de RTX 5090 dans les magasins, et maintenant elles sont là, mais les prix sont légèrement supérieurs au prix de vente conseillé (MRSP). Comparons les prix les plus bas pour la RTX 5080 et la RTX 5090 en Australie et voyons comment cela se passe.
Plus de RAM, moins de consommation, mais toujours aussi cher que...
Système automatisé de pointe pour un travail impressionnant.