Ai

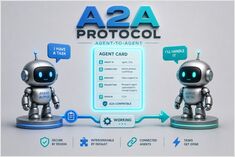
Sécurité des agents A2A et MCP : identité, délégation et traçabilité

Sécurité des agents A2A et MCP : identité, délégation et traçabilité

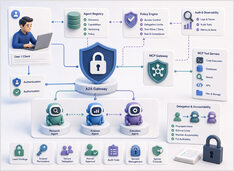
La sécurité du protocole concerne qui peut agir, non le modèle.

L’injection de prompt attire la majeure partie de l’attention en matière de sécurité dans les systèmes de LLM, et cela est justifié, mais ce n’est pas le seul problème une fois que les agents commencent à utiliser des outils et à déléguer du travail à d’autres agents.
Décodage spéculatif : inférence LLM 20 à 50 % plus rapide

Décodage spéculatif : inférence LLM 20 à 50 % plus rapide

Inférence LLM plus rapide sans perte de qualité : un guide pratique

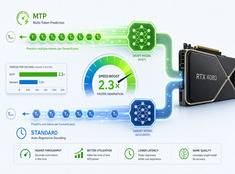
Un modèle de 70B génère un jeton par passe avant, et chaque passe recharge les poids depuis la VRAM, calcule l’attention sur l’ensemble du contexte et synchronise la mémoire. Entre les jetons, le GPU reste inactif pendant qu’il attend la résolution des dépendances séquentielles.

Les garde-fous des LLM en pratique : ce qui fonctionne réellement

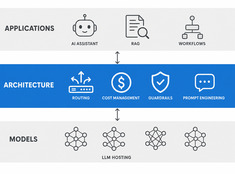
Les garde-fous des LLM en pratique : ce qui fonctionne réellement

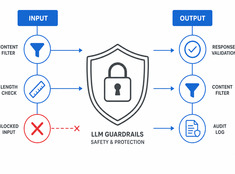
Contrôlez le risque, pas seulement le modèle.

Les LLMs sont imprévisibles. Ils hallucinent, fuient des données, génèrent du contenu nuisible ou refusent des demandes légitimes. Les garde-fous (guardrails) contraignent le comportement du modèle sans sacrifier ses capacités.

Routage des modèles : cessez d’utiliser un seul modèle pour tout

Routage des modèles : cessez d’utiliser un seul modèle pour tout

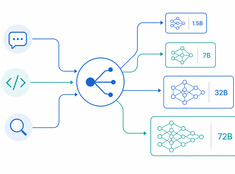
Le bon modèle pour la bonne tâche.

Exécuter un modèle de 70 milliards de paramètres pour résumer un e-mail de 200 mots est un gaspillage. Utiliser un modèle de 3 milliards de paramètres pour passer en revue du code en production est négligent. La plupart des systèmes se situent quelque part entre les deux — et c’est là qu’intervient le routage de modèles.

Systèmes de mémoire dans les assistants IA

Systèmes de mémoire dans les assistants IA

Mémoire de travail, structurée et de récupération pour les assistants.

La mémoire transforme les assistants d’entités réactives en entités persistantes, mais c’est aussi là que beaucoup de systèmes se dégradent silencieusement. Les enquêtes soutiennent que la distinction entre mémoire à court terme et mémoire à long terme n’est plus suffisante pour la mémoire des agents modernes ; les SDK d’OpenAI et de LangGraph pointent vers une pile plus simple — mémoire de travail, état durable et récupération.