Ai

Użycie interfejsu API Ollama Web Search w Pythonie

Użycie interfejsu API Ollama Web Search w Pythonie

Tworzenie agentów wyszukiwania AI za pomocą Pythona i Ollama

Biblioteka Pythona Ollama zawiera teraz natywne możliwości wyszukiwania w sieci OLlama web search. Dzięki kilku linijkom kodu możesz wzbogacić swoje lokalne modele językowe o rzeczywiste informacje z sieci, zmniejszając halucynacje i poprawiając dokładność.
Porównanie baz wektorowych dla RAG

Porównanie baz wektorowych dla RAG

Wybierz odpowiednią bazę wektorową dla swojej architektury RAG.

Wybór odpowiedniej bazy wektorowej może zadecydować o powodzeniu Twojej aplikacji RAG pod względem wydajności, kosztów i skalowalności. To kompleksowe porównanie obejmuje najpopularniejsze opcje w latach 2024-2025.

Ollama a vLLM, a LM Studio: najlepszy sposób na uruchamianie LLM lokalnie w 2026 roku?

Ollama a vLLM, a LM Studio: najlepszy sposób na uruchamianie LLM lokalnie w 2026 roku?

Porównanie najlepszych narzędzi do lokalnego hostingu LLM w 2026 roku. Dojrzałość API, obsługa sprzętu, wywoływanie narzędzi oraz zastosowania w praktyce.

Lokalne uruchamianie LLM jest obecnie praktyczne dla deweloperów, startupów, a nawet zespołów korporacyjnych.
Ale wybór odpowiedniego narzędzia — Ollama, vLLM, LM Studio, LocalAI lub innego — zależy od Twoich celów:

Go w usłudze mikroserwisowe do orkiestracji AI/ML

Go w usłudze mikroserwisowe do orkiestracji AI/ML

Tworzenie solidnych potoków AI/ML z mikrousługami w Go

W miarę jak obciążenia związane z AI i ML stają się coraz bardziej złożone, rośnie potrzeba wdrożenia solidnych systemów orkiestracji. Prostota, wydajność i konkurencja języka Go sprawiają, że jest on idealnym wyborem do budowy warstwy orkiestracji w potokach ML, nawet wtedy, gdy same modele są napisane w Pythonie.

Infrastruktura sztucznej inteligencji na sprzęcie konsumenckim

Infrastruktura sztucznej inteligencji na sprzęcie konsumenckim

Wdrażanie przedsiębiorstwowej sztucznej inteligencji na budżetowym sprzęcie przy użyciu modeli open-source.

Demokratyzacja sztucznej inteligencji jest tuż przed nami. Dzięki otwartym modelom LLM takim jak Llama, Mistral i Qwen, które dorównują już modelom własnościowym, zespoły mogą budować potężną infrastrukturę AI na sprzęcie konsumenckim – drastycznie obniżając koszty, jednocześnie zachowując pełną kontrolę nad prywatnością danych i wdrożeniem.

Uruchamianie FLUX.1-dev GGUF Q8 w Pythonie

Uruchamianie FLUX.1-dev GGUF Q8 w Pythonie

Przyspiesz FLUX.1-dev za pomocą kwantyzacji GGUF

FLUX.1-dev to potężny model generowania obrazów na podstawie tekstu, który daje wspaniałe wyniki, ale jego wymagania co do pamięci (24 GB i więcej) sprawiają, że trudno go uruchomić na wielu systemach. GGUF quantization of FLUX.1-dev oferta rozwiązania, które zmniejsza zużycie pamięci o około 50%, jednocześnie zachowując bardzo dobre jakość obrazów.

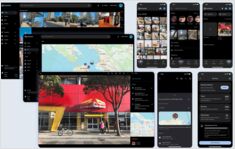
Autonomiczne hostowanie Immich: prywatne chmura zdjęć

Autonomiczne hostowanie Immich: prywatne chmura zdjęć

Twoje zdjęcia w samodzielnej, AI-opartej kopii zapasowej

Immich to rewolucyjne, open-source, samozostawiające się rozwiązanie do zarządzania zdjęciami i filmami, które daje Ci pełną kontrolę nad swoimi wspomnieniami. Dzięki funkcjom równorzędnym Google Photos, w tym AI-powered rozpoznawaniu twarzy, inteligentnemu wyszukiwaniu i automatycznemu backupowi z telefonu, wszystko to, przy jednoczesnym zachowaniu prywatności i bezpieczeństwa danych na Twoim własnym serwerze.