
LLM ASICと専用推論チップ(その重要性)
ASICおよびカスタムシリコンにより、LLM推論の速度と効率を追求する
ASICおよびカスタムシリコンにより、LLM推論の速度と効率を追求する
6カ国の実売価格、供給状況、およびMac Studioとの比較
NVIDIA DGX Spark は実在しており、2025年10月15日に発売開始予定です。CUDA環境でのローカルLLM作業を必要とする開発者向けに、統合されたNVIDIA AIスタックを搭載しています。アメリカのMSRPは3,999ドルですが、英国/ドイツ/日本の小売価格はVAT(付加価値税)や流通経費により高くなります。豪ドル/韓ウォンでの公定価格はまだ広く公開されていません。
これらの2つのモデルの速度、パラメータ、性能を比較する
以下は、Qwen3:30b と GPT-OSS:20bの比較です。 指示への追従(Instruction Following)および性能パラメータ、仕様、速度に焦点を当てています。
+ 思考型LLMを使用した具体的な例
この投稿では、PythonアプリケーションをOllamaに接続する2つの方法について紹介します。1つ目はHTTP REST APIを使用する方法、2つ目は公式のOllama Pythonライブラリを使用する方法です。
あまり良くない。
OllamaのGPT-OSSモデルは、LangChainやOpenAI SDK、vllmなどのフレームワークと使用する際に、構造化された出力を処理する際に繰り返し問題が発生しています。
わずかに異なるAPIには、特別なアプローチが必要です。
主要なLLMプロバイダーで構造化出力(信頼性の高いJSONの取得)を並べて比較したサポート状況と、最小限のPythonの例をご紹介합니다。
Ollamaから構造化された出力を取得するいくつかの方法
大規模言語モデル(LLM) は強力ですが、プロダクション環境では自由形式の段落を欲しがることは稀です。 むしろ、アプリケーションに投入できる予測可能なデータ(属性、事実、構造化オブジェクト)が欲しいのです。 それがLLM構造化出力です。
オラマモデルのスケジューリングに関する自分のテスト
ここでは、新しいバージョンのOllamaがモデルに対してどのくらいのVRAMを割り当てているかについて、Ollama VRAM割り当てと以前のOllamaバージョンを比較しています。新しいバージョンは、以前のバージョンよりも劣っています。
Ollama開発の現状についての私の見解
Ollamaは、LLM(大規模言語モデル)をローカルで実行するための最も人気のあるツールの一つに急速に成長しました。 そのシンプルなCLIと、洗練されたモデル管理は、クラウド外でAIモデルを扱いたい開発者にとって、定番の選択肢となっています。
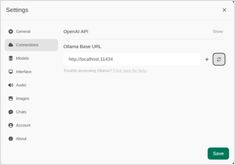
2025年のOllamaで最も注目されているUIの概要
ローカルにホストされた Ollama は、あなたのマシン上で大規模言語モデルを実行できるが、コマンドライン経由での使用はユーザーにとって使いにくい。
以下に、ローカルの Ollama に接続するための、いくつかのオープンソースプロジェクトが提供する ChatGPTスタイルのインターフェース がある。
2025 年 7 月にもまもなく利用可能となるでしょう。
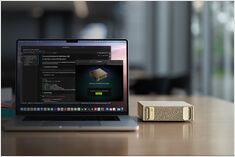
Nvidia 社がNVIDIA DGX Sparkの発売を控えています。これは Blackwell アーキテクチャを採用した小型 AI スーパーコンピュータで、128GB 以上の統一メモリと 1 PFLOPS の AI 性能を備えています。LLM を実行するに最適なデバイスです。
GOにおけるMCP仕様と実装に関する長文記事
ここに、モデルコンテキストプロトコル(MCP)の説明が示されています。MCPサーバーの実装方法の短いノート(GoでのMCPサーバーの実装)も含まれており、メッセージ構造やプロトコル仕様についても記載されています。
RAG を実装中ですか?Go のコードスニペットを紹介 - 2 部目
標準の Ollama には直接的なリランク API がないため、クエリ - ドキュメントペアのエンベッディングを生成してスコアリングを行うことで、Go 言語による Qwen3 Reranker を使ったリランキング を実装する必要があります。
Qwen3 8B、14Bおよび30B、Devstral 24B、Mistral Small 24B
このテストでは、Ollama上でホストされているさまざまなLLMがHugoページを英語からドイツ語に翻訳する方法を比較しています。英語からドイツ語への翻訳。
RAG の実装ですね。Golang 用のコードスニペットをいくつか紹介します。
この小さな Reranking Go コード例は、クエリと各候補ドキュメントの埋め込みを生成するために Ollama を呼び出し、 その後、コサイン類似度で降順にソートします。
Ollama で利用可能な新しい素晴らしい LLM
Qwen3 埋め込みモデルとreranker モデル は、Qwen ファミリー最新リリースであり、高度なテキスト埋め込み、検索、再ランク付けタスクに特じて設計されています。