
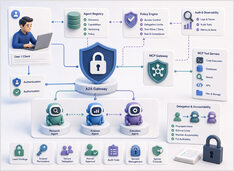
A2AおよびMCPエージェントのセキュリティ:アイデンティティ、委任、および監査証跡
プロトコルセキュリティはモデルではなく、誰が実行できるか(誰が操作を行えるか)を定義するものです。
LLMシステムにおけるセキュリティの関心は、プロンプトインジェクションに最も集中していますが、それは確かに注目を集めるべきものです。しかし、エージェントがツールを呼び出し、他のエージェントに作業を委任し始めると、それは問題の一部に過ぎなくなります。
プロトコルセキュリティはモデルではなく、誰が実行できるか(誰が操作を行えるか)を定義するものです。
LLMシステムにおけるセキュリティの関心は、プロンプトインジェクションに最も集中していますが、それは確かに注目を集めるべきものです。しかし、エージェントがツールを呼び出し、他のエージェントに作業を委任し始めると、それは問題の一部に過ぎなくなります。
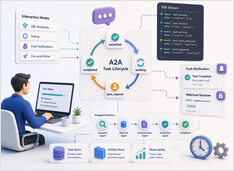
長期実行されるA2Aタスクは、チャットセッションの終了後も継続して実行されます。
ほとんどのAIエージェントのデモは、追加のステップを伴うチャット補完のように振る舞います。プロンプトを送信し、数秒待ってから、1つのレスポンスとして回答を受け取ります。
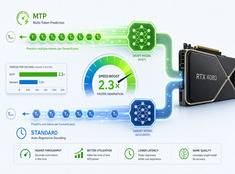
品質を落とさずにLLM推論を高速化する実践ガイド
70Bモデルは1回のフォワードパスで1トークンを生成し、各パスでVRAMから重みを読み込み、コンテキスト全体のAttentionを計算し、メモリを同期します。トークンの間では、GPUはシーケンシャルな依存関係が解決するのを待っている間にアイドル状態になります。

A2Aは死んでいません。単に普遍的ではないだけです。
GoogleのAgent2Agentプロトコル、一般的にA2Aと略されるこの規格は、最初の1年間で奇妙な展開をみせました。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
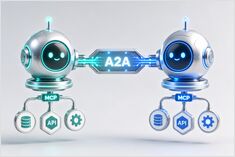
MCPはエージェントにツールを提供します。A2Aはエージェントに同僚を提供します。
AIエージェントのアーキテクチャは、2つのレイヤーに分裂し始めています。
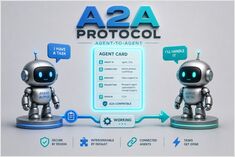
「A2Aはエージェントをネットワークピアに変換します。」
Agent2Agentプロトコルの略称であるA2Aプロトコルは、独立したAIエージェントシステム間の通信のためのオープン標準です。
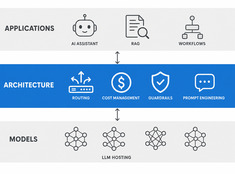
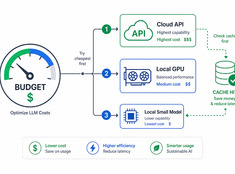
本当に重要な場所でトークンを活用しましょう。
LLMのコストは利用量に対して線形に比例して増加します。1日10,000リクエスト、1リクエストあたり0.01ドルで処理するシステムの場合、日額コストは100ドル、年間では365ドルになります。エンタープライズ規模では、それが1万ドルを超えます。
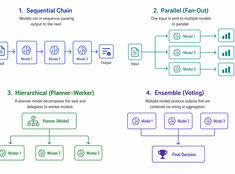
「機能する最もシンプルなパターンを選びましょう。」
シングルモデルのシステムはシンプルです。マルチモデルのシステムは強力です。課題はモデルを選ぶことではなく、それらを調整するアーキテクチャを設計することにあります。
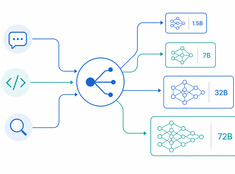
適切なタスクに最適なモデル。
700億パラメータのモデルを使って200語のメールを要約するのは無駄です。30億パラメータのモデルで本番環境のコードレビューを行うのは無謀です。多くのシステムはその中間に位置しており、そこがモデルルーティングの登場シーンです。
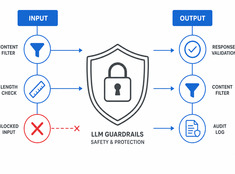
管理すべきはモデルではなく、リスクです。
LLM(大規模言語モデル)は予測不可能です。幻覚(ハルシネーション)を起こし、データを漏洩させ、有害なコンテンツを生成したり、正当なリクエストを拒否したりします。ガードレール(防護策)は、機能を損なわずにモデルの動作を制限します。
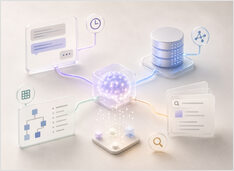
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
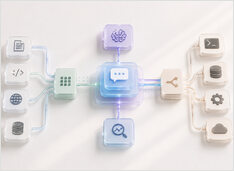
本格的なアシスタントは実際にどのように構築されているのか
本番環境向けのAIアシスタントは「プロンプト付きのLLM」ではありません。それは意図を受け取り、状態を保持し、いつ取得したり実行したりするかを決定し、障害のデバッグに必要なランタイムの詳細を公開するシステムです。
AIは知識管理の目的を変えず、手法を変革する。
AIは知識管理を置き換えるものではありません。むしろ、個人およびチームにとって知識管理の形そのものを変革しています。
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。