
Hermes Agentの振り返り:ローカルLLMによるセルフホスト型メモリ
ご自身のハードウェア上で永続的なHermesメモリを実現。
自己ホスティングされたAIエージェントには、単に長いコンテキストウィンドウがあるだけでは不十分です。有用な事実を保持し、以前の決定を参照し、プロジェクトが進化するにつれて自分の認識を更新するための手段が必要です。
Hermes Agentには組み込みのメモリファイルが付属していますが、外部プロバイダを使用することで、セッション間のより豊かな検索を行うことができます。Hindsightはその分野で比較興味深い選択肢の一つです。本ガイドでは、クラウド推論を使わずにHermes用のHindsightをインストールします。まずはオールインワンDockerコンテナとして、次に既存のPostgreSQLサーバーに対して独立したローカルモデルエンドポイントとして設定します。
本ガイドでは、デプロイ、ローカル埋め込みモデル・リランキングモデル・生成モデルの選択と接続、auto-retainがバンクに書き込む内容の制御、Hermesへの接続、および運用層(バックアップ、組み込みバンクの独立したPostgreSQLサーバーへの移行、日常的なバンクメンテナンス)を扱います。サンプルでは意図的なポートスキームを使用しています — メインのllama.cppサーバーが 8080、埋め込みが 8081、リランキングが 8082、Ollamaが 11434 です。これらは既存のポートに合わせて変更し、小規模なサーバーをメインモデルのポートと分離してください。
Hindsightの機能
Hindsightは永続的なエージェントメモリエンジンであり、3つの主な操作を持っています:retain(保持)、recall(想起)、reflect(考察)。retainは情報を抽出して保存し、recallはセマンティック、キーワード、グラフ、時間的検索を組み合わせ、reflectは蓄積されたメモリから回答を合成します。バックグラウンド統合により、重複する観察をより有用な知識層に変換できます。
これは単なる埋め込みデータベースではありません。ベクトルストアは類似の段落を特定できますが、メモリシステムはさらに、時系列、プロジェクトの境界、矛盾する証拠、決定の変化も保持しなければなりません。これらの障害モードについては、自己強化的メモリループで掘り下げられています。
より広い市場については、エージェントメモリプロバイダ比較を参照してください。Hermesの組み込み MEMORY.md、USER.md、およびメモリモードについては、Hermes Agentメモリシステムでカバーされているため、この記事では組み込み層の動作を理解していることを前提としています。
なぜMnemosyneを超えるのか
Hermes用Mnemosyneは、SQLiteストレージやハイブリッド検索を含む魅力的なローカルファーストのアイデアを提供します。実際には、インストール制約、バージョン互換性、書き込み承認の挙動、およびその4.0プレリリース周りの急速な変更により、予測可能に運用することが困難になり得ます。これらは運用上の懸念であり、Mnemosyneのメモリモデルが根本的に欠陥があるという証拠ではありません。
Hindsightも依存関係がゼロではありません:そのDockerイメージとローカルモデルは、相当なディスク領域を消費し得ます。そのAPIを独立したサービスとして実行し、推論を別の場所で行うことで、アップグレードとトラブルシューティングをエージェント本体から分離できます。
デプロイの選択
| コンポーネント | A: オールインワンコンテナ | B: 既存のPostgreSQLサーバー |
|---|---|---|
| Hindsight APIとUI | Dockerコンテナ | Dockerコンテナ |
| PostgreSQL | コンテナ内の組み込み pg0 |
既存のPostgreSQLマシン |
| 生成LLM | 外部llama.cpp | 外部llama.cpp |
| 埋め込み | デフォルトのローカルまたは外部 | 外部Ollamaまたはllama.cpp |
| リランキング | デフォルトのローカルまたは外部 | 外部リランクサーバー |
| 向いている用途 | 迅速な評価 | 長期稼働、独立したインストール |
ここで「オールインワン」とは、HindsightのAPI、UI、データベースが1つのコンテナに含まれることを意味し、推論LLMは依然として別の場所で作成されます。これは意図的なものです:Dockerの公式Hindsightイメージには、利用可能なローカル生成llama.cppサーバーはバンドルされていません。
別ホストで実行されているサービスには、localhost ではなくLAN到達可能なアドレスを使用してください。これらのポートは信頼できるクライアントに限定してください。例示の dummy キーは認証用のものではなく、互換性用のプレースホルダーです。
オプションA: オールインワンHindsightコンテナ
これは、HermesのVMにPython、Torch、ローカルモデルの依存関係を詰め込むことなく、Hindsightを評価する最も簡単な方法です。コンテナはHindsightと組み込みPostgreSQLを実行し、メインのllama.cpp LLMがメモリ抽出と考察を担当します。
ここでは2つのイメージタグが重要になります。 ghcr.io/vectorize-io/hindsight:latest は大きいイメージで、AMD64で約9 GBです — これはBGEエンコーダ、MiniLMリランカー、組み込みPostgreSQLをバンドルしているためです。 latest-slim は約500 MBで、これら2つのモデルが他所にあることを期待しています。これは、埋め込みとリランキングのセットアップを「ローカルモデルの提供と接続」で指示した後に望ましいものです。ヘルスチェックがパスしたら、特定のタグを固定してください:移動するタグは、保持を意図したデータベースには適していません。
HindsightホストにディレクトリとComposeファイルを作成します:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # Memory API
      - "9999:9999"  # Control-plane UI
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
WORKSTATION_IP をllama.cppを実行するホストに変更します。Linuxでは、上記に示す host-gateway マッピングをコンテナが宣言した場合のみ、 host.docker.internal が解決します。それがないと、 http://host.docker.internal:8080/v1 を基本URLにするとどこにも指しません。1 GBの共有メモリ予約は、組み込みPostgreSQLのインデックス作成に特に有用です:Dockerの小さなデフォルト /dev/shm は失敗を引き起こし得ます。名前付きボリュームは、コンテナが再生成されたときにデータベースを保持し、バインドマウントの代替案は、イメージ内のユーザーであるuid 1000によって所有されなければなりません。
HINDSIGHT_API_WORKER_ID は再生成をまたいで安定したままであるべきです — Dockerのデフォルトはコンテナホスト名であり、コンテナが死んだときに処理中だったタスクは、古いワーカーIDの下でスタックしたままになります。
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
インストールされているHindsightバージョンがヘルスチェックを別のパスで公開している場合は、 http://localhost:8888/docs とコンテナログを検査してください。コントロールプレーン通常は http://HINDSIGHT_HOST:9999 で利用可能です。基本的なデプロイメントが動作した後、コンテナ内でデフォルトモデルを読み込む代わりに、その埋め込みとリランキングプロバイダを「ローカルモデルの提供と接続」の設定に向けることもできます。
ポート 8888 や 9999 をインターネットに直接公開しないでください。 プライベートネットワークまたは認証付きリバーシプロキシを使用してください。組み込みPostgreSQLはテストには便利ですが、外部管理のデータベースはバックアップとメンテナンスが容易です。このボリュームに既に存在するバンクは、組み込みデータベースを専用サーバーに移動するでのダンプとリストアとともに移動します。
オプションB: 既存のPostgreSQLサーバーに対するHindsight
長期稼働のインストールでは、HindsightのAPI、データベース、推論エンドポイントを分離しておくことを優先します。HindsightのVMは重いモデルではなく、オーケストレーションとHTTPサービスを実行するため、小さく保てます。以下の手順は、空のサーバーに対して開始します。オプションAのボリュームに既に存在するバンクは、組み込みデータベースを専用サーバーに移動するで移動します。
PostgreSQLとpgvectorの準備
HindsightにはPostgreSQL 14以降と、 hindsight データベース内のベクトル拡張機能が必要です。拡張機能はデータベース単位です:サーバーにパッケージをインストールしても、そこで CREATE EXTENSION が実行されるまで何も起こりません。DebianまたはUbuntuのPostgreSQLサーバーでは、実際のPostgreSQLメジャーバージョンに一致する pgvector パッケージをインストールします。例えば、PostgreSQL 16の場合:
sudo apt update
sudo apt install postgresql-16-pgvector
パッケージ名と可用性は、設定したaptリポジトリに依存します。利用できない場合は、pgvectorインストール手順に従うか、PostgreSQL PGDGリポジトリから互換パッケージをインストールしてください。共有サーバーのPostgreSQLメジャーバージョンを盲目的に変更しないでください。PGDGのPostgreSQL 18パッケージでは、 pg_trgm と btree_gin は postgresql-18 に同梱されています。ディストリビューションのパッケージでは、それらのメジャーバージョンの postgresql-contrib にあります。組み込みデータベースはこれら両方に加え、 vector も使用します。
PostgreSQL管理者として、専用のロールとデータベースを作成します:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
新しいデータベースに接続し、拡張機能を有効にします:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
これらの拡張機能は通常、インストールに特権が必要です。アプリケーションロールがスーパーユーザーである必要はありません。Hindsightはデフォルトでpgvectorを使用し、反復ANNスキャンには0.8.0以降を望みます。古いサーバーはその設定を拒否します。 HINDSIGHT_API_VECTOR_EXTENSION で、 pgvectorscale (非常に大きなバンク用にHindsightが文書化しているDiskANNオプション)または vchord を選択することもできますが、これらは正確なPostgreSQLビルド上で追加のパッケージングが必要です。メモリが存在した後にアルゴリズムを切り替えると、起動が停止し、移行を要求されるため、最初のretainの前に選択してください。個人のHermesバンクの場合、pgvectorをインストールして、それで十分です。
pg_hba.conf でHindsightホストのみを許可します。例えば:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
PostgreSQLの listen_addresses を適切に設定し、ホスト間接続にはTLSまたは信頼できるプライベートネットワークを使用してください。このデータベースは、HindsightのDockerコンテナとは独立してバックアップしてください。サーバーが他のアプリケーションと共有されている場合は、Hindsightを専用のデータベースに保つか、 HINDSIGHT_API_DATABASE_SCHEMA を所有するスキーマに設定してください。デフォルトのスキーマは public です。
PostgreSQLに対してHindsightを実行する
HindsightのVMに compose.yaml を作成します。このバージョンは意図的にローカルでPostgreSQLを開始しません:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
外部データベースURLを .env という名前のファイルに格納します:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
パスワードに @、:、/、またはその他のリザーブURL文字が含まれる場合は、接続文字列に入れる前にURLエンコードしてください。Hindsight VMがPostgreSQLポート5432に到達できること、および pg_hba.conf がHindsightホストを許可していることをテストしてください — 127.0.0.1 のみにバインドされているサーバーは、URLが正しく見えても接続を拒否します。初回起動時にデータベースマイグレーションを実行するようにしてください:マイグレーションは HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false を設定しない限り、起動時に実行されます。APIとデータベースがアップしたら、Hermesを接続する前に、Hindsight用のモデルを選択するとローカルモデルの提供と接続に進んでください。
Hindsight用のモデルを選択する
デプロイは、APIとデータベースをネットワークに配置します。次の決定は、3つの推論役割を埋めるモデルです:recall候補用の埋め込み、それらを並べ替えるリランカー、およびretain、reflect、統合用の生成LLM。会話に既にGPUが使用されているCPU Hindsightホストの実用的なデフォルトは、プロセス内の Qwen/Qwen3-Embedding-0.6B、プロセス内の BAAI/bge-reranker-v2-m3、および生成作業用に共有するllama.cppチャットモデルです。
埋め込みモデル
Hindsightは起動時に埋め込み次元を読み取り、それに応じてバンクをサイズ設定するため、最初のretainで選んだモデルは、再構築するまでバンクが保持するモデルになります。ランキングボードの順位よりも、次元と指示の挙動の方が重要である:バンクが既に384次元または1024次元のものである場合、より強力な8Bエンコーダは移行の価値がありません。以下の行は、最も軽量なものから最も重いものへと並べられています。RAMの数値は、CPU上の概算のロード時のフットプリント(FP16 / 典型的なローカルロード)であり、GGUFファイルサイズではありません。
| モデル | パラメータ | 次元 | コンテキスト | ロード時 | 実行環境 | 備考 |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Hindsightデフォルト。 hindsight:latest に同梱。最速のローカルパス。スコア分布は、これを離れると多くの recall_min_scores デフォルトをキャリブレーションする必要があり続けます。 |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | 中間クラス英語BGE。768次元バンクを固定します。 |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Hindsight文書化された多言語MiniLM。BGE-smallと同じ384次元バンク幅で50以上の言語。 |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | onnx プロバイダのデフォルト。ONNXエクスポートがある場合の軽量な多言語CPUパス。 |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | 一般的なOllamaエンコーダ。古典的なBGEより長いコンテキスト、依然として英語優先。 |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2テキストのみ(ビジョン/オーディオ塔を無効化)。100以上の言語+コード。MRLで512/256/128に切り詰め可能。検索と文書の指示プレフィックス。フルマルチモーダルロードは740M。 |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPUまたはGPU | 強力な多言語デュアルエンコーダ。Qwen3-0.6Bと同じ幅なので、同じ次元のスワップでもフル再エンコードが必要です。 |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | このガイドのデフォルト。指示対応(クエリ側の検索指示)。CPUで快適。ローカルプロバイダは自動的に指示を適用しますが、OpenAI互換サーバーには HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX が必要です。 |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB 量子化 | GPU | Qwen3品質ティア。2560次元バンクを固定。対話GPUが既に飽和している場合は実現不可能。 |
モデルの実行方法は選択のもう半分かです。Hindsightの埋め込みプロバイダは、最も単純なものから多くの可動部品を持つものまで:
| プロバイダ | 実行方法 | 最適な状況 | 備考 |
|---|---|---|---|
local |
プロセス内SentenceTransformers。サイドカーなし | 単一のHindsightホスト、CPUエンコーダ | デフォルトパス。 HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL を設定。llama.cpp、Ollama、TEIなし。 |
onnx |
プロセス内ONNX Runtime | Torchより軽量なCPU。ONNXエクスポートがある | hindsight-api-slim[local-onnx] と HINDSIGHT_API_EMBEDDINGS_ONNX_* が必要。 |
openai / tei |
外部OpenAI互換またはHF TEIエンドポイント | APIプロセスから埋め込みを分離。共有GPU/CPUホスト | 「ローカルモデルの提供と接続」がOllama / llama.cpp / TEI用に構成するもの。分離または別マシンを望む場合にのみサイドカーの価値あり。 |
Qwen3-Embedding-0.6Bには外部埋め込みサービスは必要ありません。CPU Hindsightホストでは、 local プロバイダでAPIプロセス内にロードされます — Hugging Faceが初回起動時に重みをダウンロードし、プロバイダがモデルの検索指示をそれ自体が適用します:
# Compose環境(または同等の .env キー)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
エンコーダを別マシンに置きたかったり、APIプロセスから外したかったりする場合にのみ、外部OpenAI互換エンドポイントを使用してください。Ollamaはそのようなホストの一つです:
# 埋め込み: Ollama上のQwen3-Embedding-0.6B
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
推論マシンでの ollama list が示すものに合わせて、ホスト、ポート、タグを置き換えてください。
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX はプロバイダに依存します:
| パス | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
未設定/空のまま — プロセス内プロバイダがQwenの検索指示をそれ自体が適用 | 未設定/空のまま |
| 外部Ollama / llama.cpp / OpenAI互換 | 公式Qwen3検索指示( Query: 前に実際の改行) |
空のまま — 保存されたメモリは生テキストのまま |
| サーバーが既にQwenのテンプレートで入力ラップ | 両方を空のまま — それでないと指示が2回適用される | 空のまま |
外部パスの場合、以下を設定してください:
# Query:前に実際の改行。Bashの $'...' がそれを渡す信頼できる方法。
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
Compose YAMLでは同じ文字列に明示的な \n (またはリテラルのマルチライン値)が必要です。プレフィックスは最初のretainの前に設定してください:後に変更すると、古いベクトルと新しいクエリがもはや同じ空間に存在しなくなります。
ランキングボードの順位よりも多くのことを決める2つの特性があります。指示への感受性:Qwen3埋め込みはクエリ側に検索指示を適用します。OpenAI互換サーバーで一致するプレフィックスがないと、保存側とクエリ側がもはや同じ空間に存在しなくなります。次元ロック:幅は起動時に一度だけ読み取られるため、後で0.6Bから4Bへの移行はバンクの移行であり、設定変更ではありません — そして、同じ次元のスワップ(BGE-M3 ↔ Qwen3-0.6B、または768のEmbeddingGemma 2 ↔ nomic)でもベクトル空間が変わるため、バンクベクトルは自動的に再計算されません。新しいバンクまたは手動の再エンコード/再インデックスを計画してください。記憶バンクのエクスポート、インポート、移行を参照。BGE-smallを離れる後、新しいスコア分布に対して recall_min_scores を探査してください — BGE-smallでキャリブレーションされた閾値は、Qwen3-0.6Bに対して厳しすぎて、リランカーの候補を飢えさせる可能性があります。Qwen3ファミリのベンチマークとGGUF/Ollamaの背景については、Ollama上のQwen3埋め込みとリランカーモデルを参照してください。
リランキングモデル
埋め込みは候補セットを想起し、リランカーは各クエリ/段落対にスコアを付けて、Hindsightが注入する前に並べ替えます。 local プロバイダの場合、HindsightはSentenceTransformersクロスエンコーダ(またはサポートされる生成リランカー)をロードします。外部Cohere互換エンドポイントの場合、完全なCohereスタイルのボディを HINDSIGHT_API_RERANKER_COHERE_BASE_URL に投稿します。リランカーは任意ですが、エンコーダが固定されると、通常は最大のrecall品質レバーであり、CPUでは、recallの経過時間の大部分です。行は、最も軽量なものから最も重いものへと並べられています。
| モデル | パラメータ | 種類 | コンテキスト | 実行環境 | 備考 |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | クロスエンコーダ | 128 | CPU | Hindsightデフォルト。 hindsight:latest に同梱。約20の候補で1秒未満。重いBGEモデルが遅すぎる場合の名前付きフォールバックとして保持。 |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | クロスエンコーダ | 512 | CPU | 同じファミリー、より高い精度。依然として英語寄りのMS MARCO。 |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | クロスエンコーダ | 512 | CPU | Hindsight文書化された多言語MiniLMリランカー。 |
BAAI/bge-reranker-base |
278M | クロスエンコーダ | 512 | CPU | MiniLMからの適度なアップグレード。en/zh。よく議論される。v2-m3が既にレイテンシ予算に収まる場合はスキップ。 |
BAAI/bge-reranker-v2-m3 |
568M | クロスエンコーダ | 8k | CPUまたはGPU | CPUでの実用的な多言語デフォルト。約500メモリのバンクでは、20候補フロアで1回のrecallあたり約2.6–2.8秒(約140 ms/候補。recall時間の約93–99%)。候補キャップ20/40/80。フロアを20 → 10に下げると、リランクコストが約半分に。 |
Qwen/Qwen3-Reranker-0.6B |
0.6B | 生成(yes-token) | 32k | GPU推奨 | 指示対応、長いコンテキスト。ドロップインのクロスエンコーダではない:最近のSentenceTransformers生成リランカーサポートが必要で、llama.cpp /rerank スコアリングには既知の誤スコアバグがあります(hindsight-benchmarks#11)。採用前に検証。 |
BAAI/bge-reranker-v2-gemma |
2.5B | クロスエンコーダ | 8k | GPU推奨 | 強力な多言語品質。GPUが既に満杯の場合、数百メモリの個人バンクには過剰。 |
Qwen/Qwen3-Reranker-4B |
4B | 生成 | 32k | GPU | より高い品質のQwen候補。専用VRAMなしでは実現不可能。 |
Qwen/Qwen3-Reranker-8B |
8B | 生成 | 32k | GPU | ファミリ最上位ティア。同じ生成スコアリングの注意事項、さらに大きく。 |
クラウドAPIリランカー(Cohere、ZeroEntropy、Alibaba qwen3-rerank、TypeSafeなど)はHindsightで動作しますが、メモリテキストをボックス外に送信します。ローカルだけのクロスドメインレイアウトでは、スコープ外です。
選択を支配する2つの運用制約があります。VRAM:対話モデルがGPUを既に飽和させている場合(例えば、頭出しのない16 GBカード上のQwen3.8-27B Q5)、「GPU推奨」の行はすべて候補から外れ、現役の選択はCPU上のMiniLMまたはBGE-v2-m3に収束します。候補数: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (以下の外部エンドポイント例では30)は、モデルが再スコアリングする段落数を制限します。各候補は完全なフォワードパスであるため、モデルティアを上げる前にフロアをカットしてください。llama.cpp経由のQwen3では、GGUFはランキングヘッドを保持する必要があります — それをドロップする古い convert_hf_to_gguf.py は、すべての段落をゼロ付近でスコアリングします — そして、生成スコアリングパスが確認されるまで、正しい変換でも既知の良好/不良段落テストが必要です。
生成LLMティア
埋め込みとリランキングモデルは、メモリを抽出して推論するために使用される生成LLMの代わりにはなりません。HindsightはデフォルトLLMと操作固有の上書きをサポートし、同じllama.cppサーバーまたは独立したエンドポイントに向けられます。
| Hindsight操作 | 目的 | 実用的なモデルティア | Qwen例 |
|---|---|---|---|
| Retain | 事実、エンティティ、決定、時系列の抽出 | テストには4B最低。9B推奨 | Qwen3.5-4B / Qwen3.5-9B |
| Recall | セマンティック、キーワード、グラフ、時間的検索 | 生成LLM不要 | Qwen3-Embedding-0.6B + リランカー |
| Reflect | 取得されたメモリを統合して質問に回答 | 9Bから27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidation | 関連する事実の調整と圧縮 | 9B推奨 | Qwen3.5-9B / Qwen3.8-27B |
| Mental model refresh | より長期の合成理解の更新 | 9Bから35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
これらは運用上の推奨であり、公式のHindsight最小パラメータ数ではありません。小さいモデルはポート番号を正しく抽出できるかもしれませんが、以前のアーキテクチャ決定が取代されたことを見逃すかもしれません。構造化出力の信頼性と、否定の忠実な処理は、公称パラメータ数のみよりも重要です。Hindsight自身のデフォルトの温度は、そのままにしておく価値があります — retain用に 0.1、統合用に 0.0、reflect用に 0.9 — そして、retainと統合については、llama.cppビルドにあれば、非思考エイリアスをサービングする価値があります。なぜなら、小さいQwen3.5チェックポイントは思考モードで多くのトークンを費やすからです。
既存のQwen3.8-27B llama.cppエンドポイントを持つデプロイメントの場合、生成Hindsightタスク間でそれを低い並行度で共有することから始めてください:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
後で、例行的な抽出を独立した9Bモデルにルーティングし、27Bを困難な反映のために予約してください:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
小さい4Bモデルは経済的ですが、テストが必要です。9Bは品質/パフォーマンスの妥協として妥当です。retainと統合が小さいモデルを共有する場合は、 HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE を 2 に下げてください — デフォルトのバッチ8は、小さいコンテキストウィンドウにとっては長いプロンプトです。Qwen3.6-35B-A3Bは、個別に十分にプロビジョニングされた推論サーバーには魅力的です(これは約30億のアクティブパラメータを持つエキスパートの混合物モデルであり、小さいアクティブモデルとして予算計上してください)。一方、27Bの密集モデルは、すべての例行的なretainイベントに通常必要ありません。バックグラウンド並行度を制限することで、Hermes対話モデルをメモリメンテナンスの突発から保護します。
ローカルモデルの提供と接続
「モデルの選択」のプロセス内 local 埋め込みとリランカー設定で十分である場合、外部Ollamaとllama.cppのサブセクションをスキップして接続に飛ぶことができます — または、そこに示された local デフォルトのままComposeを置いておくこともできます。エンコーダまたはリランカーが別ホストにあるべき場合に、外部エンドポイントは重要になります。
外部埋め込み: Ollamaまたはllama.cpp
外部埋め込みは、Qwen3-Embedding-0.6B(または別のモデル)を別ホストに置きたい場合に使用します。2つの実用的な選択肢があります。モデル取得とサービングを少ない設定で扱うOllama、およびGGUF量子化、CPUスレッド、デバイス配置、バッチ処理を正確に制御するllama.cppです。両方のQwen3モデルのモデル背景とベンチマークは、Ollama上のQwen3埋め込みとリランカーモデルにあります。
Qwen3-Embedding-0.6Bは1024次元のベクトルを返却し、Hindsightはその幅を起動時に読み取り、データベースをそれに応じてサイズ設定します。バンドルの384次元BGEモデルで作成されたバンクは、このモデルを受け入れられません — 空のデータベースまたはボリュームから開始し、最初のretainの前に埋め込みモデルを決定してください。埋め込みプロバイダの後続の切り替えは、両方のモデルが同じ次元を使用しても、保存されたレコードの再エンコードを必要とします。
オプション1: Qwen3-Embedding-0.6B用Ollama
推論ホストに公式Linuxインストールドキュメントを使用してOllamaをインストールし、埋め込みモデルを開始します:
ollama pull qwen3-embedding:0.6b
ollama serve
リモートアクセスのために、サービス環境でOllamaの OLLAMA_HOST=0.0.0.0:11434 を設定し、サービスを再起動し、Hindsight VMにファイアウォールしてください。手順はOllamaリモートアクセスでカバーされています。 127.0.0.1 のみにバインドされたデーモンは、Hindsightコンテナからは見えません。最初に ollama list でモデル名を確認し、標準埋め込みエンドポイントをテストしてください:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
HindsightのOpenAI埋め込みプロバイダは、OllamaのOpenAI互換 /v1/embeddings エンドポイントを呼び出します。そのエンドポイントがOllamaバージョンで動作することを確認してから、Hindsightを設定してください。Ollamaは埋め込みには直截的ですが、そのAPIが互換のリランキングエンドポイントを提供すると仮定しないでください。 リランキングについては、以下のプロセス内 local BGEパスを優先するか、スコアを検証した後の独立したllama.cpp / TEIエンドポイントを使用してください。
オプション2: Qwen3-Embedding-0.6B用llama.cpp
検証済みのQwen3-Embedding-0.6B GGUF変換をダウンロードしてください。実際にダウンロードしたGGUFファイル名を使用してください:
#!/bin/sh
# start-embedding.sh - CPUオンリー埋め込みサーバー
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Qwen3埋め込みは、一部のBGEモデルが使用するCLSプーリングとは異なり、ラストトークンプーリングを使用します。大きい対話モデルがGPUを占有しているワークステーションで、絶対にCUDA初期化をさせたくない場合は、CPUオンリーのllama.cppビルドが好ましいです。この埋め込みサーバーで --reranking を有効にしないでください:その組み合わせは、ゼロのベクトルを取得する既知の方法です。
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
フル次元のQwen3-Embedding-0.6B出力には、1024個の浮動小数点数を含むべきです。GGUF変換とHindsightのクエリ/文書指示処理が互換であることを確認してください。指示感受性の埋め込みモデルは、誤ってプロンプトされたときに精度を失う可能性があります。
リランカー: ローカルBGEまたはllama.cpp経由のQwen3
リランキングは埋め込みとは異なり:モデルが各クエリ/文書対にスコアを付けて、関連性スコアを返します。CPUオンリーのHindsightホストでは — または、対話GPUにVRAMの余裕がない場合 — 実用的なパスは、 BAAI/bge-reranker-v2-m3 (またはより軽量なMiniLMデフォルト)を持つHindsightの local プロバイダです。サイドカーは不要です:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6Bは生成式yes-tokenスコアラーであり、古典的なクロスエンコーダではありません。ランキング用に設計されたGGUF変換でllama.cpp経由でサービングできますが、既知の良好/不良ペアでスコアを確認するまで、そのパスを実験的とみなしてください:ランキングヘッドをドロップする古い convert_hf_to_gguf.py は、すべての段落をゼロ付近でスコアリングし、llama.cppのネイティブ /rerank パスには、このファミリーに対する既知の誤スコア報告があります。
#!/bin/sh
# start-reranker.sh - --n-gpu-layersで選択されたGPUまたはCPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
CPUで実行するには --n-gpu-layers 0 を設定してください。GPUバージョンには、モデルの重みだけでなく、計算バッファとコンテキストのために追加のVRAMが必要です。ファイルサイズがGPU割り当ての総量であると仮定しないでください。
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
PostgreSQL文書は、無関係な文書より上位にランクされるべきです。すべての関連性スコアがゼロである場合、GGUFが誤った変換であることを意味し、事実が保存されていてもrecallはランダムに見えます。正確な results[].index と results[].relevance_score の形状を確認してください:HindsightはCohere互換のリランクレスポンスを期待し、llama.cppの互換性はビルド間で異なり得ます。
エンドポイントをHindsightに接続する
以下の環境設定をHindsightのComposeサービスに追加するか、その .env ファイルに格納してください。埋め込みパスは1つを選択してください — プロセス内 local、Ollama、またはllama.cpp — 一度に2つは選んではいけません。
# オプションA: Hindsightホストのプロセス内Qwen3(CPU。サイドカーなし)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# オプションB: llama.cpp埋め込みサービス
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# オプションC: 別ホストのOllama
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# オプション: ローカルBGEリランカー(サイドカーなし。CPUで推奨)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# オプション: llama.cpp Cohere互換リランクエンドポイント(最初にQwen3スコアを検証)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
変数名はプロバイダ固有であり、近いミスはサイレントになります: HINDSIGHT_API_EMBEDDINGS_BASE_URL は誤ったキーであり、Hindsightはローカルサーバーではなく、OpenAI自身の埋め込みエンドポイントを静かに狙います。 HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL を使用してください。Cohere互換リランカーパスでは、Hindsightは完全なCohereスタイルのボディを HINDSIGHT_API_RERANKER_COHERE_BASE_URL に投稿します。コンテナログに /v1/rerank/rerank の404が表示される場合、あなたのビルドはそれ自体で /rerank を付加し、値は /v1 で止めるべきです。
オプションBとCでは、埋め込みモデルからの HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX 値を使用してください(オプションAでは未設定のまま)。最初のretain後、実際のメモリでクエリから段落への検索をテストしてください。
記憶されるものの制御
スタックが稼働している状態で、次の障害モードは通常、書き込みパスです:Hermesはデフォルトで auto_retain: true なので、すべての会話ターンがバンクに抽出され得ます。誤った推測、破棄された計画、探索的な発言が検索可能な事実になり、後のrecallはそれを証拠として扱います — 自己強化的メモリループで説明されたループです。Hindsightを含む他のプロバイダのキャプチャポリシーの概要は、エージェントメモリプロバイダ比較にあります。
現在存在するキャプチャモード
「セッション合成」という名のHermesまたはHindsightのスイッチはありません。プラグインは、生の会話ターン(任意でバッチ化)を自動保持するか、提供する content で明示的な hindsight_retain ツール呼び出しを待つかのいずれかです。
| モード | Hermes / Hindsight設定 | 得られるもの |
|---|---|---|
| 連続 | auto_retain: true、 retain_every_n_turns: 1 |
すべてのターンが保持され、文字起こしテキストとして抽出される |
| バッチ自動 | auto_retain: true、 retain_every_n_turns を上げる |
ターンがプラグインでバッファリングされ、N番目のターンごとに、それらの生ターンを含む大きなretainペイロードが送信される — 依然として自動抽出であり、整理された要約ではない |
| 明示的なみ | auto_retain: false + ツール hindsight_retain |
エージェントが content (および任意の context / tags)でツールを呼び出すまで、何も保存されない |
バッチ自動はセッション要約ではありません。 retain_every_n_turns > 1 では、Hermes Hindsightプラグインはメモリ内でターンを蓄積し、会話JSONとして保持します。 /new、/reset、/branch、および同様のセッション切り替え時に、古いセッション文書の下で残留バッファをフラッシュします。専用のセッション末尾要約機能はなく、 N > 1 の場合、プラグインに on_session_end フックがないため、アイドルセッションの分解時にフラッシュされないバッファを落とし得てきました。このトレードオフを受け入れる場合を除き、 N: 1 を優先してください。
整理された「このセッションを覚えておく」は、プロンプト+ツールパターンであり、設定フラグではありません。 auto_retain: false を設定し、Hermesに永続的な決定を要約してそのテキストで hindsight_retain を呼び出すよう求める — または、エージェントのツールパス経由でツールを自分で呼び出す。バンクの reflect と 統合 は、既にバンクにあるものから合成するHindsightサーバー側の独立した操作であり、セッション末尾の書き込みの代わりにはならないし、Hermesの config.json キーで有効化されるものでもない。
auto_retain を false に設定すると、自動ターン保存が無効になります。各書き込みの前に人間の承認ダイアログを追加するわけではありません。エージェントは、ツールが許可する限り、いつでも hindsight_retain を呼び出すことができます。明示的なretainを、保留キューではなく、意図的なキャプチャとして扱ってください。
承認キューの欠落
共通の願望は、バンクに入る前にレビューして承認できる候補メモリの保留キューです。Hermes下のHindsightは、今日その契約を提供していません。Hermes用Mnemosyneは、いくつかのバージョンでプロバイダ固有の段階的書き込みを実装していますが、そのパスは共有されたHermes標準ではなく、Hindsightプラグインには適用されません。上流の承認フローが存在するまで、機能するパターンは、 auto_retain: false、意図的な hindsight_retain、そして次のセッションが悪事実を頼る前に、HindsightコントロールプレーンUIでの検査または削除です。Hindsightのために config.json で探すべき存在しない write_approval キーはありません。
バンキングの操舵(ミッション、ラベル、指令、メンタルモデル)
次の層を「ファインチューニング」と呼ぶ人々が多いです。Hindsightでは、Hermesの config.json 単体ではなく、主にバンキング構成です:ミッションと抽出設定がretainが保持するものを操舵し、ラベルがエンティティを構造化し、指令とメンタルモデルが後の合成を形状づけます。
| 制御 | 所在 | 助け方 |
|---|---|---|
Retainミッション (retain_mission / Hermes bank_retain_mission) |
バンキング構成 | 抽出に注入される「Xに注意し、Yを無視せよ」の平易な言語 |
抽出モード (concise、verbose、custom、…) |
バンキング構成 | concise(デフォルト)は長期に値する事実を保持。 custom は retain_custom_instructions 経由で組み込みルールを置き換え |
| エンティティラベル | バンキング構成 | retain時に制御された key:value 語彙 → グラフリンクと任意のタグ。検索構造を改善するが、誤った文をそれ自体で拒否しない |
| 指令(「ハードルール」) | バンキング指令API | reflect 中に強制される明示的な指示(タグスコープ)。合成を制約するが、書き込み承認ゲートではない |
| メンタルモデル | バンキングメンタルモデルAPI | 繰り返し質問への常時回答。一致するメモリからreflect経由で更新。派生的なため、悪いソース事実がそれらを毒する |
| Reflect / 観察ミッション | バンキング構成 | 合成と統合を操舵するが、生のretainの消防放水ではない |
ミッション、簡潔抽出、ラベルはノイズを減らし、検索を改善します。それらは、正確性が完全性よりも重要である場合に自動retainをオフにするのを置き換えません。永続的なプロジェクト決定を名付け、チャット事務を無視する短いretainミッションを優先してください。実在用語法がある場合のみエンティティラベルを追加してください。バンクが既にクリーンな事実を持つようになった後、2、3の繰り返し質問のためにメンタルモデルを追加してください。
推奨される衛生プロファイル
個人のHermesバンクのための具体的な出発点:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
バンクでretainミッションを設定し、抽出は concise モードのままにしてください(コントロールプレーンまたはBanks API経由)。明示的なretain後、UIを開き、観察を確認し、統合またはメンタルモデルリフレッシュが実行される前に誤りを削除してください。 recall_prefetch_method は recall のままにしてください — reflect は各ターン前にチャットモデル呼び出しを費やし、基礎事実ではなく合成を注入します。
Hermes AgentをHindsightに接続する
Hermes VMで、カタログプラグインをインストールし、セットアップウィザードを実行します。Hindsightと local_external モードを選択します。プラグインは組み込みPostgreSQLを開始したり、Hindsightモデルスタックをローカルで実行する必要はなく、 local_embedded を選ぶと、コンテナの横に2番目のHindsightデーモンを開始します。
hermes plugins install hindsight
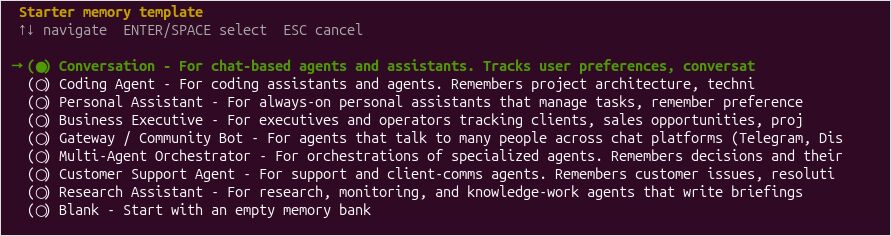
hermes memory setup hindsight
Hindsightを使用するエージェントロールの面白いセットのオプションがあります
hermes memory status
外部Hindsight接続は ~/.hermes/hindsight/config.json にあります。連続キャプチャ(Hermesデフォルト)を保持する例示的な設定:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
明示的なみのretainとバンキングの操舵のために、 auto_retain をオンに残す代わりに、記憶されるものの制御の衛生プロファイルを使用してください。 recall_sync: false は対話レスポンシブネスを優先しますが、次のターンで想起されたコンテキストを注入する可能性があります。現在のリクエストがモデルが答え始める前に最新のメモリを組み入れなければなりませんら、同期recallを使用してください。 retain_async: true はメモリが処理される間に通常の応答をブロックすることを避けます。
プラグインのrecallデフォルトは観察のみです。生の世界と経験の事実は、統合が観察を書き込むまで、または recall_types を observation,world,experience に広げるまで、バンクに留まりプロンプトの外にいます。最初の週それを広げ、コントロールプレーンを監視し、その後狭めることは、合理的な順序です。
組み込みHermesメモリは、プロバイダの横でアクティブのままにします。Hermesが何を加えるかを学ぶ間、 MEMORY.md と USER.md をオンにしておくのは良いことです。フラットファイルを残すべきかどうかを決定する場所は、メモリシステムの文章了です。
すでに実行中の場合は、ゲートウェイを再起動してください:
hermes gateway restart
hermes memory status
ステータスは、Hindsightがアクティブプロバイダであることを識別すべきです。HermesのTUIとプラグインコマンドを含む、より広いコマンドリファレンスについては、Hermes Agent CLIチートシートを参照してください。
インストールだけでなく、メモリを検証する
Hermesにテストプロジェクトの使い捨てな事実を覚えておくよう求め、別のセッションを開始し、その事実をもう一度尋ねてください。保持はデフォルトで非同期であり、抽出はチャットモデルを待つため、判断する前にメインのllama.cppサーバーに一瞬時間をください。その後、より困難なケースをテストしてください:Hermesに以前の決定が変わったと伝え、現在の決定と理由を尋ねてください。 memory status が取り込みとrecallが正しいことを証明すると仮定するのではなく、HindsightのUIと保存された観察を確認してください。
答えが空で返ってくる場合、モデルを変更する前にコントロールプレーンを検査してください。retainが成功しても、 recall_types が観察のみで統合が実行されていない限り、recallには見えないことがあります — recall_types の拡大が最初のチェックです。埋め込みサーバーログでの接続拒否は、コンテナが埋め込みポートに到達できないことを意味し、ゼロのリランカースコアは、GGUFが誤った変換であることを意味します。
書き込みパスの選択( auto_retain、ミッション、承認のギャップ)は、記憶されるものの制御でカバーされています。
トラブルシューティングと運用ノート
| 症状 | 考えられる原因 | 最初のチェック |
|---|---|---|
| Hermesがプロバイダ利用不可と言う | 誤った local_external URLまたはネットワークルール |
curl http://HINDSIGHT_VM_IP:8888/health |
| Dockerが開始し、PostgreSQLエラー | 拡張機能の欠如、誤った認証情報、または不十分な共有メモリ | コンテナログと pg_extension |
| 埋め込みが401または404を返す | 誤ったOpenAI互換URL、誤った環境キー名、またはモデルエイリアスの不一致 | 直接 /v1/embeddings テストと変数名 |
| リランキングが失敗 | エンドポイントまたはレスポンス形式の不一致。二重の /rerank パスを含む |
直接 /v1/rerank テストとコンテナログ |
| Recallが有用なものを返さない | recall_types が観察に限定、またはゼロのリランカースコア |
コントロールプレーン、次に recall_types、次にリランカー変換 |
| 既存のバンクが次元不一致を報告 | 埋め込みモデルが変更された | 一貫したモデルでベクトルを再構築/再インポート |
| Hermesの応答が遅くなる | 同期recallまたは共有LLMの競合 | 同期recallをオフ。retain並行度を制限 |
| 無関係なメモリが繰り返される | 弱い抽出、ノイジーな検索、または不十分な統合 | 観察と関連性スコアを検査 |
| PostgreSQLへの接続が拒否される | listen_addresses がまだlocalhost、またはクライアントが他のクラスタのポートを使用 |
データベースホストでの ss -lntp。 listen_addresses を変更後にそのクラスタを再起動 |
SSL接続の no pg_hba.conf entry |
クライアントアドレスの host または hostssl 行がない、または行に /32 がなくスキップされた |
行を追加し、リロードし、PostgreSQLログを読む |
pg_restore がダンプを開けない |
postgres ユーザーが、ファイルを保持するホームディレクトリに入れない |
ダンプを /tmp にコピーし、そこからリストア |
must be owner of extension btree_gin |
COMMENT ON EXTENSION がアプリケーションロールとして実行された |
空のデータベースを再作成し、 --no-comments でリストア |
PostgreSQL 18パッケージがインストールされ、 pg_lsclusters が14のみを表示 |
新しいメジャーは、既にクラスタが存在する場合、クラスタを作成しない | sudo pg_createcluster 18 main |
実用的な小さいデプロイメントは、PostgreSQLとすべての推論が外部である場合のHindsight API VMには2-4 vCPUと4-6 GB RAMです。ディスク割り当ては、選択したDockerイメージと保持されたイメージレイヤーに依然として依存します:拡大の余地を持って初期に約30-40 GBを割り当ててください。PostgreSQLホストは、実際のメモリ量、ストレージパフォーマンス、および提供している他のデータベースに基づいてサイズ設定してください。
Hindsightバンクのバックアップとリストア
メモリバンクは唯一の重要な状態であり、PostgreSQLにあります。オプションBでは、あなたが管理するデータベースです。オプションAでは、コンテナ内の名前付きボリュームの組み込み pg0 です。Hindsightコンテナとは独立してバックアップしてください — まずボリュームまたはデータベースを捕捉せずにコンテナを再生成すると、バンクを破棄し、 hermes backup は別サービスで実行されているバンクに到達しません。
オプションB — 外部PostgreSQL。 カスタム形式で hindsight データベースをダンプし、アーカイブを信頼する前に、スクラッチデータベースにリストアして検証してください:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# ダンプが使用可能であることを証明するためにスクラッチデータベースにリストア
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
元のダンプターゲットを削除する前に、リストアされたコピーにpgvector拡張機能とサンプルrecallが存在することを確認してください。ダンプはHindsight VMとは別のホストに保管し、PostgreSQL管理者(データベースを作成できるロール)として実行し、アプリケーションロールとして実行しないでください。
オプションA — オールインワンコンテナ。 組み込みデータベースは名前付きボリュームなので、コンテナを停止し、使い捨てイメージを通じてボリュームをtarしてください:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
tarコンテナ内のマウントポイント( /data )は任意です。単に、名前付きボリュームを別名にすることで tar がそれを読み取れるようにするだけです。同じボリュームにリストアするには、コンテナを停止し、ボリュームをクリアし、アーカイブを再びそこにuntarしてください。そのバンクをあなたが管理するサーバーに移すのは、組み込みデータベースを専用サーバーに移動するでのダンプとリストアです。
カレンダースケジュールではなく、3つの瞬間にスナップショットを撮影してください:埋め込みモデルを変更する前に、HindsightまたはPostgreSQLの主要アップグレードの前に、バンクを書き換える reflect または統合パスの前に。スクラッチバンクにリストアされたバックアップは、単に書き込まれたバックアップよりも価値があります。
組み込みデータベースを専用サーバーに移動する
オールインワンバンクは、 /home/hindsight/.pg0 にマウントされた名前付きボリュームです。 HINDSIGHT_API_DATABASE_URL を設定すると、そのコンテナはURLに名前の付いたデータベースを開き、マイグレーションを実行します。ボリュームは不変です。 pg_dump と pg_restore で行を移動し、その後同じコンテナを保持し、新しいサーバーに向けます。
インストールガイドは、組み込みpg0と外部URLを、空のサーバーを開始する2つの方法として説明します。hindsight-admin バックアップとリストアは、データベース間のテーブルをコピーします。 restore はターゲットスキーマを切り詰める必要があり、まずテーブルが存在する必要があります。記憶バンクのエクスポート、インポート、移行は、埋め込みモデルの変更です:そのアーカイブはベクトルを残し、目的地がそれらを再計算します。同じ埋め込みモデルを保持する移動は、ベクトルを保持し、 pg_dump はそれらを運ぶファイルです。
コンテナ内のメジャーバージョンを一致させる
pg0は、コンテナ内で 127.0.0.1:5432 でリッスンします。そのバイナリは /home/hindsight/.pg0/installation/<version>/bin の下にあり、クラスタデータは /home/hindsight/.pg0/instances/hindsight/data です。ロール、パスワード、データベース名はデフォルトで hindsight です。そのクライアントでサーバーバージョンを読み取ります。 ls /home/hindsight/.pg0/installation が別のビルドを示す場合、 18.1.0 の代わりにそのディレクトリを使用してください:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
そのサーバーからのカスタム形式ダンプは、同じメジャーバージョンまたは新しいものにリストアできます。現在の ghcr.io/vectorize-io/hindsight:latest イメージはPostgreSQL 18.1を報告します。Ubuntu 22.04のアーカイブパッケージはPostgreSQL 14であり、18アーカイブを読み込めません。
ディストリビューションクラスタの隣に、PostgreSQL Aptリポジトリから18をインストールします。 14/main が既に存在する場合、 postgresql-18 パッケージはクラスタを作成しません:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters は、14がまだ5432にある場合、次に利用可能なポート、5433で 18/main を表示すべきです。そのポートの SELECT version(); はPostgreSQL 18を報告すべきです。 postgresql-contrib-18 は移行パッケージ名です:aptは postgresql-18 を選択し、そのパッケージには pg_trgm と btree_gin が含まれています。
PostgreSQLとpgvectorの準備からロール、データベース、拡張機能を作成し、すべての psql に -p 5433 を渡して、コマンドが18クラスタに命中するようにしてください。組み込みデータベースには vector、 pg_trgm、 btree_gin があります。ソースより新しいpgvectorパッケージ、例えばサーバーの0.8.7に対してイメージの0.8.5、それでもダンプを受け入れます。
コンテナがそのポートに到達できるようにする
新しいクラスタは、 /etc/postgresql/18/main/postgresql.conf の listen_addresses にLANアドレスまたは * が含まれるまで、localhostでリッスンします。その設定は18クラスタが開始したときに適用されるため、 sudo pg_ctlcluster 18 main restart で再起動し、 0.0.0.0:5433 の ss -lntp を確認してください。別ホストからの「接続拒否」は、そのアドレスとポートでTCPを受け付けていないことを意味します。
/etc/postgresql/18/main/pg_hba.conf で、Hindsightホストを許可します。マスクは行の一部です。 /32 がないと、PostgreSQLは起動時にその行をスキップします。
host hindsight hindsight HINDSIGHT_HOST_IP/32 scram-sha-256
host は、クライアントがデフォルトで開くSSL接続に一致します。 sudo pg_ctlcluster 18 main reload でリロードしてください。続く「no pg_hba.conf entry … SSL encryption」エラーのアドレスは、その行に書くべきアドレスです。Dockerから、そのアドレスはコンテナを実行するホストです:ブリッジはコンテナの送信接続をホストのLANアドレスに変換します。
ダンプし、18クライアントでリストア
ライターを一時停止し、pg0バイナリでダンプします。 pg_dump がスナップショットを開いた後に保持された行は、アーカイブに欠如します。
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
データベースホストで、 pg_restore は18バイナリでなければなりません。14クライアントはこのアーカイブを読み込めません。最初にファイルを /tmp にコピーします。 postgres システムユーザーは別のユーザーのホームディレクトリに入れないため、 pg_restore は、 ls -l でワールドリーダブルと表示されるダンプで「Permission denied」を報告します。
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight は、リストアされたテーブルがアプリケーションロールに属するようにします。 --no-comments は COMMENT ON EXTENSION をスキップします。スーパーユーザーが拡張機能を作成し、アプリケーションロールが作成しなかった場合、「must be owner of extension btree_gin」で失敗します。 --single-transaction は失敗したロードを取り消し、次の実行が空のスキーマから開始できるようにします。以前の試行が残した部分的なロードは、再試行前に DROP DATABASE と3つの CREATE EXTENSION 文句が必要です。
SELECT bank_id FROM banks ORDER BY 1 と SELECT count(*) FROM memory_units を、切り替え前にコンテナ内で実行された同じクエリと比較してください。
コンテナを切り替え、ボリュームを保持
オプションBのCompose .env にURLを追加し、18クラスタが実際にバインドしたポートを使用します:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:URL_ENCODED_PASSWORD@POSTGRES_IP:5433/hindsight
それをサービス環境に HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL} として渡します。 HINDSIGHT_API_WORKER_ID は不変に保ちます。サービスが HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL または HINDSIGHT_API_RERANKER_LOCAL_MODEL を設定する場合、 ghcr.io/vectorize-io/hindsight:latest に留まります。 latest-slim は、コンテナ外で実行される埋め込みとリランキングエンドポイント用のオプションBのイメージです。 hindsight-pg0 ボリュームのマウントを離してはいけません。
docker compose up -d はコンテナを再生成します。ログは「Connecting to database」行で POSTGRES_IP を名乗るべきで、 curl -f http://localhost:8888/health は "database":"connected" を含むべきです。 GET /v1/default/banks はリストアされたバンクを列挙します。既に保存した事実を想起してください。公開されたAPIとUIポートは同じなので、Hermesとコーディングエージェントの設定は既存の基本URLを保持します。
HINDSIGHT_API_DATABASE_URL なしで再起動すると、URLが設定された間に書き込みを受けなかったボリュームを使用します。そのrecallが成功した後に、ボリュームを削除してください。コンテナが接続した後に、 pg_hba.conf を単一ホスト行に絞り、リロードしてください。
記憶バンクのエクスポート、インポート、移行
組み込みバンクを専用サーバーに移し、既に保存されたベクトルを保持することは、組み込みデータベースを専用サーバーに移動するでカバーされています。以下の手順は、埋め込みモデルの変更です。
埋め込みモデルの変更は、設定の編集ではありません。バンクのベクトルは古いモデルで計算され、別のモデル — 例えばバンドルの384次元BGEエンコーダ対1024次元Qwen3-Embedding-0.6B — は異なる空間に、通常は異なる幅に書き込みます。既存のインスタンスを新しいエンコーダに向き直して古いベクトルを保持することはできません。次元は、新しい埋め込みモデルですべてのメモリを再エンコードして再計算されなければなりません。
エンコーダとその設定はHindsightインスタンスごとに設定されるため、クリーンなパスは、既にrecallを提供しているものの中でベクトルを再構築するのではなく、新しい埋め込み設定で新しいインスタンスを立て、そこへバンクを移行することです。Hindsight APIはバンクを動かすこともできますが、一回きりの変更では、エクスポート/インポートがより容易で、より検査可能なルートです:
# 古いインスタンスからバンクをエクスポート
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# 新しいインスタンスにバンクをインポート
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t は、新しいインスタンスにそれを出荷する前にアーカイブを検証します。インポート後、 ~/.hermes/hindsight/config.json で新しいインスタンスの api_url へHermesを向き直し、ゲートウェイを再起動し、以前のメモリ検証を実行してください:保持された事実は、新しいエンコーダを通過して想起されるべきです。新しいインスタンスが動作するまで、古いバンクとそのベクトルを古いインスタンスに留めておき、まだ動作するフォールバックを持つようにしてください。
監視、剪定、バンクを安定に保つ
バンクが稼働している状態で、日常の作業は、抽出モデルが保存することにしたものを監視し、派生的状態をチェックしておくことです。 memory status が取り込みとrecallが正しいことを証明すると仮定するのではなく、コントロールプレーンUI( hindsight-embed -p hermes ui start )を使用して、観察、関連性スコア、統合出力を検査してください。重複または古いメモリは通常、弱い抽出または実行不足の統合なので、検索を拡大する前に、抽出ティアまたは統合頻度を修正してください。
バンクを頼る前にテストすべき2つのメンテナンスの罠があります。第一に、観察を削除しても、すべての派生的表現がそれと消えることを保証しません — それから構築された reflect 事実またはグラフエッジは、削除後も生き残る可能性があるため、同じソースの懸念をカバーする自己強化的メモリループと同様に、削除を端から端まで検証してください。第二に、 HINDSIGHT_API_WORKER_ID を再生成をまたいで安定に保ち、特定のイメージタグを固定してください:コンテナが死んだときに処理中だったタスクは、古いワーカーIDの下でスタックしたままになり、移動するタグは、保持を意図したデータベースには適していません。
