Cosa accade effettivamente quando esegui Ultrawork.
Oh My Opencode promette un “team virtuale di sviluppatori AI” — Sisyphus che orchestra specialisti, compiti eseguiti in parallelo e la magica parola chiave ultrawork che attiva tutto.
Conoscete Sisyphus e il suo team di agenti specialisti.
Il salto di capacità più significativo in OpenCode deriva dagli agenti specializzati: una separazione deliberata tra orchestrazione, pianificazione, esecuzione e ricerca.
Installa Oh My Opencode e rilascia più velocemente.
Oh My Opencode trasforma OpenCode in un harness per la programmazione multi-agente: un orchestratore assegna il lavoro ad agenti specializzati che si eseguono in parallelo.
Test di OpenCode LLM — statistiche su codifica e accuratezza
Ho testato come funziona OpenCode con diversi LLM ospitati localmente su Ollama e llama.cpp, e per confronto ho aggiunto alcuni modelli gratuiti da OpenCode Zen.
Installazione da CLI, flag, modalità headless, modelli locali
OpenHands è un agente di coding open source che modifica file ed esegue comandi in un ambiente sandbox. Questo quickstart CLI è stato verificato il 26/10/2026 contro il pacchetto 1.16.0.
Esegui API compatibili con OpenAI in locale con LocalAI in pochi minuti.
LocalAI è un server di inferenza self-hosted e local-first progettato per comportarsi come un’API OpenAI plug-and-play per eseguire carichi di lavoro di IA sull’hardware proprio (laptop, workstation o server in locale).
llama.cpp è un motore di inferenza in C/C++ per modelli GGUF: llama-cli per la chat interattiva, llama-completion per prompt scriptizzati e llama-server per un’API HTTP compatibile con OpenAI.
L’Intelligenza Artificiale sta trasformando il modo in cui il software viene scritto, revisionato, distribuito e mantenuto. Dagli assistenti di codifica basati su IA all’automazione GitOps e ai workflow DevOps, gli sviluppatori si affidano ora a strumenti alimentati dall’IA in tutte le fasi del ciclo di vita del software.
Come installare, configurare e utilizzare OpenCode
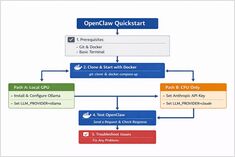
OpenCode è un agente di coding AI open source che puoi eseguire nel terminale (TUI + CLI) con superfici desktop e IDE opzionali. Questa è la Guida Rapida OpenCode: installazione, verifica, connessione a un modello/provider ed esecuzione di flussi di lavoro reali (CLI + API).
L’inferenza LLM sembra “un altro API” — fino a quando i picchi di latenza, le code si ingorgano e le tue GPU rimangono al 95% di memoria senza una spiegazione ovvia.
Temporal è un motore di workflow open-source di livello enterprise che consente agli sviluppatori di creare applicazioni di workflow durevoli, scalabili e tolleranti ai guasti utilizzando linguaggi di programmazione familiari come Go.
Strategia di osservabilità end-to-end per l'inferenza dei modelli linguistici di grandi dimensioni (LLM) e le applicazioni basate su LLM
I sistemi LLM falliscono in modi che il monitoraggio tradizionale delle API non riesce a rilevare: le code si riempiono in silenzio, la memoria GPU si satura molto prima che la CPU appaia occupata e la latenza esplode a livello di batching anziché a livello dell’applicazione.
Metriche, dashboard, log e allarmi per sistemi di produzione — Prometheus, Grafana, Kubernetes e workload AI.
Osservabilità è la base dei sistemi di produzione affidabili.
Senza metriche, dashboard e allarmi, i cluster Kubernetes si degradano silenziosamente, i carichi di lavoro AI falliscono in silenzio e le regressioni di latenza passano inosservate fino a quando gli utenti non si lamentano.
Dal RAG di base alla produzione: chunking, ricerca vettoriale, reranking e valutazione in un'unica guida.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.