LLM

PUAS pour LLM et puces d’inférence spécialisées (leur importance)

PUAS pour LLM et puces d’inférence spécialisées (leur importance)

Les ASIC et le silicium sur mesure boostent la vitesse et l’efficacité de l’inférence des LLM

L’avenir de l’IA ne concerne pas uniquement des modèles plus intelligents. Il s’agit également de la silice qui correspond à la manière dont ces modèles sont réellement servis. Le matériel spécialisé pour l’inférence LLM suit un chemin rappelant la transition du minage de Bitcoin des GPU vers les ASIC dédiés, avec des contraintes plus rigoureuses car les modèles et les recettes de précision continuent d’évoluer.
DGX Spark vs. Mac Studio : analyse détaillée des prix du supercalculateur personnel IA de NVIDIA

DGX Spark vs. Mac Studio : analyse détaillée des prix du supercalculateur personnel IA de NVIDIA

Disponibilité, prix de détail réels dans six pays et comparaison avec le Mac Studio.

NVIDIA DGX Spark est bien réel, en vente à partir du 15/10/2025, et destiné aux développeurs CUDA ayant besoin de travailler sur des LLM locaux avec un NVIDIA AI stack intégré. Le PPU aux États-Unis est de 3 999 $ ; le prix de détail en Royaume-Uni/Allemagne/Japon est plus élevé en raison de la TVA et des coûts de distribution. Les prix publics en AUD/KRW ne sont pas encore largement affichés.

Ollama et l’enshittification – les premiers signes

Ollama et l’enshittification – les premiers signes

Ma vision de l’état actuel du développement d’Ollama

Ollama est rapidement devenu l’un des outils les plus populaires pour exécuter des LLM localement. Son CLI simple et sa gestion de modèles optimisée en ont fait une option incontournable pour les développeurs souhaitant travailler avec des modèles d’IA en dehors du cloud.

Interfaces de chat pour les instances locales d'Ollama

Interfaces de chat pour les instances locales d'Ollama

Aperçu rapide des interfaces utilisateur les plus remarquables pour Ollama en 2025

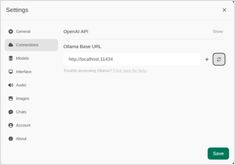
Localement hébergé, Ollama permet d’exécuter des modèles de langage sur votre propre machine, mais son utilisation via la ligne de commande n’est pas très conviviale.
Voici plusieurs projets open source qui proposent des interfaces du style ChatGPT qui se connectent à un Ollama local.