
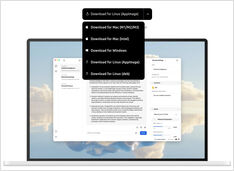
Frontends LLM
« Il n’y en a pas tant à choisir, mais quand même… »
Lorsque j’ai commencé à expérimenter avec les LLM, leurs interfaces utilisateur étaient en plein développement et aujourd’hui, certaines d’entre elles sont vraiment excellentes.
« Il n’y en a pas tant à choisir, mais quand même… »
Lorsque j’ai commencé à expérimenter avec les LLM, leurs interfaces utilisateur étaient en plein développement et aujourd’hui, certaines d’entre elles sont vraiment excellentes.
Test de détection des fautes de raisonnement
Récemment, nous avons vu plusieurs nouveaux LLM sortir. Des temps excitants. Testons-les et voyons comment ils se débrouillent lorsqu’ils détectent les fautes logiques.
Exige quelques expérimentations mais
Il existe toutefois quelques approches courantes pour rédiger des prompts efficaces afin que le modèle de langage ne se confonde pas en tentant de comprendre ce que vous souhaitez.
« 8 versions de llama3 (Meta+) et 5 versions de phi3 (Microsoft) »
Testons comment les modèles avec différents nombres de paramètres et de quantification se comportent.
Les fichiers de modèles LLM d’Ollama occupent beaucoup d’espace
Après l’installation d’Ollama, il est préférable de reconfigurer Ollama immédiatement pour les stocker au nouvel emplacement. Ainsi, lorsqu’un nouveau modèle est récupéré, il ne sera pas téléchargé à l’ancien emplacement.
Testons la vitesse des LLM sur GPU vs CPU
Comparaison de la vitesse de prédiction de plusieurs versions de LLMs : llama3 (Meta/Facebook), phi3 (Microsoft), gemma (Google), mistral (open source) sur CPU et GPU.
Testons la qualité de détection des fautes logiques de différents LLMs
Ici, je compare plusieurs versions de LLM : Llama3 (Meta), Phi3 (Microsoft), Gemma (Google), Mistral Nemo (Mistral AI) et Qwen (Alibaba).