
エンジニアのためのPARAメソッド:行動によって知識を整理する
トピックではなく、アクションでノートを整理する。
トピック別にノート整理するのは理にかなっているように思えます。しかし、PostgreSQLに関するノートが5つの異なるフォルダに散らばり、今日の課題に必要な特定のノートが見つからない状況に陥ると、その方法は通用しなくなります。
トピックではなく、アクションでノートを整理する。
トピック別にノート整理するのは理にかなっているように思えます。しかし、PostgreSQLに関するノートが5つの異なるフォルダに散らばり、今日の課題に必要な特定のノートが見つからない状況に陥ると、その方法は通用しなくなります。
衰えずに向上するノート。
工学に関するメモのほとんどは、一度書かれると忘れ去られます。デバッグセッションで得た知見を記録し、どこかに貼り付け、2年後に見つけたときには、なぜそれが重要だったのかという文脈が一切ありません。
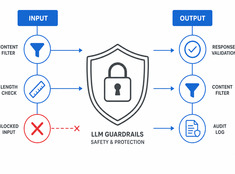
管理すべきはモデルではなく、リスクです。
LLM(大規模言語モデル)は予測不可能です。幻覚(ハルシネーション)を起こし、データを漏洩させ、有害なコンテンツを生成したり、正当なリクエストを拒否したりします。ガードレール(防護策)は、機能を損なわずにモデルの動作を制限します。
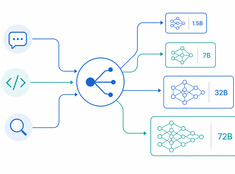
適切なタスクに最適なモデル。
700億パラメータのモデルを使って200語のメールを要約するのは無駄です。30億パラメータのモデルで本番環境のコードレビューを行うのは無謀です。多くのシステムはその中間に位置しており、そこがモデルルーティングの登場シーンです。
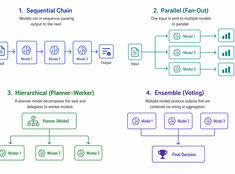
「機能する最もシンプルなパターンを選びましょう。」
シングルモデルのシステムはシンプルです。マルチモデルのシステムは強力です。課題はモデルを選ぶことではなく、それらを調整するアーキテクチャを設計することにあります。
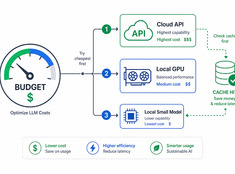
本当に重要な場所でトークンを活用しましょう。
LLMのコストは利用量に対して線形に比例して増加します。1日10,000リクエスト、1リクエストあたり0.01ドルで処理するシステムの場合、日額コストは100ドル、年間では365ドルになります。エンタープライズ規模では、それが1万ドルを超えます。
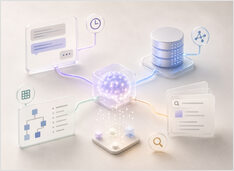
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
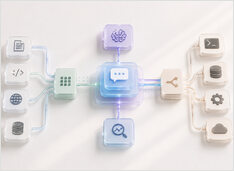
本格的なアシスタントは実際にどのように構築されているのか
本番環境向けのAIアシスタントは「プロンプト付きのLLM」ではありません。それは意図を受け取り、状態を保持し、いつ取得したり実行したりするかを決定し、障害のデバッグに必要なランタイムの詳細を公開するシステムです。
AIは知識管理の目的を変えず、手法を変革する。
AIは知識管理を置き換えるものではありません。むしろ、個人およびチームにとって知識管理の形そのものを変革しています。
開発者ナレッジグラフを構築する
開発者は通常、情報の不足に悩まされるわけではありません。むしろ、情報が過多であることに苦しんでいます。
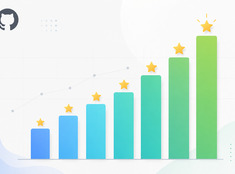
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。
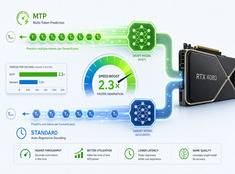
RTX 4080におけるMTPと標準デコーディングの比較 — 実ベンチマーク
RTX 4080(16 GB VRAM)環境で、Qwen 3.6 27Bおよび35Bにおける推論デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
検索は知識構造ではない
最新の知識システムのほとんどは検索(Retrieval)を最適化しています。それは理解できることです。検索は目に見えやすく、デモンストレーションも容易で、機能すると魔法のように感じられます。質問を入力すれば、答えが返ってきます。
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
現代の知識システムの地図
PKM、RAG、ウィキ、AIメモリシステム、そして今実用化が進むAI支援ワークフローは、しばしば同じ問題を解決するかのように論じられます。 しかし、実際にはそうではありません。 これらはすべて知識を扱いますが、動作するレイヤーは異なります。
システム、インフラ、AIエンジニアリングの新記事をお届けします。