
Sistema di memoria dell’agente Hermes: come funziona realmente la memoria persistente dell’AI
La memoria è la differenza tra uno strumento e un partner.
Lo sai già. Apri una chat con un agente AI, spieghi il tuo progetto, condividi le tue preferenze, completi un po’ di lavoro e chiudi la scheda. Rientri la settimana successiva ed è come parlare con uno sconosciuto: tutto il contesto è sparito, ogni preferenza è stata dimenticata, il progetto va spiegato di nuovo da capo.
Questo non è un bug. È il modo in cui i Large Language Models funzionano per progettazione. Sono stateless: ogni richiesta è indipendente, ogni risposta viene generata da qualsiasi prompt tu stia inviando in questo momento, senza memoria, senza storico e senza continuità al di fuori dei token nella finestra di contesto attuale.
Per interazioni a turno singolo, va bene così. Fai una domanda, ottieni una risposta, vai avanti. Ma per gli agenti — sistemi che dovrebbero fare cose tra sessioni, imparare dagli errori ed evolversi con te — la nature stateless è un limite architetturale rigido. È uno dei problemi centrali irrisolti nei sistemi AI self-hosted.
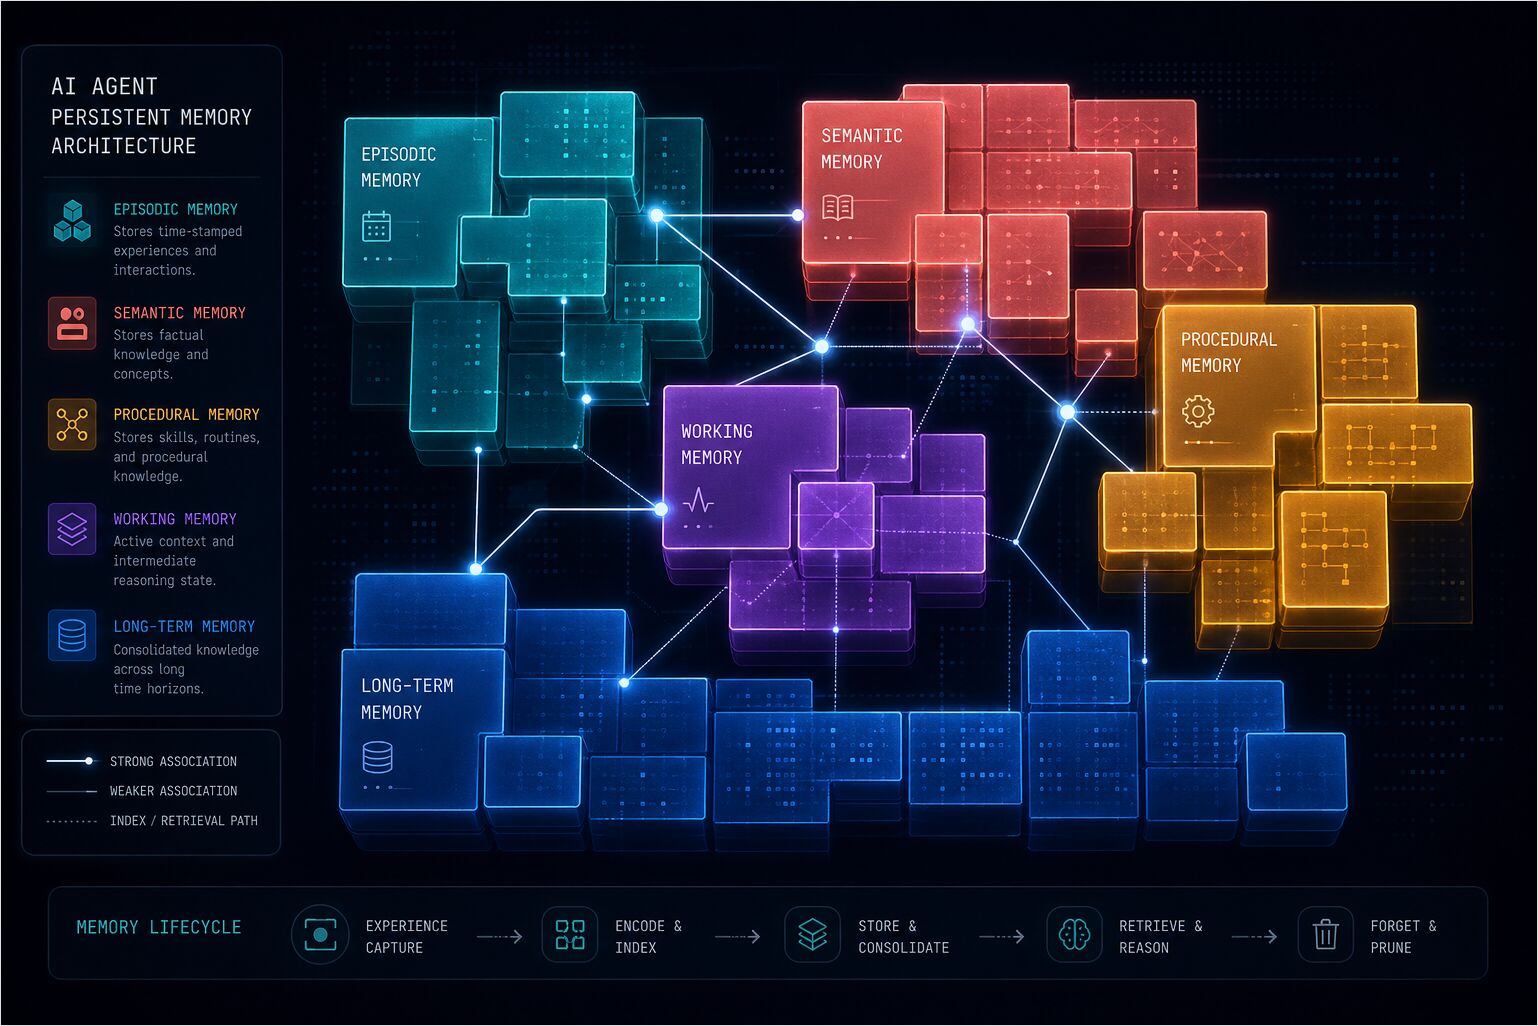
L’industria ha provato a risolvere questo problema. LangChain ha aggiunto moduli di memoria. OpenAI ha introdotto assistenti con thread. Framework come Letta, Zep e Cognee hanno costruito intere architetture attorno alla memoria persistente. Databricks ha pubblicato sulla “scalabilità della memoria” — l’idea che le prestazioni degli agenti migliorino con l’esperienza accumulata. Paper dedicati ai benchmark, survey sulla memoria episodica e un ecosistema di strumenti in rapida crescita sono emersi dal 2024 in poi per affrontare ciò che è sempre più riconosciuto come uno dei problemi centrali irrisolti nell’AI agentica.
La maggior parte di questi approcci condivide un problema comune: trattano la memoria come un’aggiunta a posteriori — un database da interrogare, una finestra di contesto da riempire, un sistema di retrieval che aggiunge latenza e rumore invece di chiarezza.
Hermes Agent adotta un approccio fondamentalmente diverso. La memoria non è qualcosa che l’agente ritrae quando serve. È qualcosa che l’agente è in ogni momento — integrata nel system prompt, curata, limitata e sempre attiva. È abbastanza piccola da essere veloce, abbastanza strutturata da essere utile, e abbastanza disciplinata da sapere cosa dimenticare.
Questo articolo spiega esattamente come funziona — lo strato specifico di Hermes all’interno del modello cross-framework in Sistemi di Memoria negli Assistenti AI e lo stack più ampio in Architettura degli Assistenti AI. Per i comandi di attivazione e ispezione (hermes memory, hermes dump, log tailing), abbinatela alla scheda rapida CLI di Hermes Agent. Per il lato complementare della “conoscenza a lungo termine” di Hermes—procedure riutilizzabili in SKILL.md invece che file di memoria curati—consulta Autore di Skill per Hermes Agent — Struttura e Best Practice di SKILL.md.
Parte 1: Il Problema della Memoria negli Agenti AI
Perché “Aggiungi Solo Contesto” Non Scala per gli Agenti
La soluzione ovvia per l’AI stateless è aggiungere contesto. Allega la conversazione precedente. Includi la documentazione del progetto. Invia l’intero storico.
Per un po’, funziona. Hai una finestra di contesto da 128K. Puoi farci entrare molto testo.
Ma il contesto non è memoria — c’è una differenza reale e importante tra i due. Il contesto è tutto ciò che ti viene mostrato in questo momento; la memoria è ciò che mantieni attivamente e porti avanti.
Il contesto non ha curatela. È un dump: man mano che cresce, il modello deve elaborare migliaia di token di storico irrilevante per trovare l’unico fatto di cui ha bisogno. Questo costa token e soldi, compounda la latenza e alla fine raggiunge il soffitto.
La memoria è curata. È la distillazione dell’esperienza in qualcosa di compatto e azionabile. Non cresce all’infinito — si consolida, si aggiorna e dimentica.
La memoria umana funziona allo stesso modo. Non ricordi ogni conversazione che hai mai avuto. Ricordi le parti che contano: con chi stai parlando, cosa gli sta a cuore, cosa avete concordato, cosa hai imparato. Il resto è o dimenticato o ricercabile quando serve.
Il Paesaggio della Ricerca
Lo spazio della memoria per agenti AI è esploso dal 2024, con suite di benchmark dedicate, una letteratura di ricerca in crescita e un gap prestazionale misurabile tra diversi approcci architetturali. Ecco dove siamo.
Letta (ex MemGPT) è stato uno dei primi framework a trattare la memoria persistente come una priorità primaria, raggiungendo 21,7K stelle su GitHub. Utilizza un modello a tre livelli ispirato al sistema operativo: memoria core (piccola, sempre nel contesto), memoria di recall (storico delle conversazioni ricercabile) e memoria archivistica (archiviazione a freddo a lungo termine). L’intuizione che non tutta la memoria è uguale era corretta. L’implementazione, tuttavia, richiede che gli agenti vengano eseguiti interamente dentro il runtime Letta — adottarlo significa adottare l’intera piattaforma, non solo uno strato di memoria.
Zep / Graphiti si concentra sulla memoria conversazionale con tracking temporale delle entità — i fatti hanno finestre di validità in modo che il grafico sappia quando qualcosa era vero. È forte per chatbot che necessitano di grafi di relazioni, meno adatto per agenti autonomi che tracciano fatti ambientali e convenzioni di progetto.
Cognee è costruito per l’estrazione di conoscenza da documenti e dati strutturati, con 30+ connettori di ingestione e un backend a grafico di conoscenza. Eccelle nella conoscenza istituzionale e nelle pipeline RAG ma è meno focalizzato sulla memoria personale dell’agente. Vedi Self-hosting di Cognee con LLM locali per una guida pratica alla configurazione.
Hindsight esegue il recall basato su grafi di conoscenza con relazioni tra entità e un unico strumento di sintesi reflect che esegue sintesi cross-memoria — combinando più memorie in nuove intuizioni. È tra i migliori performer nei benchmark di memoria per agenti ed è disponibile come provider di memoria per Hermes Agent.
Mem0 gestisce l’estrazione della memoria lato server tramite analisi LLM, richiedendo configurazioni minime. Il paper di ricerca di Mem0, pubblicato a ECAI 2025 (arXiv:2504.19413), ha eseguito il benchmark di dieci approcci distinti alla memoria AI e ha validato l’approccio di estrazione selettiva — memorizzare fatti discreti, deduplicare e ritrarre solo ciò che è rilevante. Mem0 è cresciuto fino a circa 48K stelle su GitHub e supporta 21 integrazioni di framework. Il trade-off è la dipendenza dal cloud e i costi.
La ricerca di Databricks sulla scalabilità della memoria ha introdotto il concetto che le prestazioni degli agenti migliorino con l’esperienza accumulata. La loro architettura mantiene system prompt, asset aziendali e memorie episodiche/semantiche scoping a livello di organizzazione e utente, validando l’idea che la qualità della memoria conti quanto la capacità del modello.
Il filo comune tra la maggior parte dei framework è che trattano la memoria come un problema di retrieval: memorizzarla da qualche parte, interrogarla quando serve, iniettarla nel contesto. Hermes fa l’opposto — la memoria non viene ritirata su richiesta, ma iniettata all’avvio della sessione e sempre presente. Sempre attiva, sempre disponibile, curata abbastanza da restare utile.
Parte 2: Architettura
Leggi questa parte dall’alto in basso — strati e recall/store per turno prima, poi cosa vive in MEMORY.md e USER.md, poi come collegare un provider esterno.
Due strati
Hermes impila la memoria in due strati:
- Integrato —
MEMORY.mdeUSER.md, supportati da file, sempre attivi. Limiti rigidi di 2.200 caratteri (note dell’agente) e 1.375 caratteri (profilo utente). - Un provider esterno (opzionale) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory e pari che abiliti via configurazione. Solo uno backend esterno gira alla volta. Aggiunge retrieval e ritenzione accanto ai file; non li sostituisce.
Il modello mentale è additivo — file core congelati più al massimo un plugin. Gli hook di prefetch e sync orchestrano lo strato esterno; i due file restano iniettati separatamente come parte del system prompt congelato.
Flusso runtime (prefetch e sync)
Il recall avviene prima che il modello risponda; la persistenza avviene dopo il messaggio dell’assistente. Nel memory manager di Hermes Agent questo si mappa a prefetch in entrata e sync in uscita. I nomi qui sotto corrispondono alla superficie di implementazione (MemoryManager, prefetch / sync_turn / queue_prefetch per provider).
Messaggio utente
    |
    v
MemoryManager.prefetch_all(query)        <-- fase di recall
    |
    +-- provider.prefetch(query)        <-- ogni provider esterno cerca nel suo store
    |
    v
Contesto iniettato nel turno LLM
    |
    v
LLM risponde (messaggio assistente)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- fase di store
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- ricerca di background verso il turno successivo
I file integrati MEMORY.md e USER.md non vengono recuperati tramite prefetch_all — fanno già parte del system prompt congelato. I backend esterni si collegano a prefetch_all / sync_all; queue_prefetch permette a un provider di riscaldare il retrieval per il turno successivo senza bloccare la risposta attuale.
Tre percorsi verso la memoria a lungo termine
-
Strumento
memoryintegrato. Il modello chiamamemoryconadd,replaceoremovequando le istruzioni indicano che qualcosa dovrebbe persistere — fatti duraturi, preferenze, correzioni, note ambientali.target='user'mantiene USER.md;target='memory'mantiene MEMORY.md. Forma d’esempio:memory(action='add', target='user', content='…'). -
Ritenzione passiva sui provider esterni. Ad ogni turno il framework invoca il percorso di sync del provider in modo che la conversazione possa essere segmentata, riassunta o estratta senza che il modello nomini ogni fatto. Il comportamento varia in base al backend — ad esempio Hindsight raggruppa i turni ed esegue ritenzione strutturata con entità e relazioni; Honcho invia il dialogo attraverso la sua pipeline dialettica; stack di tipo Mem0- e Supermemory estraggono i fatti passivamente dai turni.
-
Strumenti specifici del provider. Quando il plugin li espone, scritture esplicite come
honcho_conclude,hindsight_retainohoncho_profilememorizzano slice duraturi su richiesta.
Recall automatico rispetto agli strumenti dei provider
La memoria core non ha bisogno di uno strumento di lettura — è già nel prompt. I backend esterni aggiungono o l’iniezione automatica dal prefetch (nessuna chiamata a strumento di recall separato per quella fetta di contesto) o strumenti di retrieval espliciti (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect, e pari) quando il modello ha bisogno di una query più precisa del solo prefetch.
Modalità di recall (provider esterni)
I plugin supportano una modalità di recall configurabile (tipicamente recall_mode accanto a memory.provider nella configurazione) che scambia token per controllo.
| Modalità | Auto-iniezione dal prefetch | Strumenti del provider disponibili | Adattamento tipico |
|---|---|---|---|
| context | Sì | No | Senza intervento, contesto prevedibile |
| tools | No | Sì | Il modello sceglie quando ritrarre |
| hybrid | Sì | Sì | Contesto più ricco; uso di token più alto |
Quando non è impostato un provider esterno (memory.provider vuoto o non impostato), si applicano solo i file integrati e la ricerca di sessione — nessun prefetch/sync da plugin.
Percorsi su disco e budget
La memoria integrata di Hermes Agent vive in due file.
~/.hermes/memories/MEMORY.md— Note personali dell’agente (2.200 caratteri, ~800 token)~/.hermes/memories/USER.md— Profilo utente (1.375 caratteri, ~500 token)
Questa è l’intera superficie di memoria persistente: due file, meno di 3.600 caratteri totali, meno di 1.300 token. Sembra deliberatamente piccola perché lo è — e questo è esattamente l’intento di design.
MEMORY.md: Le Note dell’Agente
Qui è dove l’agente memorizza tutto ciò che impara sul suo ambiente, il progetto, gli strumenti, le convenzioni e le lezioni apprese. Ecco com’è:
Il progetto dell'utente è un microservizio Go in ~/code/gateway che usa gRPC + PostgreSQL
Questa macchina esegue Ubuntu 22.04, ha Docker e kubectl installati
L'utente preferisce snake_case per i nomi delle variabili ed evita camelCase
Queste non sono log. Sono fatti. Densi, dichiarativi, ricchi di informazioni. Nessuna data, niente fronzoli, niente “il 5 gennaio l’utente mi ha chiesto di…”
USER.md: Il Profilo Utente
Qui è dove l’agente memorizza tutto ciò che sa di te.
L'utente è uno sviluppatore full-stack a suo agio con TypeScript, Go e Python.
L'utente preferisce snake_case per i nomi delle variabili ed evita camelCase.
L'utente usa principalmente Linux Ubuntu 22.04.
L'utente deploya su AWS usando Terraform.
Identità, ruolo, preferenze, competenze tecniche, stile di comunicazione, pet peeves. Le cose che fanno sì che l’agente risponda in modo diverso a te rispetto a chiunque altro.
Il Pattern dello Snapshot Congelato
All’avvio della sessione, entrambi i file vengono letti dal disco e iniettati come blocco congelato nel system prompt. Ecco com’è:
══════════════════════════════════════════════
MEMORY (le tue note personali) [7% — 166/2.200 caratteri]
══════════════════════════════════════════════
Il progetto dell'utente è un microservizio Go in ~/code/gateway che usa gRPC + PostgreSQL
§
Questa macchina esegue Ubuntu 22.04, ha Docker e kubectl installati
§
L'utente preferisce snake_case per i nomi delle variabili ed evita camelCase
§
══════════════════════════════════════════════
USER PROFILE (chi è l'utente) [8% — 110/1.375 caratteri]
══════════════════════════════════════════════
L'utente è uno sviluppatore full-stack a suo agio con TypeScript, Go e Python.
§
L'utente preferisce snake_case per i nomi delle variabili ed evita camelCase.
§
Il formato usa intestazioni, percentuali di utilizzo, conteggi di caratteri e separatori § (segno di sezione). Le voci possono essere multiriga. È progettato per essere parsabile dal modello rimanendo leggibile dall’uomo.
Perché congelato? Prefix caching. Il system prompt è lo stesso in ogni turno di una sessione. Mantenendo la memoria statica dopo l’avvio della sessione, il modello può cacheare il calcolo del prefix e elaborare solo le parti variabili — la conversazione. Questa è un’ottimizzazione prestazionale significativa. Non stai ricalcolando l’attenzione sugli stessi token di memoria a ogni turno.
Le modifiche fatte durante una sessione persistono su disco immediatamente, ma appaiono nel system prompt solo all’avvio della sessione successiva. Le risposte agli strumenti mostrano sempre lo stato live, ma la “mente” del modello non cambia a metà sessione. Questo impedisce al modello di inseguirsi la coda — aggiornare la memoria e poi reagire al proprio aggiornamento nella stessa conversazione.
I Limiti di Caratteri come Funzionalità
2.200 caratteri. 1.375 caratteri. Questi non sono limiti arbitrari. Sono vincoli di design che forzino la curatela.
La memoria illimitata è un passivo. Incoraggia a buttare tutto dentro, a non consolidare mai e a diventare infine rumore. La memoria limitata forza l’agente a essere selettivo. Cosa è davvero importante? Di cosa avrò di nuovo bisogno? Cosa posso comprimere senza perdere significato?
Quando la memoria è piena, l’agente non fallisce silenziosamente. Riceve un errore con le voci correnti e l’utilizzo, poi segue un workflow:
- Leggi le voci correnti dalla risposta dell’errore
- Identifica le voci rimovibili o consolidabili
- Usa
replaceper unire le voci correlate in versioni più corte - Aggiungi la nuova voce
Questo è come la memoria resta utile. Non è un database. È una collezione curata di fatti che contano.
Sicurezza: Scansione per Prompt Injection
Ogni voce di memoria viene scansionata prima dell’accettazione. Il sistema blocca tentativi di prompt injection, esfiltrazione di credenziali, backdoor SSH e caratteri Unicode invisibili.
La memoria viene anche deduplicata. Le voci duplicate esatte vengono rigettate automaticamente. Questo impedisce agli avversari di provare a iniettare contenuti malevoli tramite invii ripetuti.
Provider di memoria esterni (attivazione e link)
Oltre ai MEMORY.md e USER.md integrati, Hermes Agent può collegare un plugin di memoria esterno alla volta — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover o Supermemory — per conoscenza persistente e cross-sessione. Solo un provider esterno è attivo alla volta; i due file core restano caricati accanto ad esso (additivo, non sostituzione).
Attiva e ispeziona i provider con hermes memory setup, hermes memory status e hermes memory off, oppure imposta memory.provider e recall_mode in ~/.hermes/config.yaml. I pattern di credenziali variano (ad esempio HINDSIGHT_API_KEY, chiavi Honcho sotto $HERMES_HOME/honcho.json); usa hermes memory setup per il cablaggio interattivo.
Forma YAML minima solo integrata:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Esempio di attivazione per un backend (sostituisci hindsight con honcho, mem0, supermemory o altri supportati dalla tua installazione):
memory:
  provider: "hindsight"
Per la tabella di confronto completa, note sulle dipendenze di LLM e embedding, analisi per provider e come questi backend si relazionano a OpenClaw e altri stack, vedi Confronto dei provider di memoria per agenti. Per un provider locale, self-hosted, con controlli di scrittura insolitamente granulari, vedi Mnemosyne per Hermes Agent: Avvio Rapido della Memoria Locale — e Loop di Memoria Auto-Rinforzanti negli Agenti AI per capire perché una memoria limitata e curata come la stessa MEMORY.md di Hermes aggira diverse modalità di fallimento dei feedback loop per costruzione.
Per il cablaggio specifico del profilo e i workflow di produzione, vedi Configurazione di produzione di Hermes Agent. Il hub Memoria dei Sistemi AI elenca questa guida più gli articoli correlati su Cognee e strato di conoscenza.
Parte 3: Quando la Memoria Attiva — Trigger e Decisioni
La domanda più comune sulla memoria di Hermes Agent è quando salva effettivamente qualcosa.
La risposta è: costantemente, ma selettivamente. L’agente gestisce la propria memoria tramite lo strumento memory, e la decisione di salvare è guidata da una combinazione di segnali espliciti e pattern impliciti.
Trigger di Scrittura: Quando l’Agente Decide di Salvare?
L’agente salva la memoria proattivamente. Non aspetta che tu glielo chiedi. Ecco cosa lo attiva.
Correzioni dell’utente. Quando correggi l’agente, è un segnale per ricordare. “Non fare così di nuovo.” “Usa questo invece.” “Ricorda questo.” Queste sono istruzioni esplicite per aggiornare la memoria.
Esempio: chiedi all’agente di configurare un ambiente Python. Suggerisce pip. Dici “io uso poetry per tutto.” L’agente salva: L'utente preferisce usare il gestore di pacchetti 'poetry' per tutti i progetti Python.
Preferenze scoperte. L’agente osserva pattern e deduce preferenze. Se usi costantemente uno strumento, framework o workflow specifico, viene salvato.
Esempio: dopo aver visto usare poetry più volte tra diversi progetti, l’agente lo salva come preferenza.
Fatti ambientali. Cose sulla macchina, sul progetto, sugli strumenti installati. Vengono scoperti attraverso l’esplorazione e salvati come fatti.
Esempio: l’agente controlla cosa è installato e salva: Questa macchina esegue Ubuntu 22.04, ha Docker e kubectl installati.
Convenzioni di progetto. Come è strutturato il progetto, quali strumenti usa, quali pattern segue. Vengono scoperti tramite ispezione del codice e salvati.
Esempio: Il progetto dell'utente è un microservizio Go in ~/code/gateway che usa gRPC + PostgreSQL.
Workflow complessi completati. Dopo aver completato un task che richiedeva 5+ chiamate a strumenti, l’agente valuta di salvare l’approccio come skill o almeno annotare cosa ha funzionato.
Particolarità e workaround degli strumenti. Quando l’agente scopre qualcosa di non ovvio su uno strumento, API o sistema — un limite, un workaround, una convenzione — lo salva.
Cosa viene saltato:
- Informazioni banali o ovvie
- Cose facilmente riscopribili
- Dump di dati grezzi
- Effimera specifica della sessione
- Informazioni già nei file di contesto (SOUL.md, AGENTS.md)
Trigger di Lettura: Quando l’Agente Ricorda?
La memoria non viene ritirata — c’è sempre. Ma ci sono diversi livelli di accesso.
Avvio della sessione (automatico). MEMORY.md e USER.md vengono iniettati nel system prompt. L’agente li ha dal primo token. Nessuna query necessaria, nessuna latenza, nessuna chiamata a strumento. Questa è la memoria core — sempre attiva.
session_search (su richiesta). Quando l’agente ha bisogno di trovare qualcosa da conversazioni passate che non è nella memoria core, usa lo strumento session_search. Questo interroga SQLite (~/.hermes/state.db) con ricerca full-text FTS5 e sintesi con Gemini Flash. Usalo quando la domanda suona come “ne abbiamo parlato prima” piuttosto che “ricorda questo fatto per sempre.”
Esempio: chiedi “Abbiamo discusso la rete Docker la settimana scorsa?” L’agente cerca nello storico delle sessioni e restituisce un riassunto della conversazione rilevante.
Strumenti dei provider esterni (quando configurati). Quando un provider di memoria esterno è attivo, il framework esegue anche un passo di prefetch automatico prima di ogni risposta (vedi Parte 2). Strumenti aggiuntivi come honcho_search, hindsight_recall o mem0_search sono per ricerche mirate quando l’agente sceglie il retrieval esplicito — a seconda di recall_mode, possono essere attivi l’iniezione automatica, gli strumenti, o entrambi.
L’Albero delle Decisioni
Ecco come l’agente pesa “vale la pena ricordare questo?”:
È una correzione o un'istruzione esplicita?
  SÌ → Salva nella memoria
  NO → È una preferenza o un pattern?
    SÌ → Salva nel profilo utente
    NO → È un fatto ambientale o una convenzione?
      SÌ → Salva nella memoria
      NO → È facilmente riscopribile?
        SÌ → Salta
        NO → È specifico della sessione?
          SÌ → Salta
          NO → Salva nella memoria
L’agente non ci pensa troppo. Salva proattivamente, consolida quando è pieno e si fida dei limiti di caratteri per mantenere le cose strette.
Parte 4: Memoria Interna vs. Basi di Conoscenza Esterne
Qui è dove spesso avviene la confusione. Hermes Agent ha memoria interna (MEMORY.md, USER.md, provider esterni) e basi di conoscenza esterne (LLM Wiki, Obsidian, Notion, ArXiv, filesystem), e servono ruoli completamente diversi. Questo è simile alla distinzione tra pipeline retrieval-augmented generation e memoria di lavoro dell’agente — il retrieval esterno è buono per ricerche di conoscenza profonda, non per portare identità e preferenze. La memoria interna è il cervello dell’agente — sempre attiva, curata, portata in ogni sessione. Le basi di conoscenza esterne sono la sua biblioteca — vaste risorse di riferimento consultate su richiesta.
La Distinzione
Memoria Interna (il cervello):
- Piccola, persistente, iniettata nel system prompt
- Contiene: preferenze utente, convenzioni dell’agente, lezioni immediate
- Sempre “nella mente” durante la conversazione
- Curata, limitata, gestita attivamente
- Esempi: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Basi di Conoscenza Esterne (la biblioteca):
- Vaste, solo di riferimento, accessibili su richiesta
- Contengono: documenti, paper, codice, note, database
- Accessibili tramite strumenti quando serve
- Non “ricordate” — cercate
- Esempi: LLM Wiki, Obsidian, Notion, ArXiv, filesystem, GitHub
Come Si Relazionano
L’agente accede alle basi esterne tramite strumenti quando serve. Non le “ricorda” — le cerca.
LLM Wiki (llm-wiki): La base di conoscenza Markdown interconnessa di Karpathy per costruire e interrogare conoscenza di dominio. L’agente usa la skill llm-wiki per leggere, cercare e interrogarla. È una risorsa di riferimento, non memoria.
Obsidian: Vault di note personali con link bidirezionali. L’agente usa la skill obsidian per leggere, cercare e creare note. Obsidian fa parte dell’ecosistema più ampio di gestione della conoscenza personale che Hermes può sfruttare come risorsa di biblioteca.
Notion/Airtable: Database e wiki strutturati accessibili via API. L’agente li interroga quando serve.
ArXiv: Repository di paper accademici. L’agente cerca ed estrae paper quando studia un argomento.
Filesystem: Codice del progetto, documentazione, configurazioni. L’agente legge i file quando lavora su un progetto.
Il Pattern di Distillazione
Ecco l’intuizione chiave: le intuizioni critiche dalle basi esterne possono essere distillate nella memoria interna.
Esempio: l’agente legge un paper da ArXiv sulla scalabilità della memoria per agenti AI. Non salva l’intero paper nella memoria. Salva l’intuizione chiave: Scalabilità della memoria: le prestazioni dell'agente migliorano con l'esperienza accumulata tramite interazione utente e contesto aziendale memorizzato nella memoria.
La risorsa esterna è vasta. La memoria interna è la distillazione.
Quando Usare Quale
Memoria interna per:
- “Chi sto aiutando?”
- “Cosa preferiscono?”
- “Cosa abbiamo appena imparato?”
- “Com’è la configurazione del progetto?”
- “Quali strumenti sono disponibili?”
Basi di conoscenza esterne per:
- “Qual è l’ultima ricerca su X?”
- “Cosa c’è nella documentazione del mio progetto?”
- “Cosa abbiamo discusso il mese scorso?”
- “Qual è l’API per questo servizio?”
- “Com’è la struttura del codice?”
L’agente capisce la differenza e usa ciascuno in modo appropriato — non confonde la ricerca di un documento con il ricordo di qualcosa che ha imparato su di te e il tuo ambiente.
Parte 5: Come Funziona Realmente
Diamo un’occhiata alle meccaniche.
Lo Strumento memory
L’agente gestisce la memoria tramite un unico strumento con tre azioni: add, replace, remove.
Non esiste azione read — il contenuto della memoria viene iniettato automaticamente nel system prompt. L’agente non ha bisogno di leggerlo perché è sempre lì.
add — Aggiunge una nuova voce.
memory(action="add", target="memory",
       content="L'utente usa macOS 14 Sonoma, usa Homebrew, ha Docker Desktop installato.")
replace — Sostituisce una voce esistente usando corrispondenza di sottostringa.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="L'utente preferisce light mode in VS Code, dark mode nel terminale")
remove — Rimuove una voce usando corrispondenza di sottostringa.
memory(action="remove", target="memory",
       old_text="fatto temporaneo del progetto")
Corrispondenza di Sottostringa
replace e remove usano sottostringhe uniche brevi tramite old_text. Non serve il testo completo della voce. Questo rende possibili edizioni chirurgiche senza conoscere il contenuto esatto.
Se una sottostringa corrisponde a più voci, viene restituito un errore che richiede una corrispondenza più specifica. L’agente affina poi la sua query.
Store di Destino: memory vs user
Il parametro target determina quale file viene aggiornato.
memory— Note personali dell’agente. Fatti ambientali, convenzioni di progetto, particolarità degli strumenti, lezioni apprese.user— Profilo utente. Identità, ruolo, fuso orario, preferenze di comunicazione, pet peeves, abitudini di workflow.
Gestione della Capacità
Quando la memoria è >80% piena, l’agente consolida. Unisce voci correlate, rimuove fatti datati e comprime le informazioni.
Buone voci di memoria sono compatte e dense di informazioni:
L'utente usa macOS 14 Sonoma, usa Homebrew, ha Docker Desktop installato. Shell: zsh con oh-my-zsh. Editor: Neovim con plugin Telescope.
Cattive voci di memoria sono vaghe o verbosi:
L'utente ha un progetto.
Il 5 gennaio 2026, l'utente mi ha chiesto di guardare il suo progetto che si trova in ~/code/gateway e usa Go con gRPC e PostgreSQL per lo strato di database.
La prima è densa e utile. La seconda è o troppo vaga o troppo verbosa.
Ricerca di Sessione vs Memoria Persistente
session_search e memoria persistente servono scopi diversi.
| Funzione | Memoria Persistente | Ricerca di Sessione |
|---|---|---|
| Capacità | ~1.300 token totali | Illimitata (tutte le sessioni) |
| Velocità | Istantanea (nel system prompt) | Richiede ricerca + sintesi LLM |
| Caso d’uso | Fatti chiave sempre disponibili | Trovare conversazioni passate specifiche |
| Gestione | Curata manualmente dall’agente | Automatica — tutte le sessioni memorizzate |
| Costo Token | Fisso per sessione (~1.300 token) | Su richiesta (cercato quando serve) |
Regola pratica: usa la memoria per fatti critici che dovrebbero sempre essere nel contesto. Usa la ricerca di sessione per ricerche storiche.
Parte 6: La Filosofia
Perché la Memoria Limitata Supera la Memoria Illimitata
L’istinto è rendere la memoria la più grande possibile. Memorizza tutto. Ritira ciò che ti serve.
La memoria limitata funziona meglio. Ecco perché.
La curatela forza la qualità. Quando hai spazio limitato, salvi solo ciò che conta. Comprimi, consolidi e priorizzi. La memoria illimitata incoraggia a buttare tutto dentro e a non ripulire mai.
La velocità conta. 1.300 token nel system prompt è veloce. 100.000 token ritirati da un database è lento. La memoria dovrebbe essere istantanea, non una query.
Il rumore degrada le prestazioni. Più memoria non è memoria migliore. È memoria più rumorosa. Il modello deve distinguere il segnale dal rumore, e questo richiede attenzione — attenzione che dovrebbe essere spesa sul task reale.
Dimenticare è una funzionalità. La memoria umana dimentica. Non è un bug — è come priorizziamo. Gli agenti dovrebbero dimenticare anche loro. Non tutto merita di essere ricordato.
Il Problema del “Dimenticare”
Gli agenti hanno bisogno di disimparare. Non solo dimenticare, ma attivamente rimuovere informazioni datate.
Ecco come Hermes Agent lo gestisce:
- Azione
remove: Elimina voci che non sono più rilevanti. - Azione
replace: Aggiorna voci con nuove informazioni. - Pressione sulla capacità: Quando la memoria è piena, l’agente consolida e rimuove vecchie voci.
- Scansione di sicurezza: Blocca voci malevole o corrotte.
Dimenticare non è fallimento — è manutenzione. Un agente che non sa disimparare porterà infine tanto rumore quanto segnale.
Scalabilità della Memoria
Databricks ha introdotto il concetto di “scalabilità della memoria”: un agente con migliaia di utenti esegue meglio di uno con un singolo utente?
La loro ricerca suggerisce di sì, ma con riserve. La scalabilità della memoria richiede:
- Estrazione di qualità: Non tutte le interazioni valgono la pena essere ricordate. L’agente deve estrarre intuizioni, non log.
- Ritiro efficace: Le memorie ritirate devono essere rilevanti. Il rumore degrada le prestazioni.
- Generalizzazione: Le memorie dovrebbero essere pattern, non specifiche. “L’utente preferisce Python” scala. “L’utente ha eseguito il comando X al timestamp Y” no.
La memoria limitata di Hermes Agent supporta naturalmente la scalabilità della memoria. Forzando la curatela, assicura che le memorie siano generalizzabili, compatte e utili.
Cosa Questo Significa per il Futuro
La memoria sta diventando la fossa di protezione competitiva nell’AI agentica — non il modello stesso, ma ciò che il modello porta tra le sessioni. Due agenti con modelli sottostanti identici possono eseguire in modo molto diverso: uno ricorda le tue preferenze, il tuo ambiente e i tuoi errori passati; l’altro parte freddo ogni volta.
La domanda non è più se gli agenti dovrebbero avere memoria persistente. È risolta: devono. La domanda aperta è come progettare bene quella memoria — cosa mantenere, cosa scartare, come renderla istantanea e come impedirle di diventare rumore.
La risposta di Hermes Agent è mantenere la memoria piccola, curata e sempre attiva — non un database da interrogare, ma un modello di lavoro dell’utente che l’agente porta con sé in ogni conversazione.
Conclusione
Il sistema di memoria di Hermes Agent è deliberatamente semplice: due file, limiti di caratteri rigidi, nessuna pipeline di retrieval, nessun database vettoriale, e nessuna latenza per query. Ciò che suona come un vincolo è tutto il punto.
Funziona perché tratta la memoria come funziona un cervello piuttosto che come funziona un database — piccola, curata e sempre attiva. L’agente non ritira la memoria quando ne ha bisogno; la memoria è semplicemente sempre lì, intrecciata nel system prompt dal primo token di ogni sessione.
I provider di memoria esterni estendono questo sistema per utenti che necessitano di più: grafi di conoscenza, supporto multi-agente, storage self-hosted, funzionalità enterprise. Ma il core resta lo stesso: limitato, curato, sempre disponibile.
E le basi di conoscenza esterne — LLM Wiki, Obsidian, Notion, ArXiv — servono un ruolo diverso. Sono la biblioteca, non il cervello. L’agente le cerca, non le ricorda. Le intuizioni critiche vengono distillate nella memoria interna; il resto resta nella biblioteca.
È così che un agente AI ti ricorda. Non memorizzando tutto, ma ricordando ciò che conta.
Hermes Agent è stato rilasciato da Nous Research nel febbraio 2026 e ha superato le 64.000 stelle su GitHub entro aprile 2026 (v0.9.0), con 242+ contributor. È open-source e disponibile su github.com/NousResearch/hermes-agent. Per guide su installazione, configurazione e workflow, vedi la panoramica di Hermes Agent.
