Llm

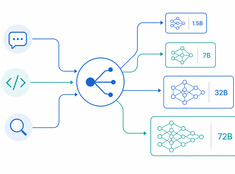
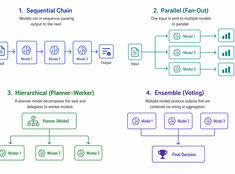
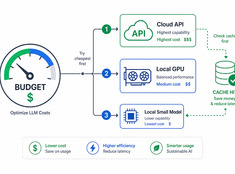
Aiguillage des modèles : cessez d’utiliser un seul modèle pour tout

Aiguillage des modèles : cessez d’utiliser un seul modèle pour tout

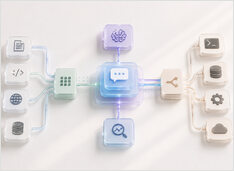
« Le bon modèle pour la bonne tâche. »

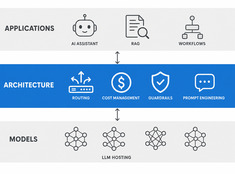
Exécuter un modèle de 70 milliards de paramètres pour résumer un e-mail de 200 mots est une dépense inutile. Utiliser un modèle de 3 milliards de paramètres pour relire du code en production est irresponsable. La plupart des systèmes se situent quelque part entre ces deux extrêmes — et c’est précisément là que le routage de modèles prend tout son sens.

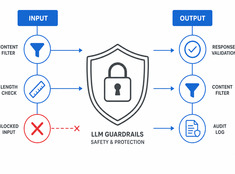
Les garde-fous des LLM en pratique : ce qui fonctionne réellement

Les garde-fous des LLM en pratique : ce qui fonctionne réellement

Contrôlez le risque, pas seulement le modèle.

Les LLMs sont imprévisibles. Ils hallucinent, fuient des données, génèrent du contenu nuisible ou refusent des demandes légitimes. Les garde-fous (guardrails) contraignent le comportement du modèle sans sacrifier ses capacités.

Systèmes de mémoire dans les assistants IA

Systèmes de mémoire dans les assistants IA

Mémoire de travail, structurée et de récupération pour les assistants.

La mémoire transforme les assistants d’entités réactives en entités persistantes, mais c’est aussi là que beaucoup de systèmes se dégradent silencieusement. Les enquêtes soutiennent que la distinction entre mémoire à court terme et mémoire à long terme n’est plus suffisante pour la mémoire des agents modernes ; les SDK d’OpenAI et de LangGraph pointent vers une pile plus simple — mémoire de travail, état durable et récupération.