
개발자를 위한 Claude Skills 및 SKILL.md: VS Code, JetBrains, Cursor
실무에서도 견고한 Claude 스킬 만들기
대부분의 팀은 Claude Skills를 두 가지 방식 중 하나로 오용합니다. SKILL.md 파일을 대충 내용을 쏟아 넣는 쓰레기통으로 만들거나, 거대하고 복사-붙여넣기 한 프롬프트에서 벗어나지 못합니다.
실무에서도 견고한 Claude 스킬 만들기
대부분의 팀은 Claude Skills를 두 가지 방식 중 하나로 오용합니다. SKILL.md 파일을 대충 내용을 쏟아 넣는 쓰레기통으로 만들거나, 거대하고 복사-붙여넣기 한 프롬프트에서 벗어나지 못합니다.
심각한 워크로드를 위한 프로파일 우선 Hermes 설정
공식적으로 Hermes Agent로 문서화된 Hermes AI 어시스턴트는 단순한 채팅 래퍼(wrapper)로 포지셔닝되지 않습니다.
가져둘 가치 있는 스킬과 건너뛸 스킬
OpenClaw에는 두 가지 확장이 있으며, 이들은 쉽게 혼동될 수 있습니다.
플러그인은 런타임을 확장합니다. 스킬(기술)은 에이전트의 행동을 확장합니다.
플러그인이 우선입니다. 스킬 명칭은 간략하게 표기합니다.
이 기사는 OpenClaw 플러그인에 대해 다룹니다. OpenClaw 플러그인은 채널, 모델 제공자, 도구, 음성, 메모리, 미디어, 웹 검색 및 기타 런타임 표면을 추가하는 네이티브 게이트웨이 패키지입니다.
실제 OpenClaw 시스템이 어떻게 구성되어 있는지
데모에서는 OpenClaw가 단순해 보입니다. 하지만 프로덕션 환경에서는 하나의 시스템으로 진화합니다.
클로드 구독은 더 이상 에이전트를 구동하지 않습니다
에이전트 실험의 물결을 이끈 조용한 루트가 이제 막혔습니다.
로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane 은 “인용된 AI 검색” 분야에서 더 실용적인 솔루션 중 하나입니다. 이는 실시간 웹 검색과 로컬 또는 클라우드 LLM 을 결합하면서도 전체 스택을 사용자의 통제 하에 두는 자체 호스팅형 답변 엔진입니다.
로컬 모델 백엔드를 갖춘 에이전틱 코딩
Claude Code는 마케팅만 뛰어난 자동 완성 도구가 아닙니다. 이것은 에이전트 기반 코딩 도구입니다. 코드베이스를 읽고, 파일을 편집하며, 명령을 실행하고, 개발 도구와 통합됩니다.
개발자를 위한 Hermes Agent 설치 및 빠른 시작
Hermes Agent은 로컬 머신 또는 저비용 VPS에서 구동되는 자체 호스팅, 모델 비의존적 AI 어시스턴트로, 터미널 및 메시징 인터페이스를 통해 작동하며 반복적인 작업을 재사용 가능한 스킬로 전환함으로써 시간이 지남에 따라 지속적으로 개선됩니다.
TGI 를 설치하고 빠르게 배포하며 더 빠르게 디버깅하세요.
Text Generation Inference(TGI) 는 매우 특유의 에너지를 지니고 있습니다. 추론 분야에서 가장 새로운 기술은 아니지만, 이미 프로덕션 환경에서 발생하는 문제를 잘 이해하고 있습니다.
llama.cpp의 16GB VRAM 기준 토큰 속도(표)
여기서는 16GB VRAM의 GPU에서 실행되는 여러 LLM의 속도를 비교하고, 셀프 호스팅을 위한 최적의 모델을 선택하는 과정입니다.
GPU 와 영속성을 갖춘 Compose 우선 Ollama 서버
Ollama 는 베어 메탈 (bare metal) 환경에서 훌륭하게 작동합니다. 이를 서비스처럼 다룰 때 더욱 흥미로운데, 안정적인 엔드포인트, 고정된 버전, 영구 저장소, 그리고 GPU 가 있거나 없는 명확한 상태를 보장받기 때문입니다.
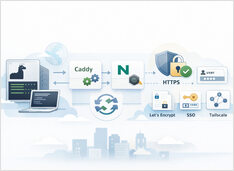
스트리밍 응답을 깨뜨리지 않고 HTTPS를 사용한 Ollama
리버스 프록시 뒤에 Ollama 를 실행하는 것은 HTTPS, 선택적 접근 제어, 예측 가능한 스트리밍 동작을 얻는 가장 간단한 방법입니다.
SGLang 로 오픈 모델을 빠르게 제공하세요.
SGLang 은 단일 GPU 에서 분산 클러스터에 이르기까지 저지연 및 고휘도 추론을 제공하도록 설계된 대규모 언어 모델 및 멀티모달 모델용 고성능 서비스 프레임워크입니다.
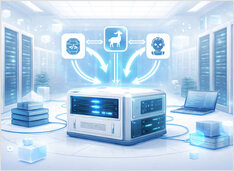
클라이언트를 변경하지 않고 로컬 LLM을 핫스왑합니다.
곧 vLLM, llama.cpp 등 여러 스택을 각각 다른 포트에서 관리하게 될 것입니다. 모든 다운스트림 시스템은 여전히 하나의 /v1 기본 URL 을 요구하며, 그렇지 않으면 포트, 프로필, 일회성 스크립트를 계속 조정해야 합니다. llama-swap은 이러한 스택들 앞에 위치한 /v1 프록시입니다.
대부분의 로컬 AI 세팅은 모델과 런타임부터 시작합니다.