
AI 에이전트의 자기 강화형 메모리 루프: 원인과 해결책
기억된 결론이 새로운 증거가 될 때
지속적 메모리는 에이전트를 매번 설명을 들어야 하는 도구에서 컨텍스트를 유지하며 나아가는 존재로 전환시켜 줍니다. 하지만 이는 무상태(stateless) 채팅이 피하는 실패 모드를 열어젖히기도 합니다. 해석(interpretation)이 메모리가 되어 사실처럼 검색되고, 이를 근거로 자신에 대한 더 강력한 버전의 정당화를 만드는 식입니다.
기억된 결론이 새로운 증거가 될 때
지속적 메모리는 에이전트를 매번 설명을 들어야 하는 도구에서 컨텍스트를 유지하며 나아가는 존재로 전환시켜 줍니다. 하지만 이는 무상태(stateless) 채팅이 피하는 실패 모드를 열어젖히기도 합니다. 해석(interpretation)이 메모리가 되어 사실처럼 검색되고, 이를 근거로 자신에 대한 더 강력한 버전의 정당화를 만드는 식입니다.
통제된 쓰기 기능을 갖춘 로컬 Hermes 메모리
Mnemosyne은 Hermes Agent를 위한 로컬 퍼스트(local-first) 메모리 프로바이더입니다. 워킹 메모리, 구조화된 사실, 시간 데이터, 그리고 에피소드적 역사를 로컬 SQLite에 저장하며, 호스팅된 서비스나 필수적인 네트워크 호출 없이도 유독 세밀한 수준의 쓰기(write) 제어를 제공합니다.
거부 상태가 없습니다. 다음은 임시 해결책입니다.
6개월 전 “영속성을 공유 라이브러리로 이동"을 제안하고 배포했던 에이전트는, 그 아이디어가 이미 검토되어 기각되었다는 것을 지속적으로 기록하는 것이 없다면 다음 분기에 같은 것을 다시 제안할 것이다 — 그리고 OpenSpec에는 현재 이를 위한 내장 상태가 없다.
40페이지짜리 PRD가 아닌, 델타(deltas) 형태의 스펙
OpenSpec은 Fission AI가 제공하는 무료 오픈소스 CLI 도구로, 코드가 작성되기 전에 사용자가 코딩 에이전트와 평범한 마크다운으로 변경 사항에 대해 합의할 수 있게 해줍니다. 무거운 스펙 기반 프레임워크의 단계별 복잡한 절차 없이 이를 가능합니다.
한 줄 import를 넘어선 안전한 전환
AI 어시스턴트 마이그레이션은 단순한 애플리케이션 설정 복사와는 다른 문제입니다. 가장 어려운 부분은 두 개의 게이트웨이가 동일한 봇으로 작동하지 않도록 하면서도, 정체성, 기억, 도구 동작, 예약된 작업, 그리고 메시지 접근 권한을 보존하는 것입니다.
LLM 이후의 시대: 트랜스포머 이후
AI 열풍에는 일정한 리듬이 있다: 대략 3년마다, 모두가 베팅하고 있는 아키텍처가 더 새로운 것으로 대체된다. 다음 전환은 이미 연구실에서 형성되고 있다.
스킬, MCP 서버, 아니면 둘 다?
에이전트 스킬과 MCP 서버는 종종 AI 에이전트를 확장하는 경쟁적인 방식들로 제시됩니다. 그러나 이 프레임은 틀렸습니다: 스킬은 에이전트가 어떻게 작업해야 하는지를 가르치고, MCP 서버는 라이브 기능에 대한 거버넌스된 접근을 제공합니다.
명령줄에서 OpenCode를 실제로 사용해 보기
OpenCode의 커맨드 라인 인터페이스(CLI)는 스크립팅, CI 파이프라인, 그리고 무인 에이전트 실행을 위해 설계되었습니다. 이 글은 일상 업무에서 CLI를 활용하는 실무 가이드입니다.
하나의 명령어로 설치되는 강제 SDD 기능
Superpowers는 설치 가능한 Claude Skills로 전체 스펙 주도 개발 방법론을 패키징하여, 브레인스토밍, 계획 수립, 서브에이전트 기반 구현, 엄격한 TDD를 강제함으로써 해당 구조를 사용자가 자유롭게 선택하도록 두지 않습니다.
사용자가 직접 형태를 만들어야 하는 작은 코딩 에이전트
Pi Coding Agent는 기본 도구 4개를 갖추고 있으며, 대부분의 동작을 확장, 스킬 및 사용자 자체 워크플로에 맡기는 최소한의 오픈소스 터미널 코딩 하네스입니다.
왜 당신의 AI 스택은 매월 더 끈적해지나요?
모든 API 호출은 단순한 트랜잭션처럼 느껴집니다. 하지만 그 호출들이 누적되면, 파인튜닝 데이터, 평가 시스템, 그리고 도메인 스키마가 모두 특정 벤더에 맞춰지게 되며, 이때부터 플랫폼 전환은 단순한 라우팅 변경을 넘어선다는 것을 깨닫게 됩니다.
소음이 발생하는 작업은 위임하고, 컨텍스트는 깨끗하게 유지하세요.
대부분의 Claude Code 세션이 느려지고 지저분해지는 이유는 동일합니다. 탐색적인 grep 실행, 로그 덤프, 그리고 “하나 더 확인해 보자"는 식의 파일 확인 작업들이 모두 메인 대화 창에 영구적으로 남기 때문입니다.
Ollama에서 vLLM으로 전환해야 하는 시점
Ollama는 로컬 언어 모델을 실행하는 가장 간편한 방법 중 하나이지만, 편리함은 로컬 실험이 더 나은 스케줄링과 관측 가능성이 필요한 공유 추론 서비스로 전환되는 순간을 가릴 수 있습니다.
컴파일된 지식의 신뢰성을 유지하세요
LLM 위키(Wiki)는 오래된 사실이 여전히 그럴듯해 보일 때, 모순이 정교하게 다듬어질 때, 그리고 생성된 요약이 원천 자료에서 벗어나면 실패합니다.
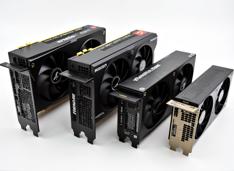
3개 벤더 간 AI GPU 비교
2026년 AI 하드웨어 시장은 크게 변화했습니다. NVIDIA, AMD, 인텔은 모두 로컬 대규모 언어 모델(LLM)과 AI 추론 워크로드를 처리할 수 있는 GPU를 필요로 하는 개발자들을 두고 치열한 경쟁을 벌이고 있습니다.
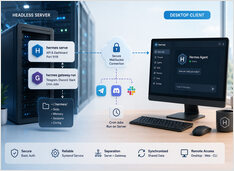
원격 데스크톱 액세스를 지원하는 Headless Hermes 서버
데스크톱 클라이언트에서 다른 머신의 헤드리스 서버에 Hermes 에이전트를 실행하고 연결하려면 두 개의 서버 프로세스와 하나의 클라이언트 연결이 필요합니다.