
Hermes 에이전트 메모리 시스템: 영속적 AI 메모리의 실제 동작 방식
메모리는 도구가 아닌 파트너를 만드는 차이점입니다.
AI 에이전트와 채팅을 시작하고, 프로젝트를 설명하고, 선호 사항을 공유하고, 작업을 마친 후 탭을 닫는 장면을 익히 보셨을 것입니다. 일주일 후 다시 돌아오면 마치 처음 만난 사람과 대화하듯 모든 컨텍스트가 사라지고, 모든 선호 사항이 잊혀 있으며, 프로젝트가 처음부터 다시 설명되어야 하는 상황이 됩니다.
이것은 버그가 아닙니다. 이는 대규모 언어 모델(LLM)이 설계적으로 작동하는 방식입니다. LLM은 무상태(stateless)입니다. 각 요청은 독립적이며, 각 응답은 기억, 역사, 그리고 현재 컨텍스트 윈도우 내의 토큰을 넘어선 연속성 없이 현재 보내신 프롬프트에 기반하여 생성됩니다.
단일 턴의 상호작용이라면 그럭저럭 괜찮습니다. 질문하고, 답변하고, 넘어가면 되니까요. 하지만 에이전트라면 다릅니다. 에이전트는 세션 간에 작업을 수행하고, 실수에서 배우며, 사용자와 함께 진화해야 하는 시스템입니다. 이러한 에이전트에게 무상태성은 강력한 아키텍처적 제한입니다. 이것은 셀프호스티드 AI 시스템에서 여전히 해결되지 않은 핵심 문제 중 하나입니다.
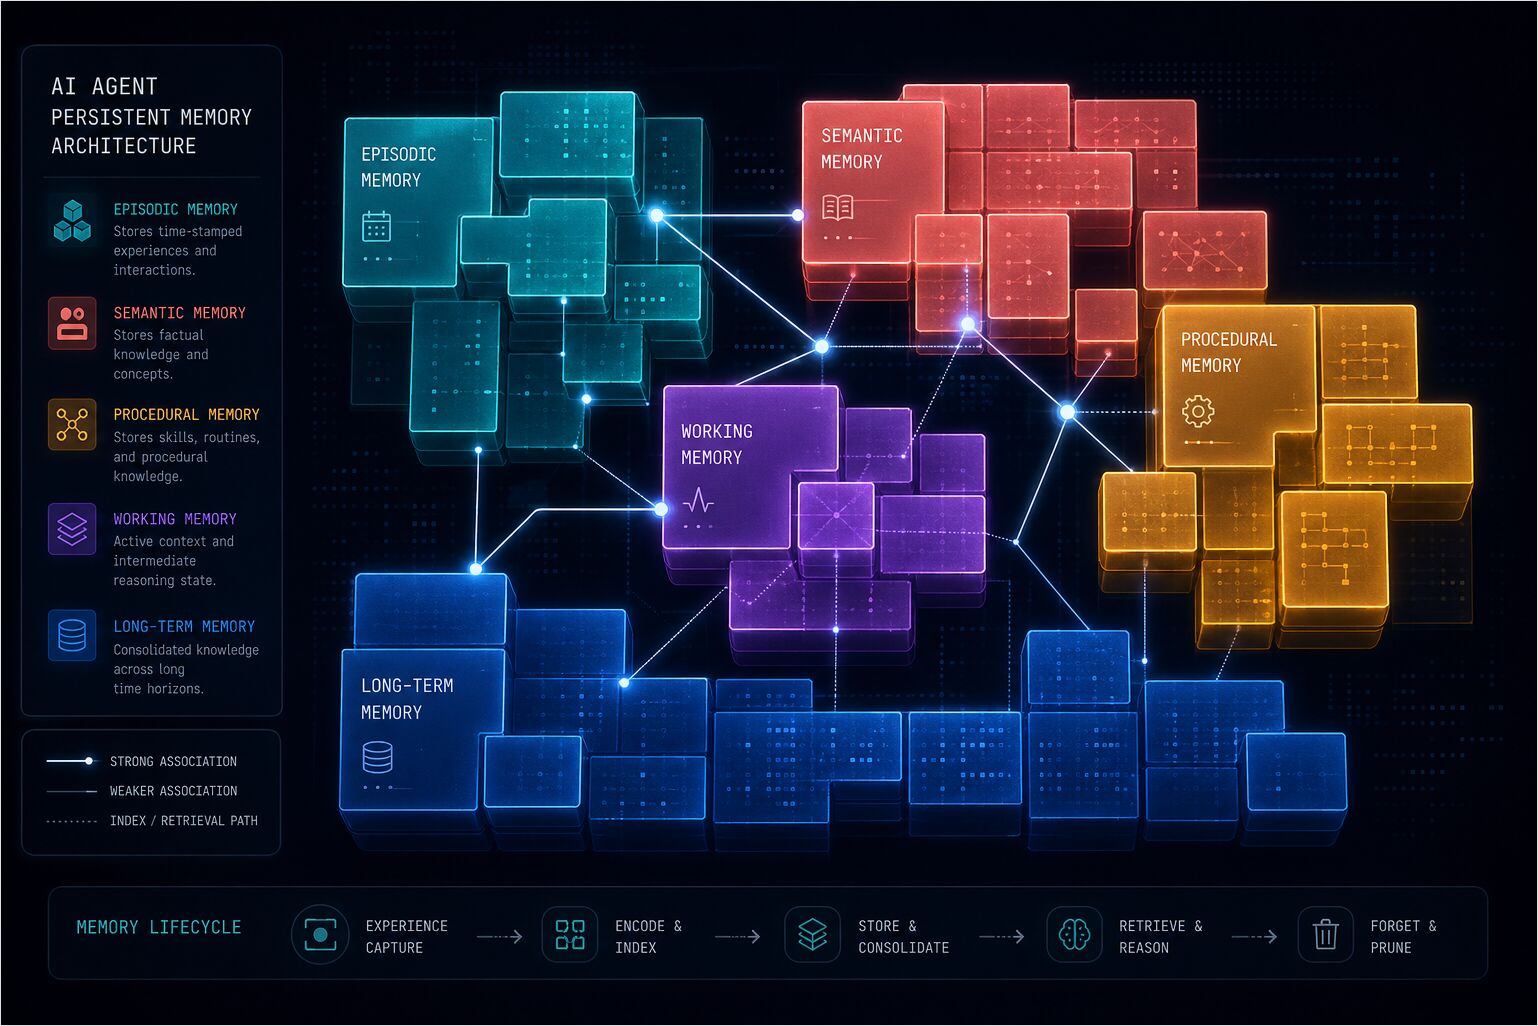
업계는 이 문제를 해결하기 위해 여러 시도를 해왔습니다. LangChain은 메모리 모듈을 추가했고, OpenAI는 스레드를 갖춘 어시스턴트를 도입했습니다. Letta, Zep, Cognee와 같은 프레임워크는 영구 메모리를 중심으로 한 전체 아키텍처를 구축했습니다. Databricks는 “메모리 스케일링(memory scaling)“에 대해 발표했는데, 이는 에이전트 성능이 축적된 경험에 따라 향상된다는 개념입니다. 2024년 이후로 에이전틱 AI에서 점점 더 해결되지 않은 핵심 문제로 인식되고 있는 이 문제를 해결하기 위해 전용 벤치마크 논문, 에피소딕 메모리 서베이, 그리고 빠르게 성장하는 도구 생태계가 등장했습니다.
이러한 접근법 중 대부분은 공통적인 문제를 공유합니다: 메모리를 사후적으로 고려하는 것입니다. 이는 조회하는 데이터베이스, 채워 넣는 컨텍스트 윈도우, 그리고 명확성 대신 지연 시간과 노이즈를 추가하는 검색 시스템으로 취급됩니다.
Hermes Agent는 근본적으로 다른 접근 방식을 취합니다. 메모리는 에이전트가 필요할 때 *검색(retrieve)*하는 것이 아닙니다. 항상 시스템 프롬프트에 내장되어 있고, 큐레이션되고, 범위가 정해져 있으며, 항상 활성 상태인 에이전트의 존재 자체입니다.足够히 작아 빠르고, 충분이 구조화되어 유용하며, 잊어야 할 것을 아는 데 필요한 규율이 있습니다.
이 글은 이것이 정확히 어떻게 작동하는지 설명합니다 — AI 어시스턴트의 메모리 시스템의 크로스 프레임워크 모델 내부의 Hermes 전용 레이어와, AI 어시스턴트 아키텍처의 더 넓은 스택을 포함합니다. 활성화 및 검사 명령(hermes memory, hermes dump, 로그 테일링)에 대해서는 Hermes Agent CLI 치트시트와 함께 사용하세요. Hermes의 “장기 지식” 측면인 큐레이션된 메모리 파일이 아닌 SKILL.md의 재사용 가능한 절차에 대해서는 Hermes Agent Skill 작성 — SKILL.md 구조 및 모범 사례를 참고하세요.
Part 1: AI 에이전트 메모리 문제
왜 “단순히 컨텍스트 추가"가 에이전트에게는 확장되지 않는가
무상태 AI에 대한 명백한 솔루션은 컨텍스트를 추가하는 것입니다. 이전 대화를 첨부하십시오. 프로젝트 문서를 포함하십시오. 전체 히스토리를 보내십시오.
일부러는 그것이 작동합니다. 128K 컨텍스트 윈도우를 가지고 있다면 그 안에 많은 텍스트를 담을 수 있습니다.
하지만 컨텍스트는 메모리가 아닙니다 — 두 사이에는 실재하고 중요한 차이가 있습니다. 컨텍스트는 지금 당신에게 표시되는 모든 것이고, 메모리는 당신이 능동적으로 유지하고 전진시키는 것입니다.
컨텍스트에는 큐레이션이 없습니다. 이는 덤프(dump)입니다: 컨텍스트가 커질수록 모델은 필요한 하나의 사실을 찾기 위해 수천 개의 토큰에 달하는 관련 없는 히스토리를 처리해야 합니다. 이것은 토큰과 비용을 소모하고, 지연 시간을 복합적으로 증가시키며, 결국 한계에 도달합니다.
메모리는 큐레이션된 것입니다. 경험을 압축하고 실행 가능한 형태로 추출한 것입니다. 무한정 성장하지 않습니다 — 통합하고, 업데이트하고, 잊습니다.
인간의 메모리도 동일한 방식으로 작동합니다. 당신이 했던 모든 대화를 기억하지는 않습니다. 중요한 부분을 기억합니다: 대화 상대는 누구인지, 그들이 무엇을 중요하게 생각하는지, 합의된 사항은 무엇인지, 무엇을 배웠는지. 나머지는 잊거나 필요할 때 검색 가능하게 됩니다.
연구 현상
AI 에이전트 메모리 분야는 2024년 이후로 폭발적으로 성장했으며, 전용 벤치마크 스위트, 증가하는 연구 문헌, 그리고 다양한 아키텍처적 접근 방식 사이의 측정 가능한 성능 격차가 있습니다. 현재 상황은 다음과 같습니다.
Letta(구 MemGPT)는 영구 메모리를 일급 관심사로 취급한 가장 초기 프레임워크 중 하나이며, GitHub 스타 21.7K를 달성했습니다. OS에서 영감을 받은 3층 모델을 사용합니다: 코어 메모리(작고 항상 컨텍스트에 포함), 리콜 메모리(검색 가능한 대화 히스토리), 아카이브 메모리(장기 콜드 스토리지). 모든 메모리가 동등하지 않다는 통찰은 정확했습니다. 그러나 구현은 에이전트가 Letta 런타임 내에서 완전히 실행되도록 요구합니다 — 이를 채택한다는 것은 메모리 레이어뿐 아니라 전체 플랫폼을 채택한다는 것을 의미합니다.
Zep / Graphiti는 시간적 엔티트 추적을 가진 대화 메모리에 집중합니다 — 사실은 유효성 윈도우를 가지므로 그래프는 무언가가 참이었던 시점을 압니다. 관계 그래프가 필요한 챗봇에는 강력하지만, 환경 사실과 프로젝트 관행을 추적하는 자율 에이전트에는 덜 적합합니다.
Cognee는 문서와 구조화 데이터로부터의 지식 추출을 위해 구축되었으며, 30개 이상의 인제스트 커넥터와 지식 그래프 백엔드를 갖추고 있습니다. 기관 지식과 RAG 파이프라인에서 뛰어난 성능을 보이지만, 개인 에이전트 메모리에는 덜 집중됩니다. 실용적인 설정 가이드를 위해 로컬 LLM과 함께 Cognee 셀프호스팅을 참조하세요.
Hindsight는 엔티트 관계와 여러 메모리를 새로운 통찰로 결합하는 고유한 reflect 종합 도구를 가진 지식 그래프 기반 리콜을 수행합니다. 에이전트 메모리 벤치마크에서 상위권 성능을 보이며, Hermes Agent의 메모리 제공자로 사용 가능합니다.
Mem0는 서버 측에서 LLM 분석을 통해 메모리 추출을 처리하며, 최소한의 구성을 요구합니다. ECAI 2025(arXiv:2504.19413)에 발표된 Mem0 연구 논문은 AI 메모리에 대한 10가지 고유한 접근 방식을 벤치마크하여 선별적 추출 접근 방식 — 개별 사실 저장, 중복 제거, 관련성 있는 것만 검색 — 을 검증했습니다. Mem0은 약 48K GitHub 스타와 21개의 프레임워크 통합을 지원합니다. 트레이드오프는 클라우드 의존성과 비용입니다.
Databricks의 메모리 스케일링 연구는 에이전트 성능이 축적된 경험에 따라 향상된다는 개념을 도입했습니다. 그들의 아키텍처는 시스템 프롬프트, 엔터프라이즈 자산, 그리고 조직 및 사용자 레벨로 스코프가 지정된 에피소딕/시맨틱 메모리를 보유하여, 메모리 품질이 모델 기능만큼 중요하다는 아이디어를 검증합니다.
대부분의 프레임워크에 걸쳐 공통적인 주제는 메모리를 검색 문제로 취급한다는 것입니다: 어딘가에 저장하고, 필요할 때 조회하고, 컨텍스트에 주입합니다. Hermes는 정반대를 합니다 — 메모리는 온디맨드로 검색되는 것이 아니라, 세션 시작 시 주입되어 항상 존재합니다. 항상 활성, 항상 사용 가능, 유용성을 유지하기에 충분이 큐레이션됨.
Part 2: 아키텍처
이 부분을 위에서부터 읽어보세요 — 먼저 레이어 및 턴별 리콜/저장, 다음 MEMORY.md와 USER.md에 무엇이 존재하는지, 그리고 외부 제공자를 연결하는 방법을 확인하세요.
두 가지 레이어
Hermes는 메모리를 두 가지 레이어로 스택합니다:
- 내장(Built-in) —
MEMORY.md와USER.md, 파일 기반, 항상 활성. 하드 캡: 에이전트 노트는 2,200자, 사용자 프로필은 1,375자. - 외부 제공자 1개(옵션) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory 및 구성을 통해 활성화하는 동등한 제공자. 동시에 하나만 외부 백엔드가 실행됩니다. 파일 옆에 검색과 보존을 추가하지만, 파일을 대체하지는 않습니다.
마음의 모델은 가법(additive)입니다 — 동결된 코어 파일과 최대 1개의 플러그인. 프리페치(prefetch)와 동기화(sinc) 훅은 외부 레이어를 오케스트레이션하며, 두 파일은 동결 시스템 프롬프트의 일부로 별도로 주입됩니다.
런타임 플로우(프리페치와 동기화)
리콜은 모델이 답변하기 전에 발생하며, 영속성은 어시스턴트 메시지 후에 발생합니다. Hermes Agent의 메모리 매니저에서 이는 들어올 때의 **프리페치(prefetch)**와 나갈 때의 **동기화(sinc)**로 매핑됩니다. 아래 이름들은 구현 표면(MemoryManager, 제공자별 prefetch / sync_turn / queue_prefetch)과 일치합니다.
User message
    |
    v
MemoryManager.prefetch_all(query)        <-- recall phase
    |
    +-- provider.prefetch(query)        <-- 각 외부 제공자가 자신의 스토어에서 검색
    |
    v
Context injected into LLM turn
    |
    v
LLM responds (assistant message)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- store phase
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- 다음 턴을 위한 배경 검색
내장 MEMORY.md와 USER.md는 prefetch_all을 통해 가져오지 않습니다 — 그것들은 이미 동결 시스템 프롬프트의 일부이기 때문입니다. 외부 백엔드는 prefetch_all / sync_all에 플러그인으로 연결되며, queue_prefetch는 제공자가 현재 응답을 블로킹하지 않고 다음 턴을 위한 검색을 예열(warm up)할 수 있게 합니다.
장기 메모리로의 세 가지 경로
-
내장
memory도구. 모델은 인스트럭션이 무언가가 영속되어야 한다고 말할 때add,replace, 또는remove를 사용하여memory를 호출합니다 — 지속 가능한 사실, 선호 사항, 수정 사항, 환경 노트.target='user'는 USER.md를,target='memory'는 MEMORY.md를 유지합니다. 예시 형태:memory(action='add', target='user', content='…'). -
외부 제공자에 대한 수동적 보존. 각 턴마다 프레임워크는 대화 내용을 분할, 요약, 또는 추출할 수 있도록 제공자의 동기화 경로를 호출하여, 모델이 모든 사실을 명시적으로 나열하지 않아도 됩니다. 동작은 백엔드마다 다릅니다 — 예를 들어 Hindsight는 턴을 배치하고 엔티트와 관계를 가진 구조화된 보존을 실행하며, Honcho는 대화 내용을 그 특유의 변증법(pipeline)을 통해 보내고, Mem0 및 Supermemory 스타일의 스택은 턴에서 수동적으로 사실을 추출합니다.
-
제공자 특화 도구. 플러그인이 공개하는 경우,
honcho_conclude,hindsight_retain, 또는honcho_profile과 같은 명시적인 기록은 온디맨드로 지속 가능한 조각을 저장합니다.
자동 리콜 vs 제공자 도구
코어 메모리는 읽기 도구가 필요하지 않습니다 — 그것은 이미 프롬프트에 있기 때문입니다. 외부 백엔드는 프리페치에서 자동 주입(그 컨텍스트 조각에 대한 별도의 리콜 도구 호출 불필요)을 추가하거나, 모델이 프리페치만으로는 더 날카로운 쿼리가 필요할 때 명시적 검색 도구(honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect, 및 동등한 것들)를 추가합니다.
리콜 모드(외부 제공자)
플러그인은 토큰을 제어와 교환하는 구성 가능한 리콜 모드(보통 구성에서 memory.provider 옆에 recall_mode로)를 지원합니다.
| 모드 | 프리페치에서 자동 주입 | 사용 가능한 제공자 도구 | 일반적인 적합성 |
|---|---|---|---|
| context | 예 | 아니오 | 손이 닿지 않는, 예측 가능한 컨텍스트 |
| tools | 아니오 | 예 | 모델이 검색 시점을 선택 |
| hybrid | 예 | 예 | 가장 풍부한 컨텍스트; 더 높은 토큰 사용 |
외부 제공자가 설정되지 않았을 때(memory.provider가 비어 있거나 설정되지 않음), 내장 파일과 세션 검색만 적용되며 — 플러그인으로부터의 프리페치/동기화는 없습니다.
디스크 경로와 버짓
Hermes Agent의 내장 메모리는 두 개의 파일에 존재합니다.
~/.hermes/memories/MEMORY.md— 에이전트의 개인 노트 (2,200자, ~800 토큰)~/.hermes/memories/USER.md— 사용자 프로필 (1,375자, ~500 토큰)
이것이 전체 영속 메모리 표면입니다: 두 개의 파일, 총 3,600자 미만, 1,300 토큰 미만. 의도적으로 작아 보이는 것처럼, 실제로 작습니다 — 그리고 바로 그것이 설계 의도입니다.
MEMORY.md: 에이전트의 노트
에이전트가 자신의 환경, 프로젝트, 도구, 관행, 그리고 배운 교훈에 대해 배우는 모든 것을 저장하는 곳입니다. 다음과 같이 보입니다:
User's project is a Go microservice at ~/code/gateway using gRPC + PostgreSQL
This machine runs Ubuntu 22.04, has Docker and kubectl installed
User prefers snake_case for variable names and avoids camelCase
이것들은 로그가 아닙니다. 사실입니다. 밀도 높고, 선언적이고, 정보량이 많습니다. 타임스탬프도, 불필요한 수식어도, “1월 5일에 사용자가 나에게 ~해달라고 요청했다” 같은 것도 없습니다.
USER.md: 사용자 프로필
에이전트가 당신에 대해 아는 모든 것을 저장하는 곳입니다.
User is a full-stack developer comfortable with TypeScript, Go, and Python.
User prefers snake_case for variable names and avoids camelCase.
User primarily uses Linux Ubuntu 22.04.
User deploys to AWS using Terraform.
정체성, 역할, 선호 사항, 기술적 기술, 커뮤니케이션 스타일, 싫어하는 것들. 에이전트가 당신에게 다른 누구보다 다르게 반응하게 만드는 것들입니다.
동결 스냅샷 패턴
세션 시작 시, 두 파일 모두 디스크에서 로드되어 동결된 블록으로 시스템 프롬프트에 주입됩니다. 다음과 같이 보입니다:
══════════════════════════════════════════════
MEMORY (your personal notes) [7% — 166/2,200 chars]
══════════════════════════════════════════════
User's project is a Go microservice at ~/code/gateway using gRPC + PostgreSQL
§
This machine runs Ubuntu 22.04, has Docker and kubectl installed
§
User prefers snake_case for variable names and avoids camelCase
§
══════════════════════════════════════════════
USER PROFILE (who the user is) [8% — 110/1,375 chars]
══════════════════════════════════════════════
User is a full-stack developer comfortable with TypeScript, Go, and Python.
§
User prefers snake_case for variable names and avoids camelCase.
§
포맷은 헤더, 사용률, 자 수, 그리고 §(섹션 부호) 구분자를 사용합니다. 항목은 여러 줄일 수 있습니다. 모델이 파싱할 수 있으면서도 사람이 읽을 수 있도록 설계되었습니다.
왜 동결(frozen)인가? 프리픽스 캐싱 때문입니다. 시스템 프롬프트는 세션 내 모든 턴에서 동일합니다. 세션 시작 후 메모리를 정적으로 유지함으로써, 모델은 프리픽스 계산의 캐시를 사용하고 가변 부분인 대화만 처리하면 됩니다. 이것은 상당한 성능 최적화입니다. 매 턴마다 동일한 메모리 토큰에 대해 어텐션을 다시 계산하지 않아도 됩니다.
세션 중 이루어진 변경 사항은 즉시 디스크에 영속화되지만, 다음 세션 시작 시에만 시스템 프롬프트에 나타납니다. 도구 응답은 항상 라이브 상태를 표시하지만, 모델의 “마음"은 세션 중 변경되지 않습니다. 이것은 모델이 자신의 꼬리를 쫓는 것을 방지합니다 — 메모리를 업데이트한 후 같은 대화 내에서 그 자신의 업데이트에 반응하는 것을 방지합니다.
캐릭터 제한을 특징으로
2,200자. 1,375자. 이것은 임의의 제한이 아닙니다. 큐레이션을 강제하는 설계 제약입니다.
무제한 메모리는 부채입니다. 모든 것을 덤프하고, 결코 통합하지 않으며, 결국 노이즈가 되도록 격려합니다. 제한된 메모리는 에이전트가 선택적으로 행동하도록 강제합니다. 실제로 중요한 것은 무엇인가? 다시 필요하게 될 것은 무엇인가? 의미를 잃지 않고 압축할 수 있는 것은 무엇인가?
메모리가 가득 차면, 에이전트는 단순히 조용히 실패하지 않습니다. 현재 항목과 사용량을 가진 에러를 받고, 다음 워크플로를 따릅니다:
- 에러 응답에서 현재 항목 읽기
- 제거하거나 통합할 수 있는 항목 식별
- 관련 항목을 더 짧은 버전으로 병합하기 위해
replace사용 - 새 항목 추가
이것이 메모리가 유용하게 유지되는 방식입니다. 이것은 데이터베이스가 아닙니다. 중요한 사실의 큐레이션된 컬렉션입니다.
보안: 프롬프트 인젝션 스캔
모든 메모리 항목은 수락 전에 스캔됩니다. 시스템은 프롬프트 인젝션 시도, 자격 증명 유출, SSH 백도어, 그리고 보이지 않는 유니코드 문자를 차단합니다.
메모리는 또한 중복 제거됩니다. 정확히 동일한 항목은 자동으로 거부됩니다. 이는 공격자가 반복 제출을 통해 악성 콘텐츠를 주입하려는 시도를 방지합니다.
외부 메모리 제공자(활성화와 링크)
내장 MEMORY.md와 USER.md 외에도, Hermes Agent는 Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, 또는 Supermemory 중 외부 메모리 플러그인 1개를 동시에 연결할 수 있으며 — 영구적인, 세션을 가로지르는 지식을 위해. 외부 제공자는 동시에 하나만 활성이며, 두 개의 코어 파일은 그것과 함께 로드됩니다(대체가 아닌 가법).
hermes memory setup, hermes memory status, hermes memory off로 제공자를 활성화하고 검사하거나, ~/.hermes/config.yaml에서 memory.provider와 recall_mode를 설정하십시오. 자격 증명 패턴은 다양합니다(예: HINDSIGHT_API_KEY, $HERMES_HOME/honcho.json 아래 Honcho 키); 인터랙티브 배선을 위해 hermes memory setup을 사용하세요.
최소 내장 전용 YAML 형태:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
하나의 백엔드를 위한 예시 활성화(설치가 지원하는 honcho, mem0, supermemory 또는 기타 것으로 hindsight를 교체):
memory:
  provider: "hindsight"
전체 비교 테이블, LLM 및 임베딩 의존성 노트, 제공자별 분석, 그리고 OpenClaw 및 다른 스택과 이러한 백엔드의 관계에 대해서는 **에이전트 메모리 제공자 비교**를 참조하세요. 비정상적으로 세분화된 쓰기 제어를 가진 로컬, 셀프호스티드 제공자에 대해서는 **Hermes Agent를 위한 Mnemosyne: 로컬 메모리 퀵스타트**를 참조하세요 — 그리고 Hermes의 MEMORY.md와 같은 제한된, 큐레이션된 메모리가 왜 구조적으로 여러 피드백 루프 실패 모드를 회피하는지에 대해서는 **AI 에이전트에서 자기 강화 메모리 루프**를 참조하세요.
프로파일 특화 배선과 프로덕션 워크플로를 위해 Hermes Agent 프로덕션 설정을 참조하세요. **AI Systems Memory 허브**는 이 가이드와 관련 Cognee 및 지식 레이어 기업을 나열합니다.
Part 3: 메모리가 발동될 때 — 트리거와 결정
Hermes Agent의 메모리에 대한 가장 일반적인 질문은 실제로 무언가를 저장하는 시점이 언제인지입니다.
답변은: 끊임없이, 하지만 선택적으로입니다. 에이전트는 memory 도구를 통해 자신의 메모리를 관리하며, 저장하는 결정은 명시적 시그널과 암묵적 패턴의 조합에 의해驱动됩니다.
쓰기 트리거: 에이전트는 언제 저장하는 것을 결정하는가?
에이전트는 능동적으로 메모리를 저장합니다. 당신이 요청하기를 기다리지 않습니다. 이것들이 트리거입니다.
사용자 수정 사항. 에이전트를 수정할 때, 그것은 기억할 시그널입니다. “다시 그렇게 하지 마세요.” “이것을 대신 사용하세요.” “이것을 기억하세요.” 이것은 메모리를 업데이트하기 위한 명시적 인스트럭션입니다.
예시: Python 환경을 구성해달라고 에이전트에게 요청합니다. 에이전트는 pip를 제안합니다. 당신은 “나는 모든 것에 poetry를 사용한다"고 말합니다. 에이전트는 저장합니다: User prefers using the 'poetry' package manager for all Python projects.
발견된 선호 사항. 에이전트는 패턴을 관찰하고 선호 사항을 추론합니다. 특정 도구, 프레임워크, 또는 워크플로를 일관되게 사용한다면, 그것은 저장됩니다.
예시: 여러 프로젝트에서 poetry를 여러 번 사용하는 것을 본 후, 에이전트는 이를 선호 사항으로 저장합니다.
환경 사실. 기계, 프로젝트, 설치된 도구에 대한 것들. 이것들은 탐색을 통해 발견되고 사실로 저장됩니다.
예시: 에이전트는 설치된 것을 확인하고 저장합니다: This machine runs Ubuntu 22.04, has Docker and kubectl installed.
프로젝트 관행. 프로젝트가 어떻게 구조화되어 있는지, 어떤 도구를 사용하며, 어떤 패턴을 따르는지. 이것들은 코드 인스펙션을 통해 발견되고 저장됩니다.
예시: User's project is a Go microservice at ~/code/gateway using gRPC + PostgreSQL.
완료된 복잡한 워크플로. 5개 이상의 도구 호출이 필요한 작업을 완료한 후, 에이전트는 해당 접근 방식을 스킬로 저장하거나 최소한 무엇을 효과가 있었는지를 기록하는 것을 고려합니다.
도구의 특이한 점과 워크어라운드. 에이전트가 도구, API, 또는 시스템에 대해 직관적으로 알기 어려운 것 — 제한 사항, 워크어라운드, 관행 — 을 발견할 때 저장합니다.
무엇이 건너뛰어지는가:
- 사소하거나 명백한 정보
- 쉽게 다시 발견 가능한 것
- 원시 데이터 덤프
- 세션 특화 일시적 정보
- 컨텍스트 파일(SOUL.md, AGENTS.md)에 이미 있는 정보
읽기 트리거: 에이전트는 언제 리콜하는가?
메모리는 검색되지 않습니다 — 그것은 항상 거기에 있습니다. 하지만 접근의 수준이 다릅니다.
세션 시작(자동). MEMORY.md와 USER.md가 시스템 프롬프트에 주입됩니다. 에이전트는 첫 번째 토큰부터 그것들을 가지고 있습니다. 쿼리 불필요, 지연 없음, 도구 호출 없음. 이것이 코어 메모리입니다 — 항상 활성.
session_search(온디맨드). 코어 메모리에 없는 과거 대화의 무언가를 찾아야 할 때, 에이전트는 session_search 도구를 사용합니다. 이것은 FTS5 전체 텍스트 검색과 Gemini Flash 요약을 사용하여 SQLite(~/.hermes/state.db)를 쿼리합니다. “영원히 이 사실을 기억하라"보다는 “이전에 이것에 대해 논의했다"는 느낌이 드는 질문일 때 이것을 사용하십시오.
예시: “지난주에 Docker 네트워킹에 대해 논의했나?“라고 묻습니다. 에이전트는 세션 히스토리를 검색하고 관련 대화의 요약을 반환합니다.
외부 제공자 도구(설정 시). 외부 메모리 제공자가 활성이면, 프레임워크는 각 응답 전에 자동 프리페치 단계도 실행합니다(Part 2 참조). honcho_search, hindsight_recall, 또는 mem0_search와 같은 추가 도구는 에이전트가 명시적 검색을 선택할 때 표적화된 조회를 위해 사용됩니다 — recall_mode에 따라, 자동 주입, 도구, 또는 둘 다 활성일 수 있습니다.
의사결정 트리
에이전트가 “이것은 기억할 가치가 있는가?“를 어떻게 저울질하는지에 대한 다음 내용입니다:
Is this a correction or explicit instruction?
  YES → Save to memory
  NO → Is this a preference or pattern?
    YES → Save to user profile
    NO → Is this an environment fact or convention?
      YES → Save to memory
      NO → Is this easily re-discovered?
        YES → Skip
        NO → Is this session-specific?
          YES → Skip
          NO → Save to memory
에이전트는 이에 대해 과도하게 고민하지 않습니다. 능동적으로 저장하고, 가득 차면 통합하며, 캐릭터 제한이 것들을 조이는 것을 신뢰합니다.
Part 4: 내부 메모리 vs 외부 지식 베이스
혼란이 자주 발생하는 곳입니다. Hermes Agent는 내부 메모리(MEMORY.md, USER.md, 외부 제공자)와 외부 지식 베이스(LLM Wiki, Obsidian, Notion, ArXiv, 파일 시스템)를 가지며, 그것들은 완전히 다른 역할을 수행합니다. 이것은 검색 증강 생성 파이프라인과 에이전트 작업 메모리 간의 구분과 유사합니다 — 외부 검색은 심층 지식 조회에는 좋지만, 정체성과 선호 사항을 전달하는 데는 좋지 않습니다. 내부 메모리는 에이전트의 두뇌입니다 — 항상 활성, 큐레이션됨, 모든 세션으로 전달됨. 외부 지식 베이스는 그 도서관입니다 — 온디맨드로 참조되는 방대한 참고 자료.
구분
내부 메모리(두뇌):
- 작고, 영구적이고, 시스템 프롬프트에 주입됨
- 포함: 사용자 선호, 에이전트 관행, 즉각적인 교훈
- 대화 중 항상 “마음속에”
- 큐레이션됨, 제한됨, 능동적 관리
- 예: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
외부 지식 베이스(도서관):
- 방대하고, 참조 전용이고, 온디맨드로 접근
- 포함: 문서, 논문, 코드, 노트, 데이터베이스
- 필요할 때 도구를 통해 접근
- “기억"되지 않음 — 조회됨
- 예: LLM Wiki, Obsidian, Notion, ArXiv, 파일 시스템, GitHub
관계
에이전트는 필요할 때 도구를 통해 외부 베이스에 접근합니다. 그것들을 “기억"하지 않습니다 — 조회합니다.
LLM Wiki(llm-wiki): 도메인 지식을 구축하고 쿼리하기 위한 Karpathy의 상호 연결된 마크다운 지식 베이스. 에이전트는 llm-wiki 스킬을 사용하여 읽기, 검색, 쿼리합니다. 이것은 참고 자료이지 메모리가 아닙니다.
Obsidian: 양방향 링크를 가진 개인 노트 볼트. 에이전트는 obsidian 스킬을 사용하여 노트를 읽고, 검색하고, 생성합니다. Obsidian은 Hermes가 라이브러리 리소스로 활용할 수 있는 더 넓은 개인 지식 관리 생태계의 일부입니다.
Notion/Airtable: API를 통해 접근되는 구조화 데이터베이스와 위키. 에이전트는 필요할 때 쿼리합니다.
ArXiv: 학술 논문 저장소. 에이전트는 주제 연구 시 논문을 검색하고 추출합니다.
파일 시스템: 프로젝트 코드, 문서, 설정. 에이전트는 프로젝트 작업 시 파일들을 읽습니다.
증류 패턴
핵심 통찰: 외부 베이스의 중요한 통찰은 내부 메모리로 *증류(distill)*될 수 있습니다.
예시: 에이전트는 AI 에이전트를 위한 메모리 스케일링에 대한 ArXiv 논문을 읽습니다. 논문의 전체를 메모리에 저장하지 않습니다. 핵심 요약을 저장합니다: Memory scaling: agent performance improves with accumulated experience through user interaction and business context stored in memory.
외부 리소스는 방대합니다. 내부 메모리는 그 증류입니다.
언제 어떤 것을 사용할 것인가
내부 메모리용:
- “누구를 돕고 있는가?”
- “그들은 무엇을 선호하는가?”
- “방금 무엇을 배웠나?”
- “프로젝트 설정은 무엇인가?”
- “사용 가능한 도구는 무엇인가?”
외부 지식 베이스용:
- “X에 대한 최신 연구는 무엇인가?”
- “내 프로젝트 문서에 무엇이 있는가?”
- “지난달에 무엇을 논의했는가?”
- “이 서비스의 API는 무엇인가?”
- “코드 구조는 무엇인가?”
에이전트는 차이를 이해하고 각각을 적절하게 사용합니다 — 문서 조회와 당신과 당신의 환경에 대해 배운 무언가를 회상하는 것을 혼동하지 않습니다.
Part 5: 실제로 어떻게 작동하는가
메커니즘을 살펴봅시다.
memory 도구
에이전트는 세 가지 액션: add, replace, remove를 가진 단일 도구를 통해 메모리를 관리합니다.
read 액션은 없습니다 — 메모리 콘텐츠는 시스템 프롬프트에 자동 주입됩니다. 에이전트는 그것이 항상 거기에 있으므로 읽을 필요가 없습니다.
add — 새 항목을 추가합니다.
memory(action="add", target="memory",
       content="User runs macOS 14 Sonoma, uses Homebrew, has Docker Desktop installed.")
replace — 부분 문자열 매칭을 사용하여 기존 항목을 대체합니다.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="User prefers light mode in VS Code, dark mode in terminal")
remove — 부분 문자열 매칭을 사용하여 항목을 제거합니다.
memory(action="remove", target="memory",
       old_text="temporary project fact")
부분 문자열 매칭
replace와 remove는 old_text를 통해 짧은 고유 부분 문자열을 사용합니다. 전체 항목 텍스트가 필요하지 않습니다. 이는 정확한 내용을 알지 못해도 외과적 편집이 가능하게 합니다.
부분 문자열이 여러 항목에 일치하면, 더 구체적인 매칭을 요청하는 에러가 반환됩니다. 에이전트는 тогда 쿼리를 정교화합니다.
대상 저장소: memory vs user
target 매개변수는 어느 파일이 업데이트되는지 결정합니다.
memory— 에이전트의 개인 노트. 환경 사실, 프로젝트 관행, 도구 특이점, 배운 교훈.user— 사용자 프로필. 정체성, 역할, 시간대, 커뮤니케이션 선호, 싫어하는 것, 워크플로 습관.
용량 관리
메모리가 80% 이상 가득 차면, 에이전트는 통합합니다. 관련 항목을 병합하고, 오래된 사실을 제거하고, 정보를 압축합니다.
좋은 메모리 항목은 컴팩트하고 정보 밀도가 높습니다:
User runs macOS 14 Sonoma, uses Homebrew, has Docker Desktop installed. Shell: zsh with oh-my-zsh. Editor: Neovim with Telescope plugin.
나쁜 메모리 항목은 모호하거나 장황합니다:
User has a project.
On January 5th, 2026, the user asked me to look at their project which is located at ~/code/gateway and it uses Go with gRPC and PostgreSQL for the database layer.
첫 번째는 밀도 있고 유용합니다. 두 번째는 너무 모호하거나 너무 장황합니다.
세션 검색 vs 영속 메모리
session_search와 영속 메모리는 다른 목적을 위해 사용됩니다.
| 기능 | 영속 메모리 | 세션 검색 |
|---|---|---|
| 용량 | ~1,300 토큰 총 | 무제한(모든 세션) |
| 속도 | 즉시(시스템 프롬프트 내) | 검색 + LLM 요약 필요 |
| 사용 사례 | 항상 사용 가능한 핵심 사실 | 특정 과거 대화 찾기 |
| 관리 | 에이전트 수동 큐레이션 | 자동 — 모든 세션 저장 |
| 토큰 비용 | 세션당 고정(~1,300 토큰) | 온디맨드(필요 시 검색) |
기본 규칙: 컨텍스트에 항상 있어야 하는 핵심 사실에는 메모리를 사용하십시오. 역사적 조회에는 세션 검색을 사용하십시오.
Part 6: 철학
왜 제한된 메모리가 무제한 메모리보다 나은가
직관은 메모리를 최대한 크게 만드는 것입니다. 모든 것을 저장하십시오. 필요한 것을 검색하십시오.
제한된 메모리가 더 잘 작동합니다. 그 이유는 다음과 같습니다.
큐레이션이 품질을 강제합니다. 제한된 공간이 있을 때, 당신은 중요한 것만 저장합니다. 압축하고, 통합하고, 우선순위를 정합니다. 무제한 메모리는 모든 것을 덤프하고 결코 정리하지 않는 것을 격려합니다.
속도가 중요합니다. 시스템 프롬프트의 1,300 토큰은 빠릅니다. 데이터베이스에서 검색된 100,000 토큰은 느립니다. 메모리는 즉시여야 하며, 쿼리가 아니어야 합니다.
노이즈가 성능을 저하시킵니다. 더 많은 메모리가 더 좋은 메모리를 의미하지는 않습니다. 더 노이즈가 많은 메모리일 뿐입니다. 모델은 신호와 노이즈를 구분해야 하며, 그것은 어텐션을 필요로 합니다 — 실제 작업에 사용되어야 할 어텐션을.
망각은 기능입니다. 인간의 메모리는 잊습니다. 그것은 버그가 아닙니다 — 우리가 우선순위를 정하는 방식입니다. 에이전트도 잊어야 합니다. 모든 것이 기억될 자격을 갖지는 않습니다.
“망각” 문제
에이전트는 배우지 않는(unlearn) 것이 필요합니다. 단순히 잊는 것이 아니라, 능동적으로 오래된 정보를 제거하는 것입니다.
Hermes Agent가 이것을 처리하는 방식은 다음과 같습니다:
remove액션: 더 이상 관련 없는 항목을 삭제.replace액션: 새로운 정보로 항목 업데이트.- 용량 압력: 메모리가 가득 차면, 에이전트는 통합하고 오래된 항목을 제거.
- 보안 스캔: 악성 또는 손상된 항목 차단.
망각은 실패가 아닙니다 — 그것은 유지보수입니다. 배우지 못하는 에이전트는 결국 신호만큼의 노이즈를 운반하게 될 것입니다.
메모리 스케일링
Databricks는 “메모리 스케일링” 개념을 도입했습니다: 수천 명의 사용자를 가진 에이전트가 단일 사용자 에이전트보다 더 나은 성능을 보이는가?
그들의 연구는 예, 하지만 주의 사항이 있다고 제안합니다. 메모리 스케일링은 다음을 요구합니다:
- 품질 추출: 모든 상호작용이 기억할 가치가 있는 것은 아닙니다. 에이전트는 로그가 아니라 통찰을 추출해야 합니다.
- 효과적 검색: 검색된 메모리는 관련성이 있어야 합니다. 노이즈는 성능을 저하시킵니다.
- 일반화: 메모리는 구체적이지 않고 패턴이어야 합니다. “사용자는 Python을 선호합니다"는 스케일링됩니다. “사용자는 타임스탬프 Y에 명령 X를 실행했습니다"는 그렇지 않습니다.
Hermes Agent의 제한된 메모리는 자연스럽게 메모리 스케일링을 지원합니다. 큐레이션을 강제함으로써, 메모리가 일반화 가능하고, 컴팩트하며, 유용하도록 보장합니다.
이것이 미래에 의미하는 바
메모리는 에이전틱 AI에서 경쟁력의 해자가 되고 있습니다 — 모델 자체가 아니라, 모델이 세션 사이에 전달하는 것입니다. 동일한 기본 모델을 가진 두 에이전트는 매우 다르게 수행할 수 있습니다: 하나는 당신의 선호, 환경, 과거 실수를 기억합니다; 다른 하나는 매번 차갑게 시작합니다.
더 이상 질문은 에이전트가 영구 메모리를 가져야 하는지가 아닙니다. 그것은 결정되었습니다: 가져야 합니다. 열린 질문은 어떻게 그 메모리를 잘 설계할 것인가입니다 — 무엇을 유지할 것인가, 무엇을 폐기할 것인가, 어떻게 즉각적으로 만들 것인가, 그리고 그것이 노이즈가 되는 것을 어떻게 방지할 것인가.
Hermes Agent의 답은 메모리를 작고, 큐레이션되고, 항상 활성하게 유지하는 것입니다 — 당신이 조회하는 데이터베이스가 아니라, 에이전트가 모든 대화에 가져가는 사용자의 작동 모델입니다.
결론
Hermes Agent의 메모리 시스템은 의도적으로 단순합니다: 두 개의 파일, 단단한 캐릭터 제한, 검색 파이프라인 없음, 벡터 데이터베이스 없음, 그리고 쿼리별 지연 없음. 제한처럼 들리는 것이 바로 핵심입니다.
이것이 작동하는 이유는 메모리를 데이터베이스가 작동하는 방식이 아니라 뇌가 작동하는 방식처럼 대하기 때문입니다 — 작고, 큐레이션되고, 항상 활성. 에이전트가 필요할 때 메모리를 검색하지 않습니다; 메모리는 단순히 항상 거기에 있으며, 모든 세션의 첫 번째 토큰부터 시스템 프롬프트에 직조되어 있습니다.
외부 메모리 제공자는 더 많은 것이 필요한 사용자를 위해 이 시스템을 확장합니다: 지식 그래프, 멀티 에이전트 지원, 셀프호스티드 스토리지, 엔터프라이즈 기능. 하지만 코어는 동일하게 유지됩니다: 제한되고, 큐레이션되고, 항상 사용 가능.
그리고 외부 지식 베이스 — LLM Wiki, Obsidian, Notion, ArXiv — 는 다른 역할을 수행합니다. 그것들은 두뇌가 아니라 도서관입니다. 에이전트는 그것들을 조회하지만 기억하지는 않습니다. 중요한 통찰은 내부 메모리로 증류되고; 나머지는 도서관에 남습니다.
AI 에이전트가 당신을 기억하는 방식이 이것이죠. 모든 것을 저장하는 것이 아니라, 중요한 것을 기억하는 것입니다.
Hermes Agent는 2026년 2월에 Nous Research에 의해 출시되어 2026년 4월까지(v0.9.0) 64,000개 이상의 GitHub 스타를 달성했으며, 242명 이상의 기여자가 있습니다. 오픈소스이며 github.com/NousResearch/hermes-agent에서 사용 가능합니다. 설치, 구성 및 워크플로 가이드를 위해 Hermes Agent 개요를 참조하세요.
