
Système de mémoire de l’agent Hermes : comment fonctionne réellement la mémoire persistante de l’IA
La mémoire est la différence entre un outil et un partenaire.
Vous connaissez le scénario. Vous ouvrez un chat avec un agent IA, vous expliquez votre projet, vous partagez vos préférences, vous accomplissez quelques tâches, puis vous fermez l’onglet. Revenez la semaine suivante et c’est comme parler à un inconnu — tout le contexte a disparu, toutes les préférences ont été oubliées, le projet doit être réexpliqué de zéro.
Ce n’est pas un bug. C’est ainsi que fonctionnent, par conception, les grands modèles de langage (Large Language Models). Ils sont sans état (stateless) : chaque requête est indépendante, chaque réponse est générée à partir de l’invite (prompt) que vous envoyez à l’instant T, sans mémoire, sans historique et sans continuité au-delà des jetons (tokens) de la fenêtre de contexte actuelle.
Pour des interactions à tour unique, cela ne pose pas de problème. Posez une question, obtenez une réponse, passez à la suite. Mais pour les agents — des systèmes censés faire des choses d’une session à l’autre, apprendre de leurs erreurs et évoluer avec vous — le caractère sans état est une limitation architecturale majeure. C’est l’un des problèmes centraux non résolus dans les systèmes d’IA auto-hébergés.
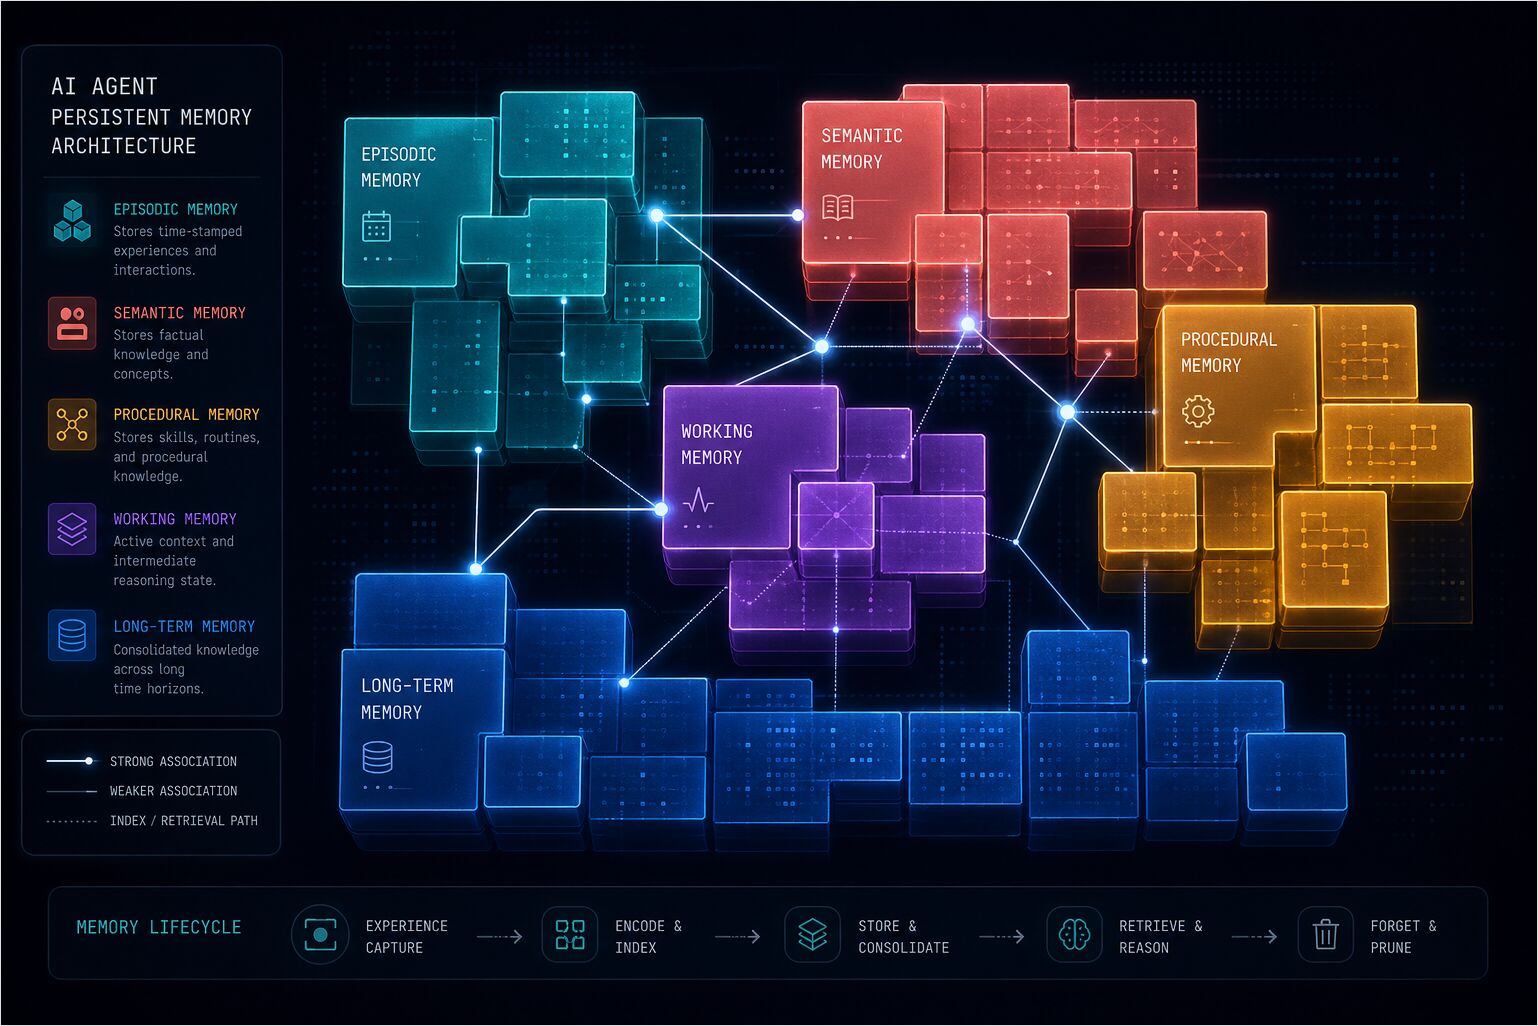
L’industrie a tenté de résoudre ce problème. LangChain a ajouté des modules de mémoire. OpenAI a introduit des assistants avec des fils de discussion (threads). Des frameworks comme Letta, Zep et Cognee ont construit des architectures entières autour de la mémoire persistante. Databricks a publié des travaux sur le « memory scaling » — l’idée que les performances des agents s’améliorent avec l’expérience accumulée. Des articles sur des benchmarks dédiés, des enquêtes sur la mémoire épisodique et un écosystème d’outils en croissance rapide ont tous émergé depuis 2024 pour traiter ce qui est de plus en plus reconnu comme l’un des problèmes centraux non résolus de l’IA agentique.
La plupart de ces approches partagent un problème commun : elles considèrent la mémoire comme un après-coup — une base de données que l’on interroge, une fenêtre de contexte que l’on bourre, un système de récupération qui ajoute de la latence et du bruit plutôt que de la clarté.
Hermes Agent adopte une approche fondamentalement différente. La mémoire n’est pas quelque chose que l’agent récupère quand cela est nécessaire. C’est quelque chose que l’agent est en permanence — intégré dans l’invite système, sélectionné (curated), borné et toujours actif. Il est assez petit pour être rapide, assez structuré pour être utile, et assez discipliné pour savoir quoi oublier.
Cet article explique exactement comment cela fonctionne — la couche spécifique à Hermes à l’intérieur du modèle transverse au framework dans Systèmes de mémoire dans les assistants IA et la pile plus large dans Architecture des assistants IA. Pour les commandes d’activation et d’inspection (hermes memory, hermes dump, suivi des journaux), associez-le à la fiche mémo de l’interface de ligne de commande de Hermes Agent. Pour l’aspect complémentaire du « savoir à long terme » de Hermes — des procédures réutilisables dans SKILL.md plutôt que des fichiers de mémoire sélectionnés — voir [Rédaction de compétences pour Hermes Agent — Structure et bonnes pratiques de SKILL.md](https://www.glukhov.org/fr/ai-systems/hermes/authoring-hermes-skill/ “Créez des compétences Hermes avec frontmatter YAML, divulgation progressive, activation conditionnelle, secrets par rapport à la configuration, et dépannage de l’index.”
Partie 1 : Le problème de la mémoire des agents IA
Pourquoi « Ajouter simplement du contexte » ne passe pas à l’échelle pour les agents
La solution évidente à l’IA sans état est d’ajouter du contexte. Joindre la conversation précédente. Inclure la documentation du projet. Envoyer l’historique entier.
Pendant un moment, cela fonctionne. Vous avez une fenêtre de contexte de 128K. Vous pouvez y loger beaucoup de texte.
Mais le contexte n’est pas de la mémoire — il existe une différence réelle et importante entre les deux. Le contexte est tout ce qui vous est montré maintenant ; la mémoire est ce que vous conservez activement et transmettez.
Le contexte n’est pas sélectionné. C’est un déversement : à mesure qu’il grandit, le modèle doit traiter des milliers de jetons d’historique non pertinents pour trouver le seul fait dont il a besoin. Cela coûte des jetons et de l’argent, augmente la latence et atteint finalement la limite.
La mémoire est sélectionnée. C’est la distillation de l’expérience en quelque chose de compact et d’actionnable. Elle ne grandit pas indéfiniment — elle consolide, met à jour et oublie.
La mémoire humaine fonctionne de la même manière. Vous ne vous souvenez pas de chaque conversation que vous avez eue. Vous vous souvenez des parties importantes : à qui vous parlez, ce qui leur importe, sur quoi vous êtes d’accord, ce que vous avez appris. Le reste est soit oublié, soit recherché quand vous en avez besoin.
Le paysage de la recherche
Le domaine de la mémoire des agents IA a explosé depuis 2024, avec des suites de benchmarks dédiées, une littérature de recherche croissante et un écart de performances mesurable entre les différentes approches architecturales. Voici où nous en sommes.
Letta (anciennement MemGPT) a été l’un des premiers frameworks à traiter la mémoire persistante comme une préoccupation de premier ordre, atteignant 21,7K étoiles GitHub. Il utilise un modèle à trois niveaux inspiré des systèmes d’exploitation : mémoire de base (petite, toujours dans le contexte), mémoire de rappel (historique de conversation recherchable) et mémoire d’archivage (stockage à froid à long terme). L’insight que toute la mémoire n’est pas égale était correct. L’implémentation, cependant, exige que les agents fonctionnent entièrement dans le runtime Letta — l’adopter signifie adopter toute la plateforme, et pas seulement une couche de mémoire.
Zep / Graphiti se concentre sur la mémoire conversationnelle avec un suivi temporel des entités — les faits portent des fenêtres de validité pour que le graphe sache quand quelque chose était vrai. C’est solide pour les chatbots qui ont besoin de graphes relationnels, moins adapté aux agents autonomes suivant les faits d’environnement et les conventions de projet.
Cognee est conçu pour l’extraction de connaissances à partir de documents et de données structurées, avec plus de 30 connecteurs d’ingestion et un backend de graphe de connaissances. Il excelle en connaissances institutionnelles et pipelines RAG mais est moins focalisé sur la mémoire personnelle de l’agent. Voir auto-hébergement de Cognee avec des LLM locaux pour un guide de configuration pratique.
Hindsight effectue un rappel basé sur des graphes de connaissances avec des relations d’entités et un outil unique de synthèse reflect qui effectue une synthèse inter-mémoire — combinant plusieurs mémoires en de nouveaux insights. Il est parmi les meilleurs performeurs sur les benchmarks de mémoire d’agent et est disponible en tant que fournisseur de mémoire pour Hermes Agent.
Mem0 gère l’extraction de mémoire côté serveur via une analyse LLM, nécessitant une configuration minimale. L’article de recherche Mem0, publié à ECAI 2025 (arXiv:2504.19413), a benchmarké dix approches distinctes de mémoire IA et validé l’approche d’extraction sélective — stocker des faits discrets, dédupliquer, et récupérer seulement ce qui est pertinent. Mem0 a grown à environ 48K étoiles GitHub et prend en charge 21 intégrations de frameworks. Le compromis est la dépendance au cloud et le coût.
La recherche sur le memory scaling de Databricks a introduit le concept que les performances des agents s’améliorent avec l’expérience accumulée. Leur architecture maintient des invites système, des actifs d’entreprise et des mémoires épisodiques/sémantiques scopées au niveau organisation et utilisateur, validant l’idée que la qualité de la mémoire compte autant que la capacité du modèle.
Le fil conducteur à travers la plupart des frameworks est qu’ils traitent la mémoire comme un problème de récupération : stocker quelque part, interroger quand c’est nécessaire, l’injecter dans le contexte. Hermes fait l’inverse — la mémoire n’est pas récupérée à la demande, elle est injectée au début de la session et toujours présente. Toujours active, toujours disponible, sélectionnée assez pour rester utile.
Partie 2 : Architecture
Lisez cette partie de haut en bas — les couches et le rappel/stockage par tour d’abord, puis ce qui vit dans MEMORY.md et USER.md, puis comment attacher un fournisseur externe.
Deux couches
Hermes empile la mémoire en deux couches :
- Intégrée (Built-in) —
MEMORY.mdetUSER.md, soutenues par des fichiers, toujours actives. Limites strictes de 2 200 caractères (notes de l’agent) et 1 375 caractères (profil utilisateur). - Un fournisseur externe (facultatif) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory et des pairs que vous activez via la configuration. Un seul backend externe fonctionne à la fois. Il ajoute la récupération et la rétention à côté des fichiers ; il ne les remplace pas.
Le modèle mental est additif — des fichiers de base figés plus au plus un plugin. Les hooks de prefetch et de sync orchestrent la couche externe ; les deux fichiers restent injectés séparément en tant que partie de l’invite système figée.
Flux d’exécution (préfect et synchro)
Le rappel se produit avant que le modèle ne réponde ; la persistance se produit après le message de l’assistant. Dans le gestionnaire de mémoire de Hermes Agent, cela correspond à prefetch à l’entrée et sync à la sortie. Les noms ci-dessous correspondent à la surface d’implémentation (MemoryManager, prefetch / sync_turn / queue_prefetch par fournisseur).
Message utilisateur
    |
    v
MemoryManager.prefetch_all(query)        <-- phase de rappel
    |
    +-- provider.prefetch(query)        <-- chaque fournisseur externe recherche dans son store
    |
    v
Contexte injecté dans le tour LLM
    |
    v
Le LLM répond (message assistant)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- phase de stockage
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- recherche en arrière-plan vers le tour suivant
La mémoire intégrée MEMORY.md et USER.md ne sont pas récupérée via prefetch_all — elles font déjà partie de l’invite système figée. Les backends externes s’adaptent à prefetch_all / sync_all ; queue_prefetch permet à un fournisseur de chauffer la récupération pour le tour suivant sans bloquer la réponse actuelle.
Trois chemins vers la mémoire à long terme
-
L’outil intégré
memory. Le modèle appellememoryavecadd,replaceouremovelorsque les instructions indiquent que quelque chose devrait persister — faits durables, préférences, corrections, notes d’environnement.target='user'maintient USER.md ;target='memory'maintient MEMORY.md. Forme d’exemple :memory(action='add', target='user', content='…'). -
Rétention passive sur les fournisseurs externes. À chaque tour, le framework invoque le chemin de synchro du fournisseur pour que la conversation puisse être découpée, résumée ou extraite sans que le modèle nomme chaque fait. Le comportement diffère selon le backend — par exemple Hindsight regroupe les tours et exécute une rétention structurée avec entités et relations ; Honcho envoie le dialogue à travers son pipeline dialectique ; les piles de type Mem0 et Supermemory extraient les faits passivement des tours.
-
Outils spécifiques aux fournisseurs. Lorsque le plugin les expose, des écritures explicites telles que
honcho_conclude,hindsight_retain, ouhoncho_profilestockent des tranches durables à la demande.
Rappel automatique par rapport aux outils de fournisseur
La mémoire de base n’a pas besoin d’un outil de lecture — elle est déjà dans l’invite. Les backends externes ajoutent soit une injection automatique depuis le prefetch (pas d’appel d’outil de rappel séparé pour cette tranche de contexte), soit des outils de récupération explicites (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect, et des pairs) lorsque le modèle a besoin d’une requête plus précise que le prefetch seul.
Modes de rappel (fournisseurs externes)
Les plugins prennent en charge un mode de rappel configurable (généralement recall_mode à côté de memory.provider dans la configuration) qui échange des jetons contre du contrôle.
| Mode | Injection auto depuis prefetch | Outils de fournisseur disponibles | Adaptation typique |
|---|---|---|---|
| contexte | Oui | Non | Main levée, contexte prévisible |
| outils | Non | Oui | Le modèle choisit quand récupérer |
| hybride | Oui | Oui | Contexte le plus riche ; utilisation de jetons plus élevée |
Lorsqu’aucun fournisseur externe n’est défini (memory.provider vide ou non défini), seules les fichiers intégrés et la recherche de session s’appliquent — pas de prefetch/sync depuis un plugin.
Chemins sur disque et budgets
La mémoire intégrée de Hermes Agent vit dans deux fichiers.
~/.hermes/memories/MEMORY.md— Notes personnelles de l’agent (2 200 caractères, ~800 jetons)~/.hermes/memories/USER.md— Profil utilisateur (1 375 caractères, ~500 jetons)
C’est toute la surface de mémoire persistante : deux fichiers, moins de 3 600 caractères au total, moins de 1 300 jetons. Cela semble délibérément petit parce que c’est le cas — et c’est exactement l’intention de conception.
MEMORY.md : Les notes de l’agent
C’est ici que l’agent stocke tout ce qu’il apprend sur son environnement, le projet, les outils, les conventions et les leçons apprises. Voici à quoi cela ressemble :
Le projet de l'utilisateur est un microservice Go dans ~/code/gateway utilisant gRPC + PostgreSQL
Cette machine exécute Ubuntu 22.04, a Docker et kubectl installés
L'utilisateur préfère snake_case pour les noms de variables et évite camelCase
Ce ne sont pas des journaux. Ce sont des faits. Denses, déclaratifs, chargés d’information. Pas de horodatages, pas de remplissage, pas de « le 5 janvier, l’utilisateur m’a demandé de… ».
USER.md : Le profil utilisateur
C’est ici que l’agent stocke tout ce qu’il sait sur vous.
L'utilisateur est un développeur full-stack à l'aise avec TypeScript, Go et Python.
L'utilisateur préfère snake_case pour les noms de variables et évite camelCase.
L'utilisateur utilise principalement Linux Ubuntu 22.04.
L'utilisateur déploie sur AWS en utilisant Terraform.
Identité, rôle, préférences, compétences techniques, style de communication, agacements. Les éléments qui font que l’agent répond différemment à vous qu’à n’importe qui d’autre.
Le motif de l’instantané figé (Frozen Snapshot Pattern)
Au début de la session, les deux fichiers sont chargés depuis le disque et injectés en tant que bloc figé dans l’invite système. Voici à quoi cela ressemble :
══════════════════════════════════════════════
MEMORY (vos notes personnelles) [7 % — 166/2 200 caractères]
══════════════════════════════════════════════
Le projet de l'utilisateur est un microservice Go dans ~/code/gateway utilisant gRPC + PostgreSQL
§
Cette machine exécute Ubuntu 22.04, a Docker et kubectl installés
§
L'utilisateur préfère snake_case pour les noms de variables et évite camelCase
§
══════════════════════════════════════════════
PROFIL UTILISATEUR (qui est l'utilisateur) [8 % — 110/1 375 caractères]
══════════════════════════════════════════════
L'utilisateur est un développeur full-stack à l'aise avec TypeScript, Go et Python.
§
L'utilisateur préfère snake_case pour les noms de variables et évite camelCase.
§
Le format utilise des en-têtes, des pourcentages d’utilisation, des comptes de caractères et des délimiteurs § (signe de section). Les entrées peuvent être multilignes. C’est conçu pour être analysable par le modèle tout en restant lisible pour l’homme.
Pourquoi figé ? Cache de préfixe (Prefix caching). L’invite système est la même à chaque tour d’une session. En maintenant la mémoire statique après le début de la session, le modèle peut mettre en cache le calcul du préfixe et ne traiter que les parties variables — la conversation. C’est une optimisation de performance significative. Vous ne recomputez pas l’attention sur les mêmes jetons de mémoire à chaque tour.
Les modifications effectuées pendant une session sont persistées sur disque immédiatement, mais elles n’apparaissent dans l’invite système qu’au début de la session suivante. Les réponses des outils montrent toujours l’état en direct, mais l’esprit du modèle ne change pas en cours de session. Cela empêche le modèle de courir après sa propre queue — mettre à jour la mémoire et réagir ensuite à sa propre mise à jour dans la même conversation.
Les limites de caractères comme fonctionnalité
2 200 caractères. 1 375 caractères. Ce ne sont pas des limites arbitraires. Ce sont des contraintes de conception qui forcent la curation.
La mémoire illimitée est un passif. Elle encourage à tout déverser, à ne jamais consolider, et à devenir finalement du bruit. La mémoire bornée force l’agent à être sélectif. Qu’est-ce qui est vraiment important ? De quoi aurai-je besoin à nouveau ? Qu’est-ce qui peut être compressé sans perdre de sens ?
Quand la mémoire est pleine, l’agent n’échoue pas simplement silencieusement. Il reçoit une erreur avec les entrées actuelles et l’utilisation, puis suit un flux de travail :
- Lire les entrées actuelles depuis la réponse d’erreur
- Identifier les entrées supprimables ou consolidables
- Utiliser
replacepour fusionner les entrées liées en versions plus courtes - Ajouter la nouvelle entrée
C’est ainsi que la mémoire reste utile. Ce n’est pas une base de données. C’est une collection sélectionnée de faits qui comptent.
Sécurité : Scan d’injection d’invite (Prompt Injection)
Chaque entrée de mémoire est scannée avant acceptation. Le système bloque les tentatives d’injection d’invite, l’exfiltration de credentials, les portes dérobées SSH et les caractères Unicode invisibles.
La mémoire est également dédupliquée. Les entrées en double exactes sont rejetées automatiquement. Cela empêche les adversaires de tenter d’injecter du contenu malveillant par des soumissions répétées.
Fournisseurs de mémoire externes (activation et liens)
Au-delà de MEMORY.md et USER.md intégrés, Hermes Agent peut attacher un plugin de mémoire externe à la fois — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, ou Supermemory — pour une connaissance persistante, inter-sessions. Un seul fournisseur externe est actif à la fois ; les deux fichiers de base restent chargés à côté (additif, pas remplacement).
Activez et inspectez les fournisseurs avec hermes memory setup, hermes memory status, et hermes memory off, ou définissez memory.provider et recall_mode dans ~/.hermes/config.yaml. Les motifs de credentials varient (par exemple HINDSIGHT_API_KEY, les clés Honcho sous $HERMES_HOME/honcho.json) ; utilisez hermes memory setup pour un câblage interactif.
Forme YAML minimale intégrée uniquement :
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Exemple d’activation pour un backend (remplacez hindsight par honcho, mem0, supermemory, ou d’autres que votre installation prend en charge) :
memory:
  provider: "hindsight"
Pour le tableau de comparaison complet, les notes de dépendance LLM et d’embedding, les analyses par fournisseur, et comment ces backends se rapportent à OpenClaw et d’autres piles, voir Fournisseurs de mémoire agent comparés. Pour un fournisseur local, auto-hébergé avec des contrôles d’écriture exceptionnellement granulaires, voir Mnemosyne pour Hermes Agent : Démarrage rapide mémoire locale — et Boucles de mémoire auto-renforçantes dans les agents IA pour comprendre pourquoi une mémoire bornée et sélectionnée comme MEMORY.md de Hermes évite par conception plusieurs modes d’échec de boucles de rétroaction.
Pour le câblage spécifique au profil et les flux de travail de production, voir configuration de production de Hermes Agent. Le hub Mémoire des Systèmes IA liste ce guide plus les articles liés sur Cognee et la couche de connaissances.
Partie 3 : Quand la mémoire s’active — Déclencheurs & Décisions
La question la plus courante sur la mémoire de Hermes Agent est quand elle enregistre réellement quelque chose.
La réponse est : constamment, mais sélectivement. L’agent gère sa propre mémoire via l’outil memory, et la décision d’enregistrer est pilotée par une combinaison de signaux explicites et de motifs implicites.
Déclencheurs d’écriture : Quand l’agent décide-t-il d’enregistrer ?
L’agent enregistre la mémoire proactivement. Il n’attend pas que vous le demandiez. Voici ce qui le déclenche.
Corrections utilisateur. Quand vous corrigez l’agent, c’est un signal pour se souvenir. « Ne faites plus ça. » « Utilisez ceci à la place. » « Rappelez-vous ceci. » Ce sont des instructions explicites pour mettre à jour la mémoire.
Exemple : vous demandez à l’agent de configurer un environnement Python. Il suggère pip. Vous dites « J’utilise poetry pour tout. » L’agent enregistre : L'utilisateur préfère utiliser le gestionnaire de paquets 'poetry' pour tous les projets Python.
Préférences découvertes. L’agent observe des motifs et infère des préférences. Si vous utilisez constamment un certain outil, framework ou flux de travail, cela est enregistré.
Exemple : après avoir vu vous utiliser poetry plusieurs fois à travers différents projets, l’agent l’enregistre en tant que préférence.
Faits d’environnement. Des choses à propos de la machine, du projet, des outils installés. Ces éléments sont découverts par l’exploration et enregistrés en tant que faits.
Exemple : l’agent vérifie ce qui est installé et enregistre : Cette machine exécute Ubuntu 22.04, a Docker et kubectl installés.
Conventions de projet. Comment le projet est structuré, quels outils il utilise, quels motifs il suit. Ces éléments sont découverts par l’inspection du code et enregistrés.
Exemple : Le projet de l'utilisateur est un microservice Go dans ~/code/gateway utilisant gRPC + PostgreSQL.
Flux de travail complexes terminés. Après avoir accompli une tâche qui a pris 5+ appels d’outils, l’agent envisage d’enregistrer l’approche en tant que compétence ou au moins de noter ce qui a marché.
Particularités et contournements d’outils. Quand l’agent découvre quelque chose de non évident à propos d’un outil, d’une API ou d’un système — une limitation, un contournement, une convention — il l’enregistre.
Ce qui est ignoré :
- L’information triviale ou évidente
- Les choses facilement redécouvertes
- Les déversements de données brutes
- Les éphémères spécifiques à la session
- L’information déjà dans les fichiers de contexte (SOUL.md, AGENTS.md)
Déclencheurs de lecture : Quand l’agent rappelle-t-il ?
La mémoire n’est pas récupérée — elle est toujours là. Mais il y a différents niveaux d’accès.
Début de session (automatique). MEMORY.md et USER.md sont injectés dans l’invite système. L’agent les a dès le premier jeton. Pas de requête nécessaire, pas de latence, pas d’appel d’outil. C’est la mémoire de base — toujours active.
session_search (à la demande). Quand l’agent a besoin de trouver quelque chose de conversations passées qui n’est pas dans la mémoire de base, il utilise l’outil session_search. Cela interroge SQLite (~/.hermes/state.db) avec la recherche full-text FTS5 et la summarization Gemini Flash. Utilisez ceci quand la question ressemble à « on a discuté de ça avant » plutôt que « souviens-toi de ce fait pour toujours. »
Exemple : vous demandez « A-t-on discuté de l’ réseau Docker la semaine dernière ? » L’agent recherche l’historique de session et retourne un résumé de la conversation pertinente.
Outils de fournisseur externe (quand configuré). Quand un fournisseur de mémoire externe est actif, le framework exécute également une étape de prefetch automatique avant chaque réponse (voir Partie 2). Des outils supplémentaires tels que honcho_search, hindsight_recall, ou mem0_search sont pour les recherches ciblées quand l’agent choisit la récupération explicite — dépendant de recall_mode, l’injection automatique, les outils, ou les deux peuvent être actifs.
L’arbre de décision
Voici comment l’agent pèse « est-ce que ça vaut la peine d’être rappelé ? » :
Est-ce une correction ou une instruction explicite ?
  OUI → Enregistrer dans la mémoire
  NON → Est-ce une préférence ou un motif ?
    OUI → Enregistrer dans le profil utilisateur
    NON → Est-ce un fait d'environnement ou une convention ?
      OUI → Enregistrer dans la mémoire
      NON → Est-ce facilement redécouvrable ?
        OUI → Ignorer
        NON → Est-ce spécifique à la session ?
          OUI → Ignorer
          NON → Enregistrer dans la mémoire
L’agent ne réfléchit pas trop à ça. Il enregistre proactivement, consolide quand c’est plein, et fait confiance aux limites de caractères pour garder les choses serrées.
Partie 4 : Mémoire interne par rapport aux bases de connaissances externes
C’est ici que la confusion se produit souvent. Hermes Agent a une mémoire interne (MEMORY.md, USER.md, fournisseurs externes) et des bases de connaissances externes (LLM Wiki, Obsidian, Notion, ArXiv, système de fichiers), et ils servent des rôles complètement différents. C’est similaire à la distinction entre les pipelines de génération augmentée par la récupération (retrieval-augmented generation) et la mémoire de travail de l’agent — la récupération externe est bonne pour les recherches de connaissances en profondeur, pas pour porter l’identité et les préférences. La mémoire interne est le cerveau de l’agent — toujours active, sélectionnée, portée dans chaque session. Les bases de connaissances externes sont sa bibliothèque — d’immenses ressources de référence consultées à la demande.
La distinction
Mémoire interne (le cerveau) :
- Petite, persistante, injectée dans l’invite système
- Contient : préférences utilisateur, conventions de l’agent, leçons immédiates
- Toujours « dans l’esprit » pendant la conversation
- Sélectionnée, bornée, activement gérée
- Exemples : MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Bases de connaissances externes (la bibliothèque) :
- Immense, en référence uniquement, accédée à la demande
- Contient : documents, articles, code, notes, bases de données
- Accédée via des outils quand nécessaire
- Pas « rappelée » — consultée
- Exemples : LLM Wiki, Obsidian, Notion, ArXiv, système de fichiers, GitHub
Comment ils se rapportent
L’agent accède aux bases externes via des outils quand nécessaire. Il ne les « rappelle » pas — il les consulte.
LLM Wiki (llm-wiki) : La base de connaissances Markdown interliée de Karpathy pour construire et interroger des connaissances de domaine. L’agent utilise la compétence llm-wiki pour le lire, le chercher et l’interroger. C’est une ressource de référence, pas de la mémoire.
Obsidian : Coffres de notes personnels avec liens bidirectionnels. L’agent utilise la compétence obsidian pour lire, chercher et créer des notes. Obsidian fait partie de l’écosystème plus large de gestion des connaissances personnelles dans lequel Hermes peut puiser en tant que ressource de bibliothèque.
Notion/Airtable : Bases de données et wikis structurés accédés via API. L’agent les interroge quand nécessaire.
ArXiv : Dépôts d’articles académiques. L’agent cherche et extrait des articles quand il recherche un sujet.
Système de fichiers : Code de projet, documentation, configurations. L’agent lit les fichiers quand il travaille sur un projet.
Le motif de distillation
Voici l’insight clé : les insights critiques des bases externes peuvent être distillés dans la mémoire interne.
Exemple : l’agent lit un article d’ArXiv sur le memory scaling pour les agents IA. Il n’enregistre pas tout l’article dans la mémoire. Il enregistre le point clé : Memory scaling : les performances de l'agent s'améliorent avec l'expérience accumulée grâce à l'interaction utilisateur et le contexte d'entreprise stockés dans la mémoire.
La ressource externe est immense. La mémoire interne est la distillation.
Quand utiliser quoi
Mémoire interne pour :
- « Qui est-ce que j’aide ? »
- « Qu’est-ce qu’ils préfèrent ? »
- « Qu’est-ce qu’on vient d’apprendre ? »
- « Quelle est la configuration du projet ? »
- « Quels outils sont disponibles ? »
Bases de connaissances externes pour :
- « Quelle est la dernière recherche sur X ? »
- « Qu’y a-t-il dans la documentation de mon projet ? »
- « De quoi avons-nous discuté le mois dernier ? »
- « Quelle est l’API de ce service ? »
- « Quelle est la structure du code ? »
L’agent comprend la différence et utilise chacun appropriately — il ne confond pas consulter un document avec se rappeler de quelque chose qu’il a appris sur vous et votre environnement.
Partie 5 : Comment ça fonctionne réellement
Regardons la mécanique.
L’outil memory
L’agent gère la mémoire à travers un outil unique avec trois actions : add, replace, remove.
Il n’y a pas d’action read — le contenu de la mémoire est auto-injecté dans l’invite système. L’agent n’a pas besoin de le lire parce qu’il est toujours là.
add — Ajoute une nouvelle entrée.
memory(action="add", target="memory",
       content="L'utilisateur exécute macOS 14 Sonoma, utilise Homebrew, a Docker Desktop installé.")
replace — Remplace une entrée existante en utilisant la correspondance de sous-chaîne.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="L'utilisateur préfère le mode clair dans VS Code, le mode sombre dans le terminal")
remove — Supprime une entrée en utilisant la correspondance de sous-chaîne.
memory(action="remove", target="memory",
       old_text="fait de projet temporaire")
Correspondance de sous-chaîne
replace et remove utilisent de courtes sous-chaînes uniques via old_text. Vous n’avez pas besoin du texte complet de l’entrée. Cela rend possibles des éditions chirurgicales sans connaître le contenu exact.
Si une sous-chaîne correspond à plusieurs entrées, une erreur est retournée demandant une correspondance plus spécifique. L’agent raffine ensuite sa requête.
Stockages cible : memory par rapport à user
Le paramètre target détermine quel fichier est mis à jour.
memory— Notes personnelles de l’agent. Faits d’environnement, conventions de projet, particularités d’outils, leçons apprises.user— Profil utilisateur. Identité, rôle, fuseau horaire, préférences de communication, agacements, habitudes de flux de travail.
Gestion de capacité
Quand la mémoire est >80 % pleine, l’agent consolide. Il fusionne les entrées liées, supprime les faits obsolètes et compresse l’information.
Les bonnes entrées de mémoire sont compactes et denses en information :
L'utilisateur exécute macOS 14 Sonoma, utilise Homebrew, a Docker Desktop installé. Shell : zsh avec oh-my-zsh. Éditeur : Neovim avec le plugin Telescope.
Les mauvaises entrées de mémoire sont vagues ou verbales :
L'utilisateur a un projet.
Le 5 janvier 2026, l'utilisateur m'a demandé de regarder son projet situé dans ~/code/gateway et il utilise Go avec gRPC et PostgreSQL pour la couche de base de données.
Le premier est dense et utile. Le second est soit trop vague, soit trop verbeux.
Recherche de session par rapport à la mémoire persistante
session_search et la mémoire persistante servent des purposes différentes.
| Fonctionnalité | Mémoire persistante | Recherche de session |
|---|---|---|
| Capacité | ~1 300 jetons au total | Illimitée (toutes les sessions) |
| Vitesse | Instantanée (dans l’invite système) | Nécessite recherche + summarization LLM |
| Cas d’utilisation | Faits clés toujours disponibles | Trouver des conversations passées spécifiques |
| Gestion | Sélectionnée manuellement par l’agent | Automatique — toutes les sessions stockées |
| Coût en jetons | Fixe par session (~1 300 jetons) | À la demande (cherché quand nécessaire) |
Règle générale : utilisez la mémoire pour les faits critiques qui doivent toujours être dans le contexte. Utilisez la recherche de session pour les recherches historiques.
Partie 6 : La philosophie
Pourquoi la mémoire bornée bat la mémoire illimitée
L’instinct est de rendre la mémoire aussi grande que possible. Tout stocker. Récupérer ce dont vous avez besoin.
La mémoire bornée fonctionne mieux. Voici pourquoi.
La curation force la qualité. Quand vous avez un espace limité, vous n’enregistrez que ce qui compte. Vous compressez, consolidez et priorisez. La mémoire illimitée encourage à tout déverser et à ne jamais nettoyer.
La vitesse compte. 1 300 jetons dans l’invite système, c’est rapide. 100 000 jetons récupérés d’une base de données, c’est lent. La mémoire doit être instantanée, pas une requête.
Le bruit dégrade les performances. Plus de mémoire n’est pas une meilleure mémoire. C’est une mémoire plus bruyante. Le modèle doit distinguer le signal du bruit, et cela prend de l’attention — une attention qui devrait être dépensée sur la tâche réelle.
Oublier est une fonctionnalité. La mémoire humaine oublie. Ce n’est pas un bug — c’est comment nous priorisons. Les agents devraient aussi oublier. Tout ne mérite pas d’être rappelé.
Le problème de « l’oubli »
Les agents doivent désapprendre. Pas juste oublier, mais activement retirer l’information obsolète.
Voici comment Hermes Agent le gère :
- Action
remove: Supprimer les entrées qui ne sont plus pertinentes. - Action
replace: Mettre à jour les entrées avec de nouvelles informations. - Pression de capacité : Quand la mémoire est pleine, l’agent consolide et supprime les anciennes entrées.
- Scan de sécurité : Bloque les entrées malveillantes ou corrompues.
Oublier n’est pas un échec — c’est de la maintenance. Un agent qui ne peut pas désapprendre finira par porter autant de bruit que de signal.
Memory Scaling
Databricks a introduit le concept de « memory scaling » : un agent avec des milliers d’utilisateurs performe-t-il mieux qu’un avec un seul utilisateur ?
Leur recherche suggère oui, mais avec des précautions. Le memory scaling nécessite :
- Extraction de qualité : Toutes les interactions ne valent pas la peine d’être rappelées. L’agent doit extraire des insights, pas des journaux.
- Récupération efficace : Les mémoires récupérées doivent être pertinentes. Le bruit dégrade les performances.
- Généralisation : Les mémoires devraient être des motifs, pas des spécificités. « L’utilisateur préfère Python » passe à l’échelle. « L’utilisateur a exécuté la commande X à l’horodatage Y » non.
La mémoire bornée de Hermes Agent prend naturellement en charge le memory scaling. En forçant la curation, elle assure que les mémoires sont généralisables, compactes et utiles.
Ce que cela signifie pour le futur
La mémoire devient le fossé concurrentiel dans l’IA agentique — pas le modèle lui-même, mais ce que le modèle porte entre les sessions. Deux agents avec des modèles sous-jacents identiques peuvent performer très différemment : l’un se souvient de vos préférences, de votre environnement et de vos erreurs passées ; l’autre repart à froid chaque fois.
La question n’est plus si les agents devraient avoir une mémoire persistante. C’est réglé : ils doivent. La question ouverte est comment concevoir cette mémoire bien — quoi garder, quoi jeter, comment la rendre instantanée, et comment empêcher qu’elle devienne du bruit.
La réponse de Hermes Agent est de garder la mémoire petite, sélectionnée et toujours active — pas une base de données que l’on interroge, mais un modèle de travail de l’utilisateur que l’agent porte avec lui dans chaque conversation.
Conclusion
Le système de mémoire de Hermes Agent est délibérément simple : deux fichiers, des limites de caractères fermes, pas de pipeline de récupération, pas de base de données vectorielle, et pas de latence par requête. Ce qui semble être une contrainte est le point central.
Ça marche parce que cela traite la mémoire comme un cerveau fonctionne, plutôt que comme une base de données — petite, sélectionnée et toujours active. L’agent ne récupère pas la mémoire quand il en a besoin ; la mémoire est simplement toujours là, tissée dans l’invite système dès le premier jeton de chaque session.
Les fournisseurs de mémoire externe étendent ce système pour les utilisateurs qui en ont besoin : graphes de connaissances, support multi-agents, stockage auto-hébergé, fonctionnalités d’entreprise. Mais le cœur reste le même : borné, sélectionné, toujours disponible.
Et les bases de connaissances externes — LLM Wiki, Obsidian, Notion, ArXiv — servent un rôle différent. Ce sont la bibliothèque, pas le cerveau. L’agent les consulte, ne les rappelle pas. Les insights critiques sont distillés dans la mémoire interne ; le reste reste dans la bibliothèque.
C’est ainsi qu’un agent IA se souvient de vous. Pas en stockant tout, mais en se rappelant de ce qui compte.
Hermes Agent a été publié par Nous Research en février 2026 et a atteint plus de 64 000 étoiles GitHub d’ici avril 2026 (v0.9.0), avec plus de 242 contributeurs. Il est open-source et disponible sur github.com/NousResearch/hermes-agent. Pour les guides d’installation, de configuration et de flux de travail, voir l’aperçu de Hermes Agent.
