Selfhosting

Bucles de memoria autorreforzantes en agentes de IA: causas y soluciones

Bucles de memoria autorreforzantes en agentes de IA: causas y soluciones

«Cuando las conclusiones recordadas se convierten en nueva evidencia».

La memoria persistente convierte a un agente de una herramienta que requiere explicaciones constantes en uno que transporta el contexto hacia adelante, pero abre un modo de fallo que el chat sin estado evita: una interpretación puede convertirse en memoria, ser recuperada como hecho y justificar una versión más fuerte de sí misma.
Mnemosyne para Hermes Agent: guía de inicio rápido de memoria local

Mnemosyne para Hermes Agent: guía de inicio rápido de memoria local

Memoria local de Hermes con escrituras controladas.

Mnemosyne es un proveedor de memoria local-first para Hermes Agent, que almacena memoria de trabajo, hechos estructurados, datos temporales e historial episódico en SQLite local: sin servicios alojados, sin llamadas de red obligatorias y con un control de escritura inusualmente granular.

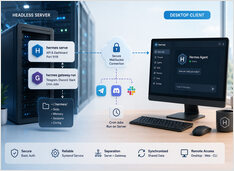
Cómo migrar de OpenClaw a Hermes Agent de forma segura

Cómo migrar de OpenClaw a Hermes Agent de forma segura

Un cambio seguro más allá de la importación de una sola línea

Migrar un asistente de IA no es lo mismo que copiar la configuración de una aplicación. La parte difícil consiste en preservar la identidad, la memoria, el comportamiento de las herramientas, las tareas programadas y el acceso a los mensajes, evitando que dos pasarelas actúen como el mismo bot.

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

Por qué el contexto de 128K falla con 16 GB

Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.

Gravedad de los datos: el verdadero coste de la IA API-first

Gravedad de los datos: el verdadero coste de la IA API-first

Por qué su stack de IA se vuelve más dependiente cada mes.

Cada llamada a la API parece una transacción sencilla, hasta que se acumulan lo suficiente como para que tus datos de ajuste fino, tus entornos de evaluación y tus esquemas de herramientas se adapten a un solo proveedor, momento en el cual cambiar deja de ser un ajuste de enrutamiento.

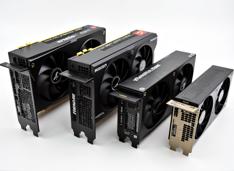
GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.

Instalar Docker en Ubuntu: APT, Snap, Rootless — Guía completa 2026

Instalar Docker en Ubuntu: APT, Snap, Rootless — Guía completa 2026

Seleccione la ruta de instalación de Docker adecuada en Ubuntu.

La instalación de Docker en Ubuntu debería ser sencilla, pero en la práctica, varias opciones con forma de Docker compiten por el mismo nombre de comando, cada una con diferente empaquetado, comportamiento de actualización e implicaciones de seguridad.

Sistemas de memoria en asistentes de IA

Sistemas de memoria en asistentes de IA

Memoria de trabajo, estructurada y de recuperación para asistentes.

La memoria transforma a los asistentes de reactivos a persistentes, pero también es donde muchos sistemas se deterioran silenciosamente. Los análisis argumentan que la división entre memoria a corto y largo plazo ya no es suficiente para la memoria de agentes modernos; los SDK de OpenAI y LangGraph apuntan a un stack más simple: memoria de trabajo, estado durable y recuperación.