Hardware

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

Por qué el contexto de 128K falla con 16 GB

Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.
Gravedad de los datos: el verdadero coste de la IA API-first

Gravedad de los datos: el verdadero coste de la IA API-first

Por qué su stack de IA se vuelve más dependiente cada mes.

Cada llamada a la API parece una transacción sencilla, hasta que se acumulan lo suficiente como para que tus datos de ajuste fino, tus entornos de evaluación y tus esquemas de herramientas se adapten a un solo proveedor, momento en el cual cambiar deja de ser un ajuste de enrutamiento.

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

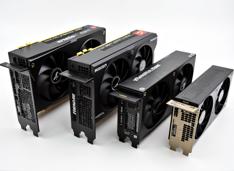
Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.