
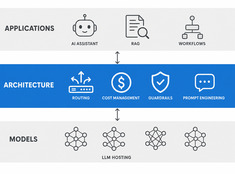
Arquitectura de LLM: Diseño de sistemas para IA en producción
Design decisions for production LLM systems — routing, cost, guardrails, and multi-model orchestration. The layer between running models and building reliable AI applications.
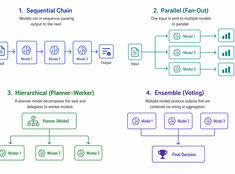
Elige el patrón más sencillo que funcione.
Los sistemas de un solo modelo son simples. Los sistemas de múltiples modelos son potentes. El desafío no consiste en elegir modelos, sino en diseñar la arquitectura que los orqueste.
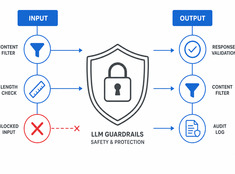
Controla el riesgo, no solo el modelo.
Los LLMs son impredecibles. Hallucinan, filtran datos, generan contenido dañino o rechazan solicitudes legítimas. Los guardrails (mecanismos de contención) limitan el comportamiento del modelo sin sacrificar capacidad.
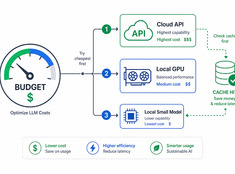
Gasta tokens donde realmente importan.
Los costos de los LLM escalan de forma lineal con el uso. Un sistema que procesa 10.000 solicitudes al día a 0,01 dólares por solicitud cuesta 100 dólares diarios, es decir, 365 dólares al año. A escala empresarial, eso supera los 10.000 dólares.
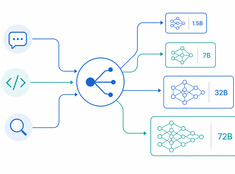
El modelo adecuado para la tarea correcta.
Ejecutar un modelo de 70 mil millones de parámetros para resumir un correo electrónico de 200 palabras es un desperdicio. Ejecutar un modelo de 3 mil millones de parámetros para revisar código de producción es imprudente. La mayoría de los sistemas se sitúan en algún punto intermedio, y es precisamente ahí donde entra en juego el enrutamiento de modelos.
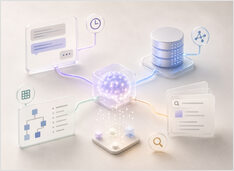
Memoria de trabajo, estructurada y de recuperación para asistentes.
La memoria transforma a los asistentes de reactivos a persistentes, pero también es donde muchos sistemas se deterioran silenciosamente. Los análisis argumentan que la división entre memoria a corto y largo plazo ya no es suficiente para la memoria de agentes modernos; los SDK de OpenAI y LangGraph apuntan a un stack más simple: memoria de trabajo, estado durable y recuperación.
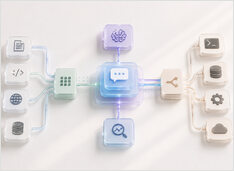
Cómo se construyen realmente los asistentes serios.
Un asistente de IA de producción no es “un LLM con un prompt”. Es un sistema que acepta la intención, mantiene el estado, decide cuándo recuperar o actuar, y expone suficiente detalle de tiempo de ejecución para depurar fallos.
La IA transforma la gestión del conocimiento, no su propósito.
La IA no está reemplazando la gestión del conocimiento; está cambiando su forma tanto para individuos como para equipos.
¿Estrellas, tokens, descargas… quién gana realmente?
Los marcos de agentes de IA de código abierto están experimentando una explosión de popularidad en GitHub. Dos proyectos en el centro del ecosistema de sistemas de IA autoalojados — OpenClaw y Hermes Agent — se han adelantado tanto que el resto del campo compite por un distante tercer lugar.
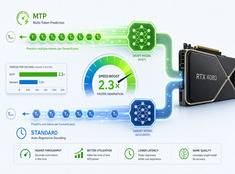
MTP frente a la decodificación estándar en RTX 4080 — benchmarks reales
Probé el rendimiento de la decodificación especulativa (Predicción Multi-token, MTP) en Qwen 3.6 27B y 35B en una RTX 4080 con 16 GB de VRAM.
VRAM libre sin detener llama-server.
Modo router de llama.cpp es uno de los cambios más útiles en llama-server en años. Finalmente ofrece a los operadores de LLM locales una experiencia de gestión de modelos cercana a la que las personas esperan de Ollama, manteniendo al mismo tiempo el rendimiento bruto y el control a bajo nivel que hacen que llama.cpp valga la pena usarlo en primer lugar.
Conocimiento compilado para sistemas de IA
La premisa es simple: el conocimiento compilado es más reutilizable que los fragmentos recuperados. RAG se convirtió en la respuesta predeterminada a una pregunta directa: ¿cómo proporciono a un LLM acceso a conocimiento externo?
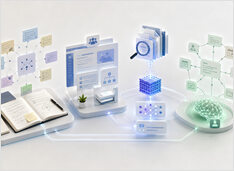
Un mapa de los sistemas de conocimiento modernos
La gestión del conocimiento personal (PKM), la generación aumentada por recuperación (RAG), las wikis, los sistemas de memoria de IA y, ahora, los flujos de trabajo prácticos asistidos por IA, suelen discutirse como si resolvieran el mismo problema. No es así. Todos tratan con el conocimiento, pero operan en diferentes capas:
Deja de interpretar sensaciones. Valida contratos.
La mayoría de los tutoriales sobre “salida estructurada” de los LLM son poco serios. Te enseñan a pedir JSON amablemente y luego a esperar que el modelo se comporte. Eso no es validación. Eso es optimismo con llaves.
Referencia de ajuste de LLMs agénticos
Esta página es una referencia práctica para la afinación de inferencia de LLMs agentivos (temperatura, top_p, top_k, penalizaciones y cómo interactúan en flujos de trabajo multietapa y con uso intensivo de herramientas).
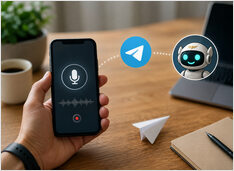
Habla con Hermes desde tu teléfono
Ya puedes chatear con Hermes Agent desde tu teléfono usando texto. Ahora quieres hablar con él directamente y recibir respuestas habladas. Eso suele ser la mejor opción, especialmente si ya usas Hermes como asistente autohospedado persistente. Escribir instrucciones largas en una pantalla pequeña es lento y propenso a errores.