
Sistema de memoria del agente Hermes: cómo funciona realmente la memoria persistente de la IA
La memoria es la diferencia entre una herramienta y un socio.
Ya sabes cómo funciona. Abres un chat con un agente de IA, explicas tu proyecto, compartes tus preferencias, terminas cierta cantidad de trabajo y cierras la pestaña. Vuelves la semana siguiente y es como hablar con un desconocido: todo el contexto ha desaparecido, cada preferencia ha sido olvidada y el proyecto se vuelve a explicar desde cero.
Esto no es un error. Es así como funcionan por diseño los Modelos de Lenguaje Grandes (LLM). Son sin estado (stateless): cada solicitud es independiente, cada respuesta se genera a partir de lo que envíes en ese momento, sin memoria, sin historial y sin continuidad más allá de los tokens en la ventana de contexto actual.
Para interacciones de un solo turno, está bien. Haces una pregunta, obtienes una respuesta y avanzas. Pero para los agentes: sistemas que están supuestos a hacer cosas a través de sesiones, aprender de los errores y evolucionar contigo, la ausencia de estado es un límite arquitectónico difícil. Es uno de los problemas centrales sin resolver en sistemas de IA autoalojados.
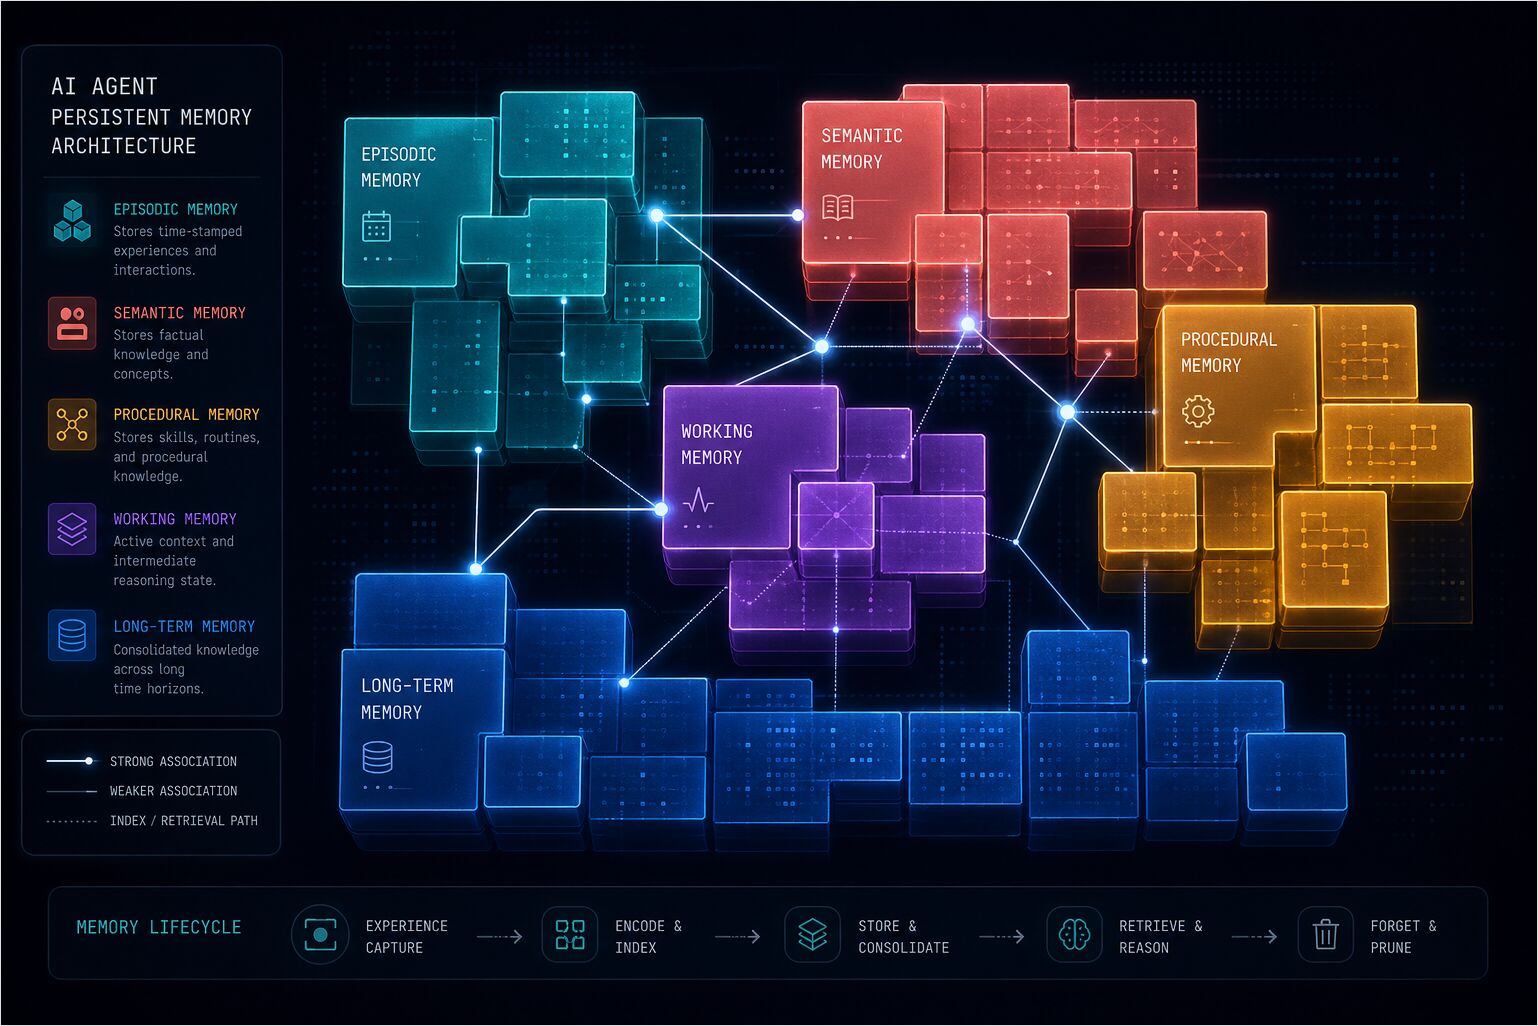
La industria ha intentado resolver esto. LangChain añadió módulos de memoria. OpenAI introdujo asistentes con hilos (threads). Marcos de trabajo como Letta, Zep y Cognee construyeron arquitecturas completas alrededor de la memoria persistente. Databricks publicó sobre el “escalado de memoria” — la idea de que el rendimiento del agente mejora con la experiencia acumulada. Papeles de evaluación dedicados (benchmarks), revisiones de memoria episódica y un ecosistema en rápido crecimiento de herramientas han surgido desde 2024 para abordar lo que se reconoce cada vez más como uno de los problemas centrales sin resolver en la IA agéntica.
La mayoría de estos enfoques comparten un problema común: tratan la memoria como algo a posteriori — una base de datos a la que hacer consultas, una ventana de contexto que llenar, un sistema de recuperación que añade latencia y ruido en lugar de claridad.
Hermes Agent toma un enfoque fundamentalmente diferente. La memoria no es algo que el agente recupera cuando lo necesita. Es algo que el agente es todo el tiempo: integrado en el prompt del sistema, curado, acotado y siempre activo. Es lo suficientemente pequeña para ser rápida, lo suficientemente estructurada para ser útil y lo suficientemente disciplinada para saber qué olvidar.
Este artículo explica exactamente cómo funciona — la capa específica de Hermes dentro del modelo inter-marcos de Sistemas de Memoria en Asistentes de IA y la pila más amplia en Arquitectura de Asistentes de IA. Para comandos de activación e inspección (hermes memory, hermes dump, registro de cola), combínalo con la hoja de referencia de la CLI de Hermes Agent. Para el lado complementario del “conocimiento a largo plazo” de Hermes —procedimientos reutilizables en SKILL.md en lugar de archivos de memoria curados—, vea Redacción de Habilidades para Hermes Agent: Estructura de SKILL.md y Mejores Prácticas.
Parte 1: El Problema de la Memoria en Agentes de IA
Por qué “Solo añadir contexto” no escala para agentes
La solución obvia para la IA sin estado es añadir contexto. Adjunta la conversación anterior. Incluye la documentación del proyecto. Envía todo el historial.
Durante un tiempo, eso funciona. Tienes una ventana de contexto de 128K. Puedes ajustar mucho texto allí.
Pero el contexto no es memoria — hay una diferencia real e importante entre ambos. El contexto es todo lo que se te muestra ahora mismo; la memoria es lo que mantienes activamente y llevas contigo.
El contexto no tiene curación. Es un volcado: a medida que crece, el modelo debe procesar miles de tokens de historial irrelevante para encontrar el único hecho que necesita. Eso costa tokens y dinero, multiplica la latencia y eventualmente choca con el límite.
La memoria está curada. Es la destilación de la experiencia en algo compacto y accionable. No crece indefinidamente: se consolida, se actualiza y olvida.
La memoria humana funciona de la misma manera. No recuerdas cada conversación que has tenido. Recuerdas las partes que importan: con quién estás hablando, qué les importa, en qué han acordado, qué has aprendido. El resto se olvida o es buscable cuando lo necesitas.
El panorama de la investigación
El espacio de memoria para agentes de IA se ha disparado desde 2024, con suites de evaluación dedicadas, una creciente literatura de investigación y una brecha de rendimiento medible entre diferentes enfoques arquitectónicos. Aquí está la situación actual.
Letta (anteriormente MemGPT) fue uno de los primeros marcos de trabajo que trataron la memoria persistente como una preocupación de primer nivel, alcanzando 21.7K estrellas en GitHub. Utiliza un modelo de tres niveles inspirado en sistemas operativos: memoria principal (pequeña, siempre en contexto), memoria de recuperación (historial de conversaciones buscable) y memoria de archivo (almacenamiento en frío a largo plazo). El洞察 de que no toda la memoria es igual era correcto. Sin embargo, la implementación requiere que los agentes se ejecuten completamente dentro del entorno de ejecución de Letta; adoptarlo significa adoptar toda la plataforma, no solo una capa de memoria.
Zep / Graphiti se centra en la memoria conversacional con seguimiento temporal de entidades — los hechos llevan ventanas de validez para que el grafó sepa cuándo algo fue verdadero. Es fuerte para chatbots que necesitan grafos de relaciones, pero menos adecuado para agentes autónomos que rastrean hechos del entorno y convenciones de proyecto.
Cognee está diseñado para la extracción de conocimientos de documentos y datos estructurados, con más de 30 conectores de ingesta y un backend de grafo de conocimiento. Excela en el conocimiento institucional y en pipelines de RAG pero se centra menos en la memoria personal del agente. Vea autoalojar Cognee con LLMs locales para una guía de configuración práctica.
Hindsight realiza recuperación basada en grafos de conocimiento con relaciones entre entidades y una herramienta de síntesis única reflect que realiza síntesis inter-memorias — combinando múltiples memorias en nuevos insights. Está entre los principales rendimiento en las pruebas de memoria de agentes y está disponible como proveedor de memoria para Hermes Agent.
Mem0 maneja la extracción de memoria en el servidor mediante análisis de LLM, requiriendo mínima configuración. El papel de investigación de Mem0, publicado en ECAI 2025 (arXiv:2504.19413), evaluó diez enfoques distintos para la memoria de IA y validó el enfoque de extracción selectiva — almacenando hechos discretos, eliminando duplicados y recuperando solo lo relevante. Mem0 ha crecido a aproximadamente 48K estrellas en GitHub y soporta 21 integraciones de marcos de trabajo. La compensación es la dependencia de la nube y el costo.
La investigación de escalado de memoria de Databricks introdujo el concepto de que el rendimiento del agente mejora con la experiencia acumulada. Su arquitectura mantiene prompts de sistema, activos empresariales y memorias episódicas/semánticas enmarcadas a nivel de organización y usuario, validando la idea de que la calidad de la memoria importa tanto como la capacidad del modelo.
El hilo común entre la mayoría de los marcos de trabajo es que tratan la memoria como un problema de recuperación: guárdalo en algún lugar, consúltalo cuando lo necesites, inyéctalo en el contexto. Hermes hace lo contrario: la memoria no se recupera bajo demanda, se inyecta al inicio de la sesión y siempre está presente. Siempre activa, siempre disponible, lo suficientemente curada para mantenerse útil.
Parte 2: Arquitectura
Lea esta parte de arriba hacia abajo: capas y recuperación/almacenamiento por turno primero, luego qué vive en MEMORY.md y USER.md, y luego cómo adjuntar un proveedor externo.
Dos capas
Hermes apila la memoria en dos capas:
- Integrada —
MEMORY.mdyUSER.md, respaldadas por archivos, siempre activas. Límites duros de 2,200 caracteres (notas del agente) y 1,375 caracteres (perfil del usuario). - Un proveedor externo (opcional) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory y pares que activas mediante configuración. Solo uno backend externo se ejecuta a la vez. Añade recuperación y retención junto a los archivos; no los reemplaza.
El modelo mental es aditivo: archivos principales congelados más como máximo un complemento. Los hooks de prefetch y sincronización orquestan la capa externa; los dos archivos permanecen inyectados por separado como parte del prompt de sistema congelado.
Flujo de tiempo de ejecución (prefetch y sincronización)
La recuperación ocurre antes de que el modelo responda; la persistencia ocurre después del mensaje del asistente. En el gestor de memoria de Hermes Agent, esto se traduce en prefetch en la entrada y sync en la salida. Los nombres a continuación coinciden con la superficie de implementación (MemoryManager, prefetch / sync_turn / queue_prefetch por proveedor).
Mensaje del usuario
    |
    v
MemoryManager.prefetch_all(query)        <-- fase de recuperación
    |
    +-- provider.prefetch(query)        <-- cada proveedor externo busca en su almacén
    |
    v
Contexto inyectado en el turno del LLM
    |
    v
El LLM responde (mensaje del asistente)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- fase de almacenamiento
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- búsqueda en segundo plano hacia el siguiente turno
La integrada MEMORY.md y USER.md no se recupera a través de prefetch_all: ya son parte del prompt de sistema congelado. Los backends externos se conectan a prefetch_all / sync_all; queue_prefetch permite a un proveedor calentar la recuperación para el turno siguiente sin bloquear la respuesta actual.
Tres rutas hacia la memoria a largo plazo
-
Herramienta integrada
memory. El modelo llama amemoryconadd,replaceoremovecuando las instrucciones indican que algo debe persistir: hechos duraderos, preferencias, correcciones, notas del entorno.target='user'mantiene USER.md;target='memory'mantiene MEMORY.md. Forma de ejemplo:memory(action='add', target='user', content='…'). -
Retención pasiva en proveedores externos. Cada turno, el marco de trabajo invoca la ruta de sincronización del proveedor para que la conversación pueda fragmentarse, resumirse o extraerse sin que el modelo nombre cada hecho. El comportamiento difiere según el backend; por ejemplo, Hindsight agrupa turnos y ejecuta retención estructurada con entidades y relaciones; Honcho envía el diálogo a través de su pipeline dialéctico; las pilas de estilo Mem0 y Supermemory extraen hechos pasivamente de los turnos.
-
Herramientas específicas del proveedor. Cuando el complemento las expone, escrituras explícitas como
honcho_conclude,hindsight_retainohoncho_profilealmacenan fragmentos duraderos bajo demanda.
Recuperación automática frente a herramientas de proveedor
La memoria principal no necesita una herramienta de lectura: ya está en el prompt. Los backends externos añaden ya sea inyección automática desde prefetch (sin llamada de herramienta de recuperación separada para esa porción de contexto) o herramientas de recuperación explícitas (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect, y pares) cuando el modelo necesita una consulta más precisa que solo prefetch.
Modos de recuperación (proveedores externos)
Los complementos admiten un modo de recuperación configurable (típicamente recall_mode junto a memory.provider en la configuración) que intercambia tokens por control.
| Modo | Inyección automática desde prefetch | Herramientas de proveedor disponibles | Ajuste típico |
|---|---|---|---|
| context | Sí | No | Sin manos, contexto predecible |
| tools | No | Sí | El modelo elige cuándo recuperar |
| hybrid | Sí | Sí | Contexto más rico; mayor uso de tokens |
Cuando no se establece un proveedor externo (memory.provider vacío o no definido), solo aplican los archivos integrados y la búsqueda de sesión: sin prefetch/sincronización desde un complemento.
Rutas en disco y presupuestos
La memoria integrada de Hermes Agent vive en dos archivos.
~/.hermes/memories/MEMORY.md— Notas personales del agente (2,200 caracteres, ~800 tokens)~/.hermes/memories/USER.md— Perfil del usuario (1,375 caracteres, ~500 tokens)
Eso es toda la superficie de memoria persistente: dos archivos, menos de 3,600 caracteres en total, menos de 1,300 tokens. Parece deliberadamente pequeña porque lo es, y esa es exactamente la intención de diseño.
MEMORY.md: Las Notas del Agente
Aquí es donde el agente almacena todo lo que aprende sobre su entorno, el proyecto, herramientas, convenciones y lecciones aprendidas. Así es como se ve:
El proyecto del usuario es un micrservicio Go en ~/code/gateway usando gRPC + PostgreSQL
Esta máquina ejecuta Ubuntu 22.04, tiene Docker y kubectl instalados
El usuario prefiere snake_case para nombres de variables y evita camelCase
Estas no son registros. Son hechos. Densos, declarativos, cargados de información. Sin marcas de tiempo, sin relleno, sin “el 5 de enero el usuario me pidió…”.
USER.md: El Perfil del Usuario
Aquí es donde el agente almacena todo lo que sabe sobre ti.
El usuario es un desarrollador full-stack cómodo con TypeScript, Go y Python.
El usuario prefiere snake_case para nombres de variables y evita camelCase.
El usuario usa principalmente Linux Ubuntu 22.04.
El usuario despliega en AWS usando Terraform.
Identidad, rol, preferencias, habilidades técnicas, estilo de comunicación, disgustos. Las cosas que hacen que el agente responda de manera diferente a ti que a cualquier otra persona.
El Patrón de Instantánea Congelada
Al inicio de la sesión, ambos archivos se cargan desde el disco e inyectan como un bloque congelado en el prompt de sistema. Así es como se ve:
══════════════════════════════════════════════
MEMORIA (tus notas personales) [7% — 166/2,200 chars]
══════════════════════════════════════════════
El proyecto del usuario es un micrservicio Go en ~/code/gateway usando gRPC + PostgreSQL
§
Esta máquina ejecuta Ubuntu 22.04, tiene Docker y kubectl instalados
§
El usuario prefiere snake_case para nombres de variables y evita camelCase
§
══════════════════════════════════════════════
PERFIL DEL USUARIO (quién es el usuario) [8% — 110/1,375 chars]
══════════════════════════════════════════════
El usuario es un desarrollador full-stack cómodo con TypeScript, Go y Python.
§
El usuario prefiere snake_case para nombres de variables y evita camelCase.
§
El formato usa encabezados, porcentajes de uso, recuento de caracteres y delimitadores § (signo de sección). Las entradas pueden ser de varias líneas. Está diseñado para que sea parseable por el modelo mientras permanece legible para humanos.
¿Por qué congelado? Cacheo de prefijo. El prompt de sistema es el mismo en cada turno de una sesión. Manteniendo la memoria estática después del inicio de la sesión, el modelo puede almacenar en caché el cálculo del prefijo y solo procesar las partes variables: la conversación. Esta es una optimización de rendimiento significativa. No está re-calcando la atención sobre los mismos tokens de memoria en cada turno.
Los cambios realizados durante una sesión persisten en el disco inmediatamente, pero solo aparecen en el prompt de sistema al inicio de la siguiente sesión. Las respuestas de herramientas siempre muestran el estado en vivo, pero la “mente” del modelo no cambia a mitad de la sesión. Esto previene que el modelo persiga su propia cola: actualizando la memoria y luego reaccionando a su propia actualización en la misma conversación.
Los Límites de Caracteres como Característica
2,200 caracteres. 1,375 caracteres. Estos no son límites arbitrarios. Son restricciones de diseño que fuerzan la curación.
La memoria ilimitada es una carga. Anima a volcar todo, nunca consolidar y eventualmente convertirse en ruido. La memoria acotada fuerza al agente a ser selectivo. ¿Qué es realmente importante? ¿Qué necesitaré de nuevo? ¿Qué se puede comprimir sin perder significado?
Cuando la memoria está llena, el agente no falla simplemente en silencio. Recibe un error con las entradas actuales y el uso, y luego sigue un flujo de trabajo:
- Leer las entradas actuales desde la respuesta de error
- Identificar entradas eliminables o consolidables
- Usar
replacepara fusionar entradas relacionadas en versiones más cortas - Añadir la nueva entrada
Así es como la memoria se mantiene útil. No es una base de datos. Es una colección curada de hechos que importan.
Seguridad: Escaneo de Inyección de Prompts
Cada entrada de memoria se escanea antes de aceptarse. El sistema bloquea intentos de inyección de prompts, extracción de credenciales, puertas traseras SSH y caracteres Unicode invisibles.
La memoria también se elimina de duplicados. Las entradas duplicadas exactas se rechazan automáticamente. Esto previene que los adversarios intenten inyectar contenido malicioso a través de envíos repetidos.
Proveedores de memoria externos (activación y enlaces)
Más allá de la integrada MEMORY.md y USER.md, Hermes Agent puede adjuntar un complemento de memoria externa a la vez — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover o Supermemory — para conocimiento persistente e inter-sesiones. Solo un proveedor externo está activo a la vez; los dos archivos principales permanecen cargados junto a él (aditivo, no reemplazo).
Active y examine proveedores con hermes memory setup, hermes memory status y hermes memory off, o establezca memory.provider y recall_mode en ~/.hermes/config.yaml. Los patrones de credenciales varían (por ejemplo, HINDSIGHT_API_KEY, claves de Honcho bajo $HERMES_HOME/honcho.json); use hermes memory setup para el cableado interactivo.
Forma YAML mínima solo integrada:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Ejemplo de activación para un backend (cambie hindsight por honcho, mem0, supermemory u otros que su instalación soporte):
memory:
  provider: "hindsight"
Para la tabla de comparación completa, notas sobre dependencias de LLM y embeddings, desgloses por proveedor y cómo estos backends se relacionan con OpenClaw y otras pilas, vea Proveedores de memoria de agentes comparados. Para un proveedor local autoalojado con controles de escritura inusualmente granulares, vea Mnemosyne para Hermes Agent: Inicio Rápido de Memoria Local — y Bucles de Memoria Auto-Rreforzantes en Agentes de IA para saber por qué una memoria acotada y curada como la propia MEMORY.md de Hermes evita varios modos de fallo de bucles de retroalimentación por construcción.
Para el cableado específico del perfil y flujos de trabajo de producción, vea configuración de producción de Hermes Agent. El centro de memoria de sistemas de IA enumera esta guía junto con artículos relacionados de Cognee y capa de conocimiento.
Parte 3: Cuando la Memoria Actúa — Disparadores y Decisiones
La pregunta más común sobre la memoria de Hermes Agent es cuándo guarda algo realmente.
La respuesta es: constantemente, pero selectivamente. El agente gestiona su propia memoria a través de la herramienta memory, y la decisión de guardar está impulsada por una combinación de señales explícitas y patrones implícitos.
Disparadores de Escritura: ¿Cuándo decide el agente guardar?
El agente guarda memoria proactivamente. No espera a que lo pidas. Aquí está lo que lo dispara.
Correcciones del usuario. Cuando corriges al agente, esa es una señal para recordar. “No hagas eso de nuevo.” “Usa esto en su lugar.” “Recuerda esto.” Estas son instrucciones explícitas para actualizar la memoria.
Ejemplo: le pides al agente que configure un entorno de Python. Sugerir pip. Dices “Yo uso poetry para todo”. El agente guarda: El usuario prefiere usar el gestor de paquetes 'poetry' para todos los proyectos de Python.
Preferencias descubiertas. El agente observa patrones e infiere preferencias. Si consistentemente usas una cierta herramienta, marco de trabajo o flujo de trabajo, se guarda.
Ejemplo: después de verte usar poetry varias veces en diferentes proyectos, el agente lo guarda como preferencia.
Hechos del entorno. Cosas sobre la máquina, el proyecto, las herramientas instaladas. Estos se descubren mediante la exploración y se guardan como hechos.
Ejemplo: el agente verifica qué está instalado y guarda: Esta máquina ejecuta Ubuntu 22.04, tiene Docker y kubectl instalados.
Convenciones del proyecto. Cómo está estructurado el proyecto, qué herramientas usa, qué patrones sigue. Estos se descubren mediante la inspección de código y se guardan.
Ejemplo: El proyecto del usuario es un micrservicio Go en ~/code/gateway usando gRPC + PostgreSQL.
Flujos de trabajo complejos completados. Después de completar una tarea que tomó 5+ llamadas de herramientas, el agente considera guardar el enfoque como una habilidad o al menos anotar lo que funcionó.
Excentricidades y solapaciones de herramientas. Cuando el agente descubre algo no obvio sobre una herramienta, API o sistema — una limitación, una solución, una convención — lo guarda.
Lo que se omite:
- Información trivial o obvia
- Cosas fácilmente re-descubiertas
- Volcados de datos crudos
- Efímeros específicos de la sesión
- Información ya en archivos de contexto (SOUL.md, AGENTS.md)
Disparadores de Lectura: ¿Cuándo recupera el agente?
La memoria no se recupera: siempre está ahí. Pero hay diferentes niveles de acceso.
Inicio de sesión (automático). MEMORY.md y USER.md se inyectan en el prompt de sistema. El agente las tiene desde el primer token. No se necesita consulta, no hay latencia, no hay llamada de herramienta. Esta es la memoria principal: siempre activa.
session_search (bajo demanda). Cuando el agente necesita encontrar algo de conversaciones pasadas que no está en la memoria principal, usa la herramienta session_search. Esto consulta SQLite (~/.hermes/state.db) con búsqueda de texto completo FTS5 y resumen con Gemini Flash. Use esto cuando la pregunta suene a “¿hablamos de esto antes?” en lugar de “recuerda este hecho para siempre”.
Ejemplo: preguntas “¿Discutimos la red de Docker la semana pasada?”. El agente busca el historial de la sesión y devuelve un resumen de la conversación relevante.
Herramientas de proveedor externo (cuando está configurado). Cuando un proveedor de memoria externo está activo, el marco de trabajo también ejecuta un paso de prefetch automático antes de cada respuesta (vea la Parte 2). Herramientas adicionales como honcho_search, hindsight_recall o mem0_search son para búsquedas dirigidas cuando el agente elige recuperación explícita — dependiendo de recall_mode, la inyección automática, las herramientas, o ambas pueden estar activas.
El Árbol de Decisiones
Aquí está cómo el agente pondera “¿vale la pena recordar esto?”:
¿Es esto una corrección o instrucción explícita?
  SÍ → Guardar en memoria
  NO → ¿Es esto una preferencia o patrón?
    SÍ → Guardar en perfil del usuario
    NO → ¿Es esto un hecho del entorno o convención?
      SÍ → Guardar en memoria
      NO → ¿Es esto fácilmente re-descubrible?
        SÍ → Omitir
        NO → ¿Es esto específico de la sesión?
          SÍ → Omitir
          NO → Guardar en memoria
El agente no lo piensa demasiado. Guarda proactivamente, consolida cuando está lleno y confía en los límites de caracteres para mantener las cosas ajustadas.
Parte 4: Memoria Interna frente a Bases de Conocimiento Externas
Aquí es donde a menudo ocurre la confusión. Hermes Agent tiene memoria interna (MEMORY.md, USER.md, proveedores externos) y bases de conocimiento externas (LLM Wiki, Obsidian, Notion, ArXiv, sistema de archivos), y cumplen roles completamente diferentes. Esto es similar a la distinción entre pipelines de generación aumentada por recuperación y la memoria de trabajo del agente: la recuperación externa es buena para búsquedas de conocimiento profundo, no para llevar identidad y preferencias. La memoria interna es el cerebro del agente: siempre activa, curada, llevada a cada sesión. Las bases de conocimiento externas son su biblioteca: vastos recursos de referencia consultados bajo demanda.
La Distinción
Memoria Interna (el cerebro):
- Pequeña, persistente, inyectada en el prompt de sistema
- Contiene: preferencias del usuario, convenciones del agente, lecciones inmediatas
- Siempre “en la mente” durante la conversación
- Curada, acotada, gestionada activamente
- Ejemplos: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Bases de Conocimiento Externas (la biblioteca):
- Vastas, solo referencia, accesadas bajo demanda
- Contienen: documentos, papeles, código, notas, bases de datos
- Accedidas mediante herramientas cuando es necesario
- No “recordadas”: buscadas
- Ejemplos: LLM Wiki, Obsidian, Notion, ArXiv, sistema de archivos, GitHub
Cómo se Relacionan
El agente accede a las bases externas mediante herramientas cuando lo necesita. No las “recuerda”: las busca.
LLM Wiki (llm-wiki): La base de conocimiento enlazada en Markdown de Karpathy para construir y consultar conocimiento de dominio. El agente usa la habilidad llm-wiki para leer, buscar y consultar. Es un recurso de referencia, no memoria.
Obsidian: Bóvedas de notas personales con enlaces bidireccionales. El agente usa la habilidad obsidian para leer, buscar y crear notas. Obsidian es parte del ecosistema más amplio de gestión personal del conocimiento en el que Hermes puede apoyarse como recurso de biblioteca.
Notion/Airtable: Bases de datos estructuradas y wikis accedidas mediante API. El agente las consulta cuando lo necesita.
ArXiv: Repositorios de papeles académicos. El agente busca y extrae papeles cuando investiga un tema.
Sistema de Archivos: Código del proyecto, documentación, configuraciones. El agente lee archivos cuando trabaja en un proyecto.
El Patrón de Destilación
Aquí está el insight clave: los insights críticos de las bases externas pueden destilarse en la memoria interna.
Ejemplo: el agente lee un papel de ArXiv sobre el escalado de memoria para agentes de IA. No guarda todo el papel en la memoria. Guarda el punto clave: Escalado de memoria: el rendimiento del agente mejora con la experiencia acumulada a través de la interacción del usuario y el contexto de negocio almacenado en memoria.
El recurso externo es vasto. La memoria interna es la destilación.
Cuándo Usar Cuál
Memoria interna para:
- “¿A quién estoy ayudando?”
- “¿Qué les gusta?”
- “¿Qué acabamos de aprender?”
- “¿Cuál es la configuración del proyecto?”
- “¿Qué herramientas están disponibles?”
Bases de conocimiento externas para:
- “¿Cuál es la investigación más reciente sobre X?”
- “¿Qué está en la documentación de mi proyecto?”
- “¿De qué hablamos el mes pasado?”
- “¿Cuál es la API de este servicio?”
- “¿Cuál es la estructura del código?”
El agente entiende la diferencia y usa cada uno apropiadamente: no confunde buscar un documento con recordar algo que ha aprendido sobre ti y tu entorno.
Parte 5: Cómo Funciona Realmente
Echemos un vistazo a las mecánicas.
La herramienta memory
El agente gestiona la memoria a través de una sola herramienta con tres acciones: add, replace, remove.
No hay acción read: el contenido de la memoria se inyecta automáticamente en el prompt de sistema. El agente no necesita leerlo porque siempre está ahí.
add — Añade una nueva entrada.
memory(action="add", target="memory",
       content="El usuario ejecuta macOS 14 Sonoma, usa Homebrew, tiene Docker Desktop instalado.")
replace — Reemplaza una entrada existente usando coincidencia de subcadenas.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="El usuario prefiere light mode en VS Code, dark mode en terminal")
remove — Elimina una entrada usando coincidencia de subcadenas.
memory(action="remove", target="memory",
       old_text="hecho temporal del proyecto")
Coincidencia de Subcadenas
replace y remove usan subcadenas únicas cortas vía old_text. No necesitas el texto completo de la entrada. Esto hace posibles ediciones quirúrgicas sin conocer el contenido exacto.
Si una subcadena coincide con múltiples entradas, se devuelve un error solicitando una coincidencia más específica. El agente luego refina su consulta.
Almacenes Destino: memory frente a user
El parámetro target determina qué archivo se actualiza.
memory— Notas personales del agente. Hechos del entorno, convenciones del proyecto, excentricidades de herramientas, lecciones aprendidas.user— Perfil del usuario. Identidad, rol, zona horaria, preferencias de comunicación, disgustos, hábitos de flujo de trabajo.
Gestión de Capacidad
Cuando la memoria está >80% llena, el agente consolida. Fusiona entradas relacionadas, elimina hechos obsoletos y comprime información.
Las buenas entradas de memoria son compactas y densas en información:
El usuario ejecuta macOS 14 Sonoma, usa Homebrew, tiene Docker Desktop instalado. Shell: zsh con oh-my-zsh. Editor: Neovim con plugin Telescope.
Las malas entradas de memoria son vagas o verbosas:
El usuario tiene un proyecto.
El 5 de enero de 2026, el usuario me pidió que mirara su proyecto que está en ~/code/gateway y usa Go con gRPC y PostgreSQL para la capa de base de datos.
La primera es densa y útil. La segunda es o demasiado vaga o demasiado verbosa.
Búsqueda de Sesión frente a Memoria Persistente
session_search y la memoria persistente sirven propósitos diferentes.
| Característica | Memoria Persistente | Búsqueda de Sesión |
|---|---|---|
| Capacidad | ~1,300 tokens en total | Ilimitada (todas las sesiones) |
| Velocidad | Instantánea (en el prompt de sistema) | Requiere búsqueda + resumen LLM |
| Caso de Uso | Hechos clave siempre disponibles | Encontrar conversaciones específicas pasadas |
| Gestión | Curada manualmente por el agente | Automática: se almacenan todas las sesiones |
| Costo de Tokens | Fijo por sesión (~1,300 tokens) | Bajo demanda (se busca cuando es necesario) |
Regla general: use memoria para hechos críticos que siempre deberían estar en contexto. Use búsqueda de sesión para búsquedas históricas.
Parte 6: La Filosofía
Por qué la Memoria Acotada Supera a la Ilimitada
El instinto es hacer la memoria tan grande como sea posible. Almacena todo. Recupera lo que necesitas.
La memoria acotada funciona mejor. Aquí es por qué.
La curación fuerza la calidad. Cuando tienes espacio limitado, solo guardas lo que importa. Compras, consolidas y priorizas. La memoria ilimitada anima a volcar todo y nunca limpiar.
La velocidad importa. 1,300 tokens en el prompt de sistema es rápido. 100,000 tokens recuperados de una base de datos es lento. La memoria debe ser instantánea, no una consulta.
El ruido degrada el rendimiento. Más memoria no es mejor memoria. Es memoria más ruidosa. El modelo tiene que distinguir la señal del ruido, y eso toma atención: atención que debería gastarse en la tarea real.
Olvidar es una característica. La memoria humana olvida. Eso no es un error: es cómo priorizamos. Los agentes deberían olvidar también. No todo merece ser recordado.
El Problema del “Olvido”
Los agentes necesitan desaprender. No solo olvidar, sino activamente eliminar información obsoleta.
Aquí es cómo Hermes Agent lo maneja:
- Acción
remove: Elimina entradas que ya no son relevantes. - Acción
replace: Actualiza entradas con nueva información. - Presión de capacidad: Cuando la memoria está llena, el agente consolida y elimina entradas viejas.
- Escaneo de seguridad: Bloquea entradas maliciosas o corruptas.
Olvidar no es un fallo: es mantenimiento. Un agente que no puede desaprender eventualmente cargará tanto ruido como señal.
Escalado de Memoria
Databricks introdujo el concepto de “escalado de memoria”: ¿un agente con miles de usuarios rinde mejor que uno con un solo usuario?
Su investigación sugiere que sí, pero con cautelas. El escalado de memoria requiere:
- Extracción de calidad: No todas las interacciones valen la pena recordar. El agente debe extraer insights, no registros.
- Recuperación efectiva: Las memorias recuperadas deben ser relevantes. El ruido degrada el rendimiento.
- Generalización: Las memorias deberían ser patrones, no especificidades. “El usuario prefiere Python” escala. “El usuario ejecutó el comando X en la marca de tiempo Y” no.
La memoria acotada de Hermes Agent soporta naturalmente el escalado de memoria. Al forzar la curación, asegura que las memorias sean generalizables, compactas y útiles.
Qué Significa Esto para el Futuro
La memoria se está convirtiendo en la fosa competitiva en la IA agéntica: no el modelo mismo, sino lo que el modelo lleva entre sesiones. Dos agentes con modelos subyacentes idénticos pueden tener un rendimiento muy diferente: uno recuerda tus preferencias, tu entorno y tus errores pasados; el otro comienza en frío cada vez.
La pregunta ya no es si los agentes deberían tener memoria persistente. Está resuelto: deben. La pregunta abierta es cómo diseñar esa memoria bien: qué mantener, qué descartar, cómo hacerla instantánea y cómo prevenir que se convierta en ruido.
La respuesta de Hermes Agent es mantener la memoria pequeña, curada y siempre activa: no una base de datos a la que consultar, sino un modelo de trabajo del usuario que el agente lleva consigo a cada conversación.
Conclusión
El sistema de memoria de Hermes Agent es deliberadamente simple: dos archivos, límites de caracteres firmes, sin pipeline de recuperación, sin base de datos vectorial, y sin latencia por consulta. Lo que suena como una restricción es todo el punto.
Funciona porque trata la memoria de la manera que un cerebro funciona, no de la manera que lo hace una base de datos: pequeña, curada y siempre activa. El agente no recupera la memoria cuando la necesita; la memoria simplemente siempre está ahí, tejida en el prompt de sistema desde el primer token de cada sesión.
Los proveedores de memoria externos extienden este sistema para usuarios que necesitan más: grafos de conocimiento, soporte multi-agente, almacenamiento autoalojado, características empresariales. Pero el núcleo permanece igual: acotado, curado, siempre disponible.
Y las bases de conocimiento externas — LLM Wiki, Obsidian, Notion, ArXiv — sirven un rol diferente. Son la biblioteca, no el cerebro. El agente las busca, no las recuerda. Los insights críticos se destilan en la memoria interna; el resto permanece en la biblioteca.
Así es como un agente de IA te recuerda. No almacenando todo, sino recordando lo que importa.
Hermes Agent fue lanzado por Nous Research en febrero de 2026 y alcanzó más de 64,000 estrellas en GitHub en abril de 2026 (v0.9.0), con más de 242 contribuidores. Es de código abierto y está disponible en github.com/NousResearch/hermes-agent. Para guías de instalación, configuración y flujo de trabajo, vea la visión general de Hermes Agent.
