Gravedad de los datos: el verdadero costo de la IA con enfoque en la API

Gravedad de los datos: el verdadero costo de la IA con enfoque en la API

«Por qué tu pila de IA se vuelve más pegajosa cada mes.»

Cada llamada a una API se siente como una transacción simple… hasta que se acumulan tantas que tus datos de afinamiento, tus arneses de evaluación y tus esquemas de herramientas quedan moldeados en torno a un solo proveedor, y cambiar deja de ser un simple cambio de ruteo.
Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Delega el trabajo ruidoso y mantén tu contexto limpio.

La mayoría de las sesiones de Claude Code se vuelven lentas y desordenadas por la misma razón: cada búsqueda exploratoria con grep, cada volcado de registros y cada “déjame revisar un archivo más” permanece en la conversación principal para siempre.

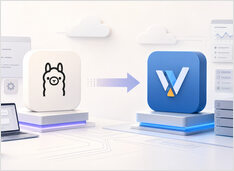
De Ollama a vLLM: cuándo migrar tu servidor local de LLM

De Ollama a vLLM: cuándo migrar tu servidor local de LLM

Cuándo migrar de Ollama a vLLM

Ollama es una de las formas más sencillas de ejecutar un modelo de lenguaje local, pero la comodidad puede ocultar el momento en que un experimento local se convierte en un servicio de inferencia compartido que necesita una mejor planificación y observabilidad.

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Evita que los agentes de IA se desvíen de las especificaciones, las pruebas y el código.

Los agentes de codificación con IA implementan características rápidamente, pero las especificaciones, las pruebas y el código se desvían silenciosamente entre sí. Esta guía cubre un modelo de trazabilidad, el mapeo de especificación a prueba y de especificación a código, y las verificaciones de integración continua (CI) que detectan la desviación antes de una fusión.

Patrón Circuit Breaker en Go: Detener las Fallos en Cascada

Patrón Circuit Breaker en Go: Detener las Fallos en Cascada

Evita las falencias en cascada en microservicios de Go.

Un breaker de circuitos (o disyuntor eléctrico) impide que tu servicio Go siga presionando una dependencia fallida, previniendo fallos en cascada que consumen gorutinas, sockets y memoria hasta que todo el sistema colapse.

Podman Quadlet frente a Docker Compose para servicios en Linux

Podman Quadlet frente a Docker Compose para servicios en Linux

Elija el flujo de trabajo de contenedores adecuado.

Docker Compose y Podman Quadlet resuelven problemas superpuestos, pero provienen de diferentes filosofías de diseño. Elegir entre ellos depende de si piensas en términos de pilas de aplicaciones o de servicios de Linux.

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

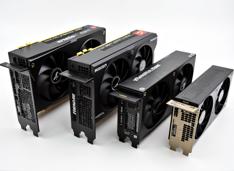
El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.

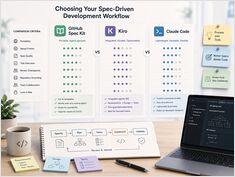
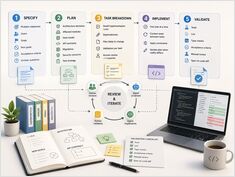
GitHub Spec Kit frente a Kiro frente a los flujos de trabajo SDD de Claude Code

GitHub Spec Kit frente a Kiro frente a los flujos de trabajo SDD de Claude Code

Profundidad del proceso versus portabilidad, no la mejor herramienta.

Los desarrolladores que comparan configuraciones de Desarrollo Orientado por Especificaciones (Spec-Driven Development, SDD) en 2026 generalmente no están preguntando qué modelo es más inteligente. Están preguntando qué flujo de trabajo mantendrá a un agente de IA alineado sin sepultarlos en ceremonias.

Suscribirse

Recibe nuevas publicaciones sobre sistemas, infraestructura e ingeniería de IA.