De Ollama a vLLM: cuándo migrar tu servidor local de LLM

De Ollama a vLLM: cuándo migrar tu servidor local de LLM

Cuándo migrar de Ollama a vLLM

Ollama es una de las formas más sencillas de ejecutar un modelo de lenguaje local, pero la comodidad puede ocultar el momento en que un experimento local se convierte en un servicio de inferencia compartido que necesita una mejor planificación y observabilidad.
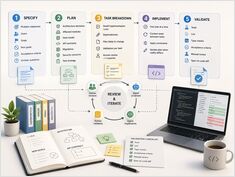
Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Evita que los agentes de IA se desvíen de las especificaciones, las pruebas y el código.

Los agentes de codificación con IA implementan características rápidamente, pero las especificaciones, las pruebas y el código se desvían silenciosamente entre sí. Esta guía cubre un modelo de trazabilidad, el mapeo de especificación a prueba y de especificación a código, y las verificaciones de integración continua (CI) que detectan la desviación antes de una fusión.

Patrón Circuit Breaker en Go: Detener las Fallos en Cascada

Patrón Circuit Breaker en Go: Detener las Fallos en Cascada

Evita las falencias en cascada en microservicios de Go.

Un breaker de circuitos (o disyuntor eléctrico) impide que tu servicio Go siga presionando una dependencia fallida, previniendo fallos en cascada que consumen gorutinas, sockets y memoria hasta que todo el sistema colapse.

Podman Quadlet frente a Docker Compose para servicios en Linux

Podman Quadlet frente a Docker Compose para servicios en Linux

Elija el flujo de trabajo de contenedores adecuado.

Docker Compose y Podman Quadlet resuelven problemas superpuestos, pero provienen de diferentes filosofías de diseño. Elegir entre ellos depende de si piensas en términos de pilas de aplicaciones o de servicios de Linux.

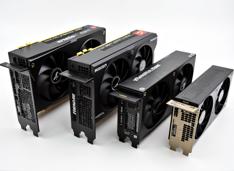
GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.

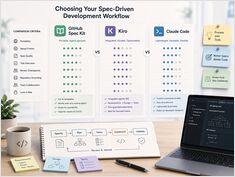
GitHub Spec Kit frente a Kiro frente a los flujos de trabajo SDD de Claude Code

GitHub Spec Kit frente a Kiro frente a los flujos de trabajo SDD de Claude Code

La profundidad del proceso frente a la portabilidad, no la mejor herramienta.

Los desarrolladores que comparan configuraciones de Desarrollo Guiado por Especificaciones (SDD) en 2026 generalmente no se preguntan cuál es el modelo más inteligente. Se preguntan qué flujo de trabajo mantendrá alineado a un agente de IA sin ahogarlos en burocracia.

Instalar Docker en Ubuntu: APT, Snap, Rootless — Guía completa 2026

Instalar Docker en Ubuntu: APT, Snap, Rootless — Guía completa 2026

Seleccione la ruta de instalación de Docker adecuada en Ubuntu.

La instalación de Docker en Ubuntu debería ser sencilla, pero en la práctica, varias opciones con forma de Docker compiten por el mismo nombre de comando, cada una con diferente empaquetado, comportamiento de actualización e implicaciones de seguridad.

Suscribirse

Recibe nuevas publicaciones sobre sistemas, infraestructura e ingeniería de IA.