
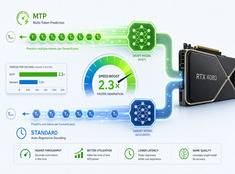
16GB GPU에서 Qwen 3.6 27B 및 35B MTP와 표준 모델 비교
RTX 4080에서의 MTP 대 표준 디코딩 — 실제 벤치마크
RTX 4080(16 GB VRAM) 환경에서 Qwen 3.6 27B 및 35B 모델의 추측 해독(Speculative decoding, 다중 토큰 예측(MTP)) 성능을 테스트했습니다.
RTX 4080에서의 MTP 대 표준 디코딩 — 실제 벤치마크
RTX 4080(16 GB VRAM) 환경에서 Qwen 3.6 27B 및 35B 모델의 추측 해독(Speculative decoding, 다중 토큰 예측(MTP)) 성능을 테스트했습니다.
llama-server를 종료하지 않고도 VRAM을 확보하는 방법
llama.cpp 라우터 모드는 수년 동안 llama-server에 도입된 변화 중 가장 유용한 변화 중 하나입니다. 이는 로컬 LLM 운영자에게 Ollama에서 기대하는 모델 관리 경험에 가까운 기능을 제공하면서도, llama.cpp를 처음부터 사용하게 만드는 원시 성능과 저레벨 제어를 그대로 유지합니다.
에이전틱 LLM 튜닝 참고 자료
이 페이지는 에이전트형 LLM 추론 튜닝에 대한 실용적인 참고 자료입니다(temperature, top_p, top_k, penalties 및 다단계 및 도구 중심 워크플로우에서의 상호 작용 방식).
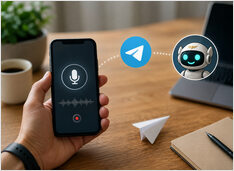
전화기에서 헤르메스와 대화하세요
이미 스마트폰으로 텍스트를 통해 헤르메스 에이전트(Hermes Agent)와 대화를 나누고 계실텐데요. 이제 직접 말로 소통하고 음성으로 답변을 받아보시는 게 좋습니다. 특히 헤르메스를 영구적인 자체 호스팅 어시스턴트로 사용하고 계신다면 이는 가장 올바른 선택입니다. 작은 화면에서 긴 프롬프트를 입력하는 것은 느리고 실수가 발생하기 쉽기 때문입니다.
자체 호스팅 LLM에서 Hermes 카んばん 부하를 제어하세요.
Hermes Agent는 칸반 스타일의 보드와 Hermes Gateway를 함께 제공하며, 너무 많은 작업이 한 번에 배포되면 자체 호스팅 LLM을 포화 상태로 만들 수 있습니다.
저자 헤르메스 - 빠르게 로드되고 신뢰성 있게 작동하는 스킬
Hermes Agent는 반복 가능한 워크플로우를 가르치는 기본 방법으로 스킬을 취급합니다. 공식 문서는 스킬을 agentskills.io의 오픈 형식과 일치하는 온디맨드 지식 문서로 설명하며, 모델이 먼저 작은 인덱스를 보고 작업이 실제로 필요할 때만 전체 지침을 가져오도록 점진적 공개를 통해 로드됩니다.
셀프 호스팅된 Hermes 에이전트를 위한 셸 및 TUI 명령어
Nous Research의 Hermes Agent는 모델에 구애받지 않고, 도구를 활용하는 로컬 또는 VPS에서 실행할 수 있는 어시스턴트입니다.
MinIO CE는 2026년에 사실상 서비스 종료(EOL) 상태가 됩니다.
MinIO 커뮤니티 에디션(CE)은 더 이상 새로운 프로덕션 시스템의 안전한 기본값으로 간주되지 않습니다.
단일 채팅 스레드를 넘어 지속되는 지식
이 섹션은 AI 시스템의 영속적 지식과 기억에 대한 가이드를 모아놓은 곳입니다 — 어시스턴트가 모든 토큰을 하나의 프롬프트에 집어넣지 않고도 세션 간에 사실, 선호 사항, 정제된 맥락을 유지하는 방법을 다룹니다. 여기에서 기억은 GPU RAM이나 모델 가중치가 아니라, 의도적인 보존(사용자 사실, 요약, 플러그인 기반 스토어)을 의미합니다.
캐처 정책이 리콜과 같은 중요성을 가지게 되었다.
2026년 9월 업데이트: Mnemosyne 및 Memori 추가, Honcho와 Hindsight 설정 확장, 기존 인프라 표와 함께 캡처 정책 비교표 추가.
메모리는 도구가 아닌 파트너를 만드는 차이점입니다.
AI 에이전트와 채팅을 시작하고, 프로젝트를 설명하고, 선호 사항을 공유하고, 작업을 마친 후 탭을 닫는 장면을 익히 보셨을 것입니다. 일주일 후 다시 돌아오면 마치 처음 만난 사람과 대화하듯 모든 컨텍스트가 사라지고, 모든 선호 사항이 잊혀 있으며, 프로젝트가 처음부터 다시 설명되어야 하는 상황이 됩니다.
OpenClaw는 빠르게 부상했다가 더 빠르게 사라졌다.
OpenClaw는 제품으로서 실패한 것이 아닙니다. 연료를 잃어버린 것입니다.
재시작 없이 LLM을 서빙하고 교체합니다.
llama.cpp는 오랫동안 치명적인 한계점을 가지고 있었습니다. 바로 프로세스당 하나의 모델만 서빙할 수 있었고, 모델 전환을 하려면 프로세스를 재시작해야 했기 때문입니다.
PKM 도구, 방법론 및 셀프 호스트 위키 비교
개인 지식 관리(PKM)는 Obsidian, Logseq, DokuWiki, Zettelkasten, PARA 등을 아우르는 광범위한 영역입니다. 올바른 선택은 로컬 기반의 노트 그래프, 자체 호스팅 위키, 또는 아웃라이너 기반의 워크플로우 중 무엇을 원하는지에 따라 달라집니다.
심각한 워크로드를 위한 프로파일 우선 Hermes 설정
공식적으로 Hermes Agent로 문서화된 Hermes AI 어시스턴트는 단순한 채팅 래퍼(wrapper)로 포지셔닝되지 않습니다.
가져둘 가치 있는 스킬과 건너뛸 스킬
OpenClaw에는 두 가지 확장이 있으며, 이들은 쉽게 혼동될 수 있습니다.
플러그인은 런타임을 확장합니다. 스킬(기술)은 에이전트의 행동을 확장합니다.