
LLM ASIC 및 전용 추론 칩(왜 중요한가)
ASIC과 맞춤형 실리콘은 LLM 추론 속도와 효율성을 높입니다
ASIC과 맞춤형 실리콘은 LLM 추론 속도와 효율성을 높입니다
가용성, 6개국의 실제 소매 가격, 그리고 Mac Studio와의 비교
**NVIDIA DGX Spark**는 실제로 존재하며, 2025년 10월 15일부터 판매가 시작되어 통합 NVIDIA AI 스택과 함께 로컬 LLM 작업이 필요한 CUDA 개발자를 대상으로 하고 있습니다. 미국 소비자 권장 정가(MSRP)는 3,999달러이며, 영국/독일/일본의 소매 가격은 부가가치세(VAT)와 유통 채널에 따라 더 높은 편입니다. 호주/한국의 공개 스티커 가격은 아직 널리 게시되지 않았습니다.
두 모델의 속도, 파라미터 및 성능 비교
다음은 Qwen3:30b와 GPT-OSS:20b 비교 내용입니다. 지시 따름 능력(instruction following)과 성능 파라미터, 사양 및 속도에 초점을 맞추었습니다.
+ 사고형 LLM을 사용한 구체적인 예시
이 포스트에서는 Python 애플리케이션을 Ollama에 연결하는 방법에 대해 두 가지 방법을 소개합니다: 1. HTTP REST API를 통해; 2. 공식 Ollama Python 라이브러리를 통해.
매우 좋지 않다.
Ollama의 GPT-OSS 모델은 특히 LangChain, OpenAI SDK, vllm과 같은 프레임워크와 함께 사용될 때 구조화된 출력을 처리하는 데 반복적으로 문제가 발생합니다.
조금 다른 API에는 특별한 접근 방식이 필요합니다.
다음은 인기 있는 LLM 제공업체들 간 구조화된 출력 (신뢰할 수 있는 JSON을 반환받는 것) 지원 상황의 나란한 비교표이며, 최소한의 Python 예제 코드도 함께 제공합니다.
Ollama에서 구조화된 출력을 받는 몇 가지 방법
대규모 언어 모델(LLM) 은 강력하지만, 프로덕션 환경에서는 자유형식(paragraph) 응답을 원하는 경우가 드뭅니다. 대신, 애플리케이션에 직접 입력할 수 있는 예측 가능한 데이터, 즉 속성, 사실 또는 구조화되어 객체를 원합니다. 이것이 바로 LLM 구조화 출력입니다.
내가 직접 수행한 ollama 모델 스케줄링 테스트
여기에서 저는 새로운 버전의 Ollama가 모델에 얼마나 많은 VRAM을 할당하는지와 이전 버전의 Ollama를 비교하고 있습니다. 새로운 버전은 오히려 더 나빠졌습니다.
Ollama 개발의 현재 상태에 대한 나의 견해
Ollama은 로컬에서 LLM을 실행하는 도구 중 하나인 가장 인기 있는 도구로 빠르게 부상했습니다. 그것의 단순한 CLI, 그리고 세련된 모델 관리 기능은 클라우드 밖에서 AI 모델로 작업하려는 개발자들에게 필수적인 옵션으로 만들었습니다.
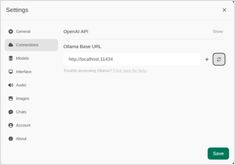
2025년 Ollama의 가장 주목받는 UI에 대한 간략한 개요
로컬에서 호스팅된 Ollama는 자신의 기계에서 대규모 언어 모델을 실행할 수 있게 해주지만, 명령줄을 통해 사용하는 것은 사용자 친화적이지 않습니다.
다음은 로컬 Ollama에 연결되는 **ChatGPT 스타일 인터페이스**를 제공하는 여러 오픈소스 프로젝트입니다.
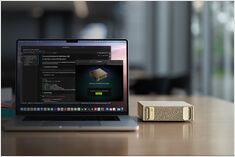
2025 년 7 월이면 곧 이용 가능할 것입니다.
Nvidia 가 곧 NVIDIA DGX Spark를 출시합니다. 128GB 이상의 통합 RAM 과 1 PFLOPS AI 성능을 갖춘 블랙웰 (Blackwell) 아키텍처 기반의 소형 AI 슈퍼컴퓨터입니다. LLM 을 실행하기에 훌륭한 기기입니다.
MCP 사양과 GO에서의 구현에 대한 장문의 글
여기에는 **Model Context Protocol (MCP)**에 대한 설명과 Go로 작성된 MCP 서버를 구현하는 방법에 대한 간단한 노트, 메시지 구조 및 프로토콜 명세가 포함되어 있습니다.
RAG 구현 중이신가요? 여기 Go 코드 조각이 있습니다 - 2...
표준 Ollama 에는 직접적인 rerank API 가 없으므로, 쿼리 - 문서 쌍에 대한 임베딩을 생성하고 점수를 매기는 방식으로 GO 에서 Qwen3 Reranker 를 사용한 재순위 지정 을 구현해야 합니다.
qwen3 8b, 14b 및 30b, devstral 24b, mistral small 24b
이 테스트에서는 Ollama에 호스팅된 다양한 LLM이 Hugo 페이지를 영어에서 독일어로 번역하는 방식을 비교하고 있습니다. 다른 LLM이 호스팅된 Ollama에서 Hugo 페이지를 영어에서 독일어로 번역하는 방식 비교.
RAG 구현 중이신가요? Golang 코드 스니펫을 소개합니다.
이 작은 Go 코드 예시는 쿼리와 각 후보 문서에 대해 임베딩을 생성하기 위해 Ollama 를 호출합니다 그리고 코사인 유사도 기준으로 내림차순으로 정렬합니다.
Ollama 에서 제공되는 새로운 놀라운 LLM 들
Qwen3 임베딩 및 리랭커 모델 은 Qwen 시리즈의 최신 릴리스로, 고급 텍스트 임베딩, 검색 및 재랭킹 작업을 위해 특별히 설계되었습니다.