
스펙 기반 개발이란? 단일 정보원으로서의 스펙
사이드 문서가 아닌, 단일 진실 공급원으로서의 스펙
스펙 기반 개발(Spec-Driven Development)은 소프트웨어 엔지니어들이 과거에 시도했다가 노력이 더 이상 보상을 주지 못할 때 제쳐두었던 아이디어 중 하나입니다.
사이드 문서가 아닌, 단일 진실 공급원으로서의 스펙
스펙 기반 개발(Spec-Driven Development)은 소프트웨어 엔지니어들이 과거에 시도했다가 노력이 더 이상 보상을 주지 못할 때 제쳐두었던 아이디어 중 하나입니다.
사실의 원천으로서의 스펙, 아니면 느린 의식인가?
스펙 기반 개발(Spec-Driven Development)은 2026년에 바이브 코딩의 방향성 상실(drift)에 대한 진지한 개발자의 해답으로 등장했습니다.
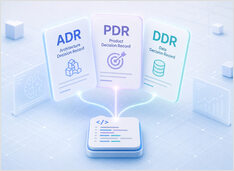
코드의 의도를 가깝게 유지하세요.
AI를 활용한 소프트웨어 개발에서 의사결정 기록은 누락된 기억 계층입니다. 기록의 대상은 무엇이가구축되었는가가 아니라, 왜 그렇게 결정되었는가에 초점을 맞춥니다. AI 도구가 코드를 작성하게 될 때 이 구분은 매우 중요해집니다.

오류를 적절한 경계에서 처리하세요.
Go의 에러 처리는 불평하기 쉽습니다. 모든 Go 개발자는 수백 번 이 코드를 작성해 보셨을 것입니다:

동시 Go 테스트에서 잠들지 마세요.
Go의 동시성 코드를 테스트하는 일은 항상 약간의 규율을 필요로 했습니다. 고루틴(Goroutine)은 가볍고, 채널(Channel)은 단순하며, 컨텍스트(Context) 취소는 관례적인(idiomatic) 방식입니다. 실제 Go 서비스에서는 백그라운드 워커와 타이머가 어디에나 존재합니다.

A2A는 사라진 것이 아닙니다. 다만 범용적으로 쓰이지 않을 뿐입니다.
구글의 에이전트 투 에이전트(Agent2Agent) 프로토콜, 즉 A2A는 첫해를 다소 혼란스럽게 보냈습니다.
AI 에이전트를 위한 신뢰할 수 있는 폴링 패턴
폴링 에이전트(Polling Agent)는 AI 어시스턴트 아키텍처에서 가장 화려하지는 않지만, 동시에 가장 유용한 구성 요소 중 하나입니다.
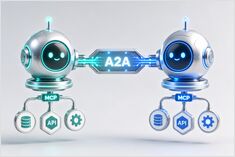
MCP는 에이전트에 도구를 제공하며, A2A는 에이전트에게 동료(피어)를 제공합니다.
AI 에이전트 아키텍처는 이제 두 가지 레이어로 분화되기 시작하고 있습니다.
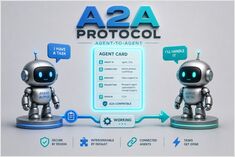
A2A는 에이전트를 네트워크 피어(network peers)로 전환합니다.
A2A 프로토콜(에이전트 투 에이전트 프로토콜)은 독립적인 AI 에이전트 시스템 간의 통신을 위한 개방형 표준입니다.

불필요한 형식주의 없이 Go로 CQRS 구축하기
CQRS는 과대평가되고, 지나치게 복잡해지며, 때로는 평범한 CRUD의 지루함을 해결할 만병통치약으로 오해받는 패턴 중 하나입니다.
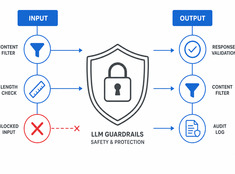
모델이 아닌 리스크를 통제하십시오.
대형 언어 모델(LLM)은 예측 불가능합니다. 환각(hallucination) 현상이 발생하거나, 데이터가 유출되거나, 유해한 콘텐츠를 생성하거나, 합법적인 요청을 거부하기도 합니다. 가드레일(Guardrails)은 모델의 성능을 희생하지 않으면서도 모델의 행동을 제한합니다.
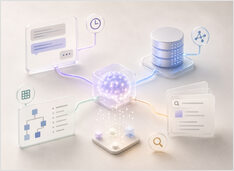
어시스턴트를 위한 작업 기억, 구조화 기억, 검색 기억
메모리는 어시스턴트를 반응형에서 지속형으로 바꾸지만, 동시에 많은 시스템이 조용히 부패하는 곳이기도 합니다. 최신 에이전트 메모리에 대해 단기 기억과 장기 기억의 이분법은 더 이상 충분하지 않다고 주장하는 조사가 있으며, OpenAI와 LangGraph SDK는 더 단순한 스택을 지시합니다 — 워킹 메모리(작업 메모리), 내구성 상태(durable state), 검색(retrieval).
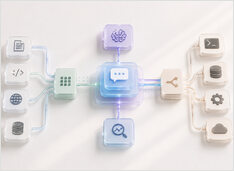
실제 심각한 수준의 어시스턴트는 어떻게 구축되는가
생산 환경용 AI 어시스턴트는 단순히 “프롬프트가 붙은 LLM"이 아닙니다. 이는 의도(Intent)를 받아들이고, 상태를 유지하며, 언제 검색하거나 행동할지 결정하고, 실패를 디버깅할 수 있는 충분한 런타임 세부 정보를 제공하는 시스템입니다.
검색은 지식 구조가 아닙니다
대부분의 현대 지식 시스템은 검색(Retrieval) 최적화에 집중하며, 이는 이해할 수 있는 접근입니다. 검색은 가시적이며 데모하기 쉽고, 작동할 때 마법처럼 느껴집니다. 질문을 입력하면 답변이 돌아옵니다.
AI 시스템을 위한 컴파일된 지식
전제는 간단합니다. 컴파일된 지식은 검색된 단편보다 재사용성이 높습니다. RAG는 직관적인 질문—LLM에게 외부 지식을 어떻게 접근하게 할 것인가?—에 대한 기본 답변이 되었습니다.
현대 지식 시스템의 지도
PKM, RAG, 위키, AI 메모리 시스템, 그리고 최근 실용적인 AI 지원 워크플로우가 종종 동일한 문제를 해결하는 것처럼 논의됩니다. 하지만 그렇지 않습니다. 이들은 모두 지식과 관련되어 있지만, 서로 다른 계층에서 작동합니다: