
오픈코드(OpeCode) 퀵스타트: 설치, 설정 및 실행 가이드
Oh My Opencode 를 설치하고 더 빠르게 배포하세요.
Oh My Opencode 는 OpenCode 를 **멀리 에이전트 코딩 하네스 (multi-agent coding harness)**로 변신시킵니다. 오케스트레이터가 작업을 병렬로 실행하는 전문 에이전트에게 위임합니다.
Oh My Opencode 를 설치하고 더 빠르게 배포하세요.
Oh My Opencode 는 OpenCode 를 **멀리 에이전트 코딩 하네스 (multi-agent coding harness)**로 변신시킵니다. 오케스트레이터가 작업을 병렬로 실행하는 전문 에이전트에게 위임합니다.
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
시시포스와 그 전문 에이전트 팀을 소개합니다.
OpenCode 의 가장 큰 능력 향상은 전담 에이전트 (specialised agents) 에서 비롯됩니다: 오케스트레이션, 계획, 실행, 연구의 의도적인 분리입니다.
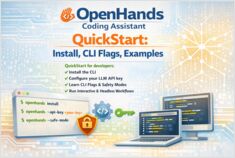
OpenHands CLI, 몇 분 만에 빠르게 시작하세요
OpenHands 는 AI 기반 소프트웨어 개발 에이전트를 위한 오픈소스, 모델 불특정 플랫폼입니다. 이 플랫폼은 에이전트가 단순한 자동 완성 도구가 아닌, 실제 코딩 파트너처럼 행동할 수 있도록 합니다.
분산형 로컬 AI 를 통해 OpenAI 호환 API 를 LocalAI 로 몇 분 안에 자체 호스팅하세요.
LocalAI 는 자신의 하드웨어 (노트북, 워크스테이션, 온프레미스 서버) 에서 AI 워크로드를 실행하기 위해 설계된 자체 호스팅, 로컬 우선 추론 서버로, OpenAI API 와의 호환성을 제공하여 기존 도구를 그대로 사용할 수 있도록 합니다.
OpenCode 설치, 설정 및 사용 방법
지역 추론(local inference)을 위해 llama.cpp에 계속 돌아오고 있습니다. Ollama 등 다른 도구들이 추상화해 버리는 부분까지 직접 제어할 수 있고, 실제로도 잘 작동하기 때문입니다. llama-cli로 GGUF 모델을 인터랙티브하게 실행하거나, llama-server로 OpenAI 호환 HTTP API를 노출하는 것이 매우 쉽습니다.
OpenCode 설치, 설정 및 사용법
OpenCode는 터미널(TUI + CLI)에서 실행할 수 있는 오픈소스 AI 코딩 에이전트로, 데스크톱 및 IDE 환경도 선택적으로 지원합니다. 이 글은 OpenCode 퀵스타트: 설치, 검증, 모델/프로바이더 연결, 실제 워크플로우(CLI + API) 실행에 대한 안내입니다.
에어테이블 - 무료 계획 제한, API, 웹후크, Go 및 Python.
Airtable는 주로 협업하는 “데이터베이스처럼” 된 스프레드시트 UI를 기반으로 한 저코드 애플리케이션 플랫폼으로 생각하는 것이 가장 좋습니다. 비개발자들이 친근한 인터페이스를 필요로 하지만, 개발자들도 자동화와 통합을 위한 API 표면이 필요할 때 매우 빠르게 운영 도구를 생성하는 데 적합합니다(내부 트래커, 가벼운 CRM, 콘텐츠 파이프라인, AI 평가 대기열 등).
프로미스스(Prometheus) 와 그라파나(Grafana) 를 활용한 LLM 모니터링
LLM 추론은 “단순한 또 하나의 API"처럼 보이지만, 지연 시간이 급증하고 대기열이 쌓이며 GPU 메모리가 95% 사용되는데도 명확한 원인을 파악할 수 없게 되면 상황이 달라집니다.
OpenClaw AI 어시스턴트 가이드
대부분의 로컬 AI 환경은 동일한 방식으로 시작합니다. 모델, 런타임, 그리고 채팅 인터페이스가 그것입니다.
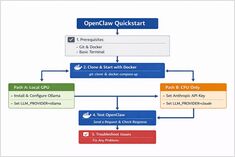
로컬에 Ollama를 사용하여 OpenClaw 설치
OpenClaw는 Ollama와 같은 로컬 LLM 런타임이나 Claude Sonnet과 같은 클라우드 기반 모델과 함께 실행하도록 설계된 셀프 호스팅(Self-hosted) AI 어시스턴트입니다.
AWS S3, Garage 또는 MinIO - 개요 및 비교.
AWS S3는 객체 저장소의 “기본” 기준으로 남아 있습니다: 완전히 관리되며, 강한 일관성을 가지며, 극히 높은 내구성과 가용성을 위해 설계되었습니다.
Garage와 MinIO는 자가 호스팅, S3 호환 대체 옵션: Garage는 가볍고, 지리적으로 분산된 소규모에서 중규모 클러스터를 위한 설계가 되었으며, MinIO는 S3 API 기능 범위를 광범위하게 지원하고, 대규모 배포에서의 고성능을 강조합니다.
Temporal SDK를 사용하여 Go로 워크플로우 구축하기
몇 분 안에 Docker에서 Garage 실행하기
Garage은 소규모에서 중간 규모 배포에 적합한 오픈소스, 자체 호스팅, S3 호환 오브젝트 스토리지 시스템으로, 강력한 내구성과 지리 분산에 중점을 두고 설계되었습니다.
LLM 추론 및 LLM 애플리케이션을 위한 종단간 가시성 전략
LLM 시스템은 전통적인 API 모니터링으로는 파악할 수 없는 방식으로 실패합니다. 큐가 조용히 가득 차고, GPU 메모리는 CPU가 바쁘게 보이기 훨씬 전에 포화 상태에 도달하며, 지연 시간은 애플리케이션 계층이 아닌 배치 처리 계층에서 급격히 증가합니다.
RAG에서의 청크링 전략 비교
Chunking은 Retrieval ‑ Augmented Generation (RAG)에서 가장 과소평가되는 하이퍼파라미터입니다: 이는 조용히 LLM이 “보는” 내용을 결정하며, 데이터의 인gestion 비용을 얼마나 많이 증가시키는지, 그리고 각 답변당 LLM의 컨텍스트 창을 얼마나 많이 소모하는지를 결정합니다.
시스템, 인프라, AI 엔지니어링에 관한 새 글을 받아보세요.