LLM

Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)

Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)

Los ASIC y los circuitos de silicio personalizados aumentan la velocidad y la eficiencia de la inferencia de LLM.

El futuro de la IA no se trata solo de modelos más inteligentes, sino de modelos capaces de razonar. También se trata del silicio que se adapta a la forma en que esos modelos se sirven realmente. El hardware especializado para la inferencia de LLM sigue un camino reminiscente de la transición de la minería de Bitcoin de las GPU a las ASIC diseñadas a medida, solo que con restricciones más duras porque los modelos y las recetas de precisión continúan evolucionando.
DGX Spark vs. Mac Studio: Análisis de precios del supercomputador personal de IA de NVIDIA

DGX Spark vs. Mac Studio: Análisis de precios del supercomputador personal de IA de NVIDIA

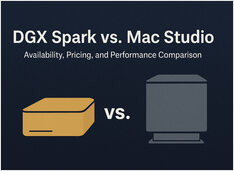
Disponibilidad, precios de venta al por menor reales en seis países y comparación con el Mac Studio.

NVIDIA DGX Spark es real, está a la venta a partir del 15/10/2025 y está dirigido a desarrolladores de CUDA que necesitan trabajo local con LLM con un stack de IA de NVIDIA integrado. El PVP en EE. UU. es de $3.999; el precio minorista en Reino Unido/Alemania/Japón es superior debido al IVA y al canal de distribución. Los precios públicos en estantería en AUD/KRW todavía no están ampliamente publicados.

La ensitización de Ollama: las primeras señales

La ensitización de Ollama: las primeras señales

Mi perspectiva sobre el estado actual del desarrollo de Ollama

Ollama se ha convertido rápidamente en una de las herramientas más populares para ejecutar LLMs localmente. Su simple CLI y la gestión de modelos simplificada lo han convertido en una opción predilecta para los desarrolladores que desean trabajar con modelos de IA fuera de la nube.

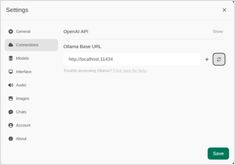
Interfaz de chat para instancias locales de Ollama

Interfaz de chat para instancias locales de Ollama

Breve visión general de las interfaces de usuario más destacadas para Ollama en 2025

Locally hosted Ollama permite ejecutar modelos de lenguaje grandes en tu propia máquina, pero usarlo desde la línea de comandos no es muy amigable para el usuario. Aquí hay varios proyectos de código abierto que ofrecen interfaces estilo ChatGPT que se conectan a un Ollama local.