
OpenClaw: Examinando un asistente de IA autohospedado como un sistema real
Guía del Asistente de IA OpenClaw
La mayoría de las configuraciones de IA local comienzan de la misma manera: un modelo, un entorno de ejecución y una interfaz de chat.
Guía del Asistente de IA OpenClaw
La mayoría de las configuraciones de IA local comienzan de la misma manera: un modelo, un entorno de ejecución y una interfaz de chat.
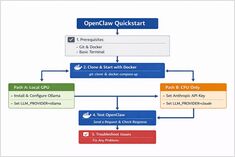
Instala OpenClaw localmente con Ollama
OpenClaw es un asistente de IA autoalojado diseñado para ejecutarse con entornos de ejecución de LLM locales como Ollama o con modelos basados en la nube como Claude Sonnet.
Construye flujos de trabajo en Go con el SDK de Temporal
Estrategia de observabilidad integral para la inferencia de LLM y aplicaciones de LLM
Los sistemas de LLM fallan de maneras que la monitorización de APIs tradicional no puede detectar: las colas se llenan en silencio, la memoria de la GPU se satura mucho antes de que la CPU parezca estar ocupada, y la latencia se dispara en la capa de agrupamiento (batching) en lugar de en la capa de aplicación.
Métricas, paneles, registros y alertas para sistemas en producción: Prometheus, Grafana, Kubernetes y cargas de trabajo de IA.
Observabilidad es la base de los sistemas de producción confiables.
Sin métricas, paneles de control y alertas, los clústeres de Kubernetes se desvían, las cargas de trabajo de IA fallan en silencio y las regresiones de latencia pasan desapercibidas hasta que los usuarios se quejan.
De RAG básico a producción: fragmentación, búsqueda vectorial, reordenamiento y evaluación en una sola guía.
Controla los datos y los modelos con LLMs autoalojados
El autoalojamiento de modelos de lenguaje grandes (LLM) mantiene los datos, los modelos y la inferencia bajo su control: una vía práctica hacia la soberanía de la IA para equipos, empresas y naciones.
Prueba de velocidad de LLM en RTX 4080 con 16 GB de VRAM
Ejecutar modelos de lenguaje grandes localmente te ofrece privacidad, capacidad de funcionamiento sin conexión y cero costos de API. Esta benchmark revela exactamente lo que se puede esperar de 14 populares LLMs en Ollama en una RTX 4080.
Repositorios de Python en tendencia de enero de 2026
El ecosistema de Python de este mes está dominado por las habilidades de Claude y las herramientas para agentes de IA. Este análisis analiza los repositorios de Python más populares en GitHub.
Repositorios de Rust trending en enero de 2026
El ecosistema de Rust está explotando con proyectos innovadores, especialmente en herramientas de codificación de IA y aplicaciones de terminal. Este análisis examina los mejores repositorios de Rust trending en GitHub de este mes.
Repositorios de Go trending de enero de 2026
El ecosistema de Go continúa prosperando con proyectos innovadores que abarcan herramientas de IA, aplicaciones autohospedadas y infraestructura para desarrolladores. Este análisis examina los repositorios de Go más trending en GitHub de este mes.
Alternativa de ChatGPT autohospedada para modelos de lenguaje local
Open WebUI es una poderosa, extensible y rica en características interfaz web autogestionada para interactuar con modelos de lenguaje grandes.
Inferencia rápida de LLM con la API de OpenAI
vLLM es un motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grandes (LLMs) desarrollado por el laboratorio Sky Computing de la Universidad de California en Berkeley.
Precios reales en AUD de minoristas australianos ahora
El NVIDIA DGX Spark (GB10 Grace Blackwell) ya está disponible en Australia en los principales minoristas de PC con stock local. Si has estado siguiendo los precios y disponibilidad globales del DGX Spark, te interesará saber que los precios en Australia oscilan entre $6.249 y $7.999 AUD, dependiendo de la configuración de almacenamiento y del minorista.