
Rückblick für Hermes-Agent: Selbst gehostetes Gedächtnis mit lokalen LLMs
Permanenter Hermes-Speicher auf Ihrer eigenen Hardware.
Ein selbst gehosteter KI-Agent benötigt mehr als ein langes Kontextfenster. Er braucht eine Möglichkeit, nützliche Fakten beizubehalten, frühere Entscheidungen abzurufen und seine Kenntnis davon, was er weiß, zu revidieren, während sich Projekte weiterentwickeln.
Hermes Agent liefert eingebaute Speicherdateien mit, aber ein externer Anbieter kann eine viel reichhaltigere Abfrage über Sitzungen hinweg bereitstellen. Hindsight ist eine der interessanteren Optionen in diesem Bereich. Dieser Leitfaden installiert es für Hermes ohne Cloud-Inferenz, zunächst als All-in-one-Docker-Container und dann gegen einen bestehenden PostgreSQL-Server mit separaten lokalen Modell-Endpunkten.
Der Leitfaden behandelt die Bereitstellung, die Auswahl und Anbindung lokaler Embedding-, Reranking- und generativer Modelle, die Steuerung dessen, was der automatische Retain-Prozess in die Datenbank schreibt, die Verbindung zu Hermes und die operative Ebene: Sicherung, Verschieben einer eingebetteten Datenbank auf einen eigenen PostgreSQL-Server und die alltägliche Datenbank-Hygiene. Die Beispiele verwenden ein bewusstes Port-Schema — 8080 für den Haupt-llama.cpp-Server, 8081 für Embeddings, 8082 für Reranking, 11434 für Ollama — ändern Sie diese also in die Ports, die Sie bereits verwenden, und halten Sie die kleinen Server vom Port des Hauptmodells fern.
Was Hindsight tut
Hindsight ist eine persistente Agenten-Speicher-Engine mit drei Hauptoperationen: retain (behalten), recall (abrufen) und reflect (reflektieren). Retain extrahiert und speichert Informationen; recall kombiniert semantische, stichwortbasierte, graphbasierte und zeitliche Abfrage; reflect synthetisiert eine Antwort aus angesammelten Erinnerungen. Eine Hintergrund-Konsolidierung kann überlappende Beobachtungen in eine nützlichere Wissensschicht verwandeln.
Es ist nicht nur eine Embedding-Datenbank. Ein Vektorspeicher kann ähnliche Passagen lokalisieren, aber ein System für Gedächtnis muss auch Chronologie, Projektgrenzen, widersprüchliche Beweise und Änderungen in Entscheidungen bewahren. Diese Fehlerarten werden in selbst verstärkende Speicher-Schleifen untersucht.
Für den weiteren Markt siehe Vergleich von Agenten-Speicher-Anbietern. Hermees’ eingebaute MEMORY.md, USER.md und Speichermodi werden im Speichersystem des Hermes Agent behandelt, daher geht dieser Artikel davon aus, dass Sie wissen, wie die eingebaute Schicht funktioniert.
Warum über Mnemosyne hinausgehen
Mnemosyne für Hermes bietet ansprechende lokale, datenschutzfreundliche Ideen, einschließlich SQLite-Speicher und hybrider Abfrage. In der Praxis können Installationsbeschränkungen, Versionskompatibilität, das Verhalten der Schreibgenehmigung und schnelle Änderungen um die 4.0-Vorversionen herum den Betrieb schwer vorhersagbar machen. Das sind operative Anliegen, kein Beweis dafür, dass Mnemosynes Speichermodell grundlegend fehlerhaft ist.
Hindsight ist ebenfalls nicht frei von Abhängigkeiten: Sein Docker-Image und lokale Modelle können erheblichen Speicherplatz belegen. Den Betrieb seiner API als unabhängigen Dienst, mit Inferenz woanders, hält Upgrades und Fehlersuche vom Agenten selbst isoliert.
Eine Bereitstellung wählen
| Komponente | A: All-in-one-Container | B: Vorhandener PostgreSQL-Server |
|---|---|---|
| Hindsight API und UI | Docker-Container | Docker-Container |
| PostgreSQL | Eingebettetes pg0 im Container |
Vorhandener PostgreSQL-Host |
| Generatives LLM | Externer llama.cpp | Externer llama.cpp |
| Embeddings | Standard lokal oder extern | Externes Ollama oder llama.cpp |
| Reranking | Standard lokal oder extern | Externer Rerank-Server |
| Am besten geeignet für | Schnelle Auswertung | Längere, isolierte Installation |
Hier bedeutet „All-in-one", dass die Hindsight-API, die UI und die Datenbank in einem Container sind; das inferierende LLM wird weiterhin woanders gehostet. Das ist absichtlich: Das offizielle Hindsight-Image von Docker bündelt keinen einsatzbereiten lokalen generativen llama.cpp-Server.
Verwenden Sie LAN-erreichbare Adressen, nicht localhost, für Dienste, die auf einem anderen Host laufen. Beschränken Sie diese Ports auf vertrauenswürdige Clients; die Beispiel-dummy-Schlüssel sind Kompatibilitätsplatzhalter, keine Authentifizierung.
Option A: All-in-One-Hindsight-Container
Dies ist die einfachste Art, Hindsight zu bewerten, ohne die Hermes-VM mit Python, Torch und lokalen Modellabhängigkeiten zu füllen. Der Container führt Hindsight und eingebettetes PostgreSQL aus, während Ihr Haupt-llama.cpp-LLM die Speicheraufarbeitung und Reflexion handhabt.
Zwei Image-Tags sind hier wichtig. ghcr.io/vectorize-io/hindsight:latest ist das große Image — etwa 9 GB auf AMD64 — da es einen BGE-Embedder, einen MiniLM-Reranker und eingebettetes PostgreSQL bündelt. latest-slim ist etwa 500 MB groß und erwartet, dass diese beiden Modelle woanders liegen, was Sie wollen, sobald Sie Hindsight auf die Embedding- und Reranking-Einrichtung in „Lokale Modelle bereitstellen und verdrahten" ausrichten. Sobald der Health-Check besteht, pinnen Sie ein bestimmtes Tag: ein wandelndes Tag ist eine schlechte Passform für eine Datenbank, die Sie beizubehalten gedenken.
Erstellen Sie ein Verzeichnis und eine Compose-Datei auf dem Hindsight-Host:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # Memory API
      - "9999:9999"  # Control-plane UI
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Ersetzen Sie WORKSTATION_IP durch den Host, der llama.cpp ausführt. Auf Linux wird host.docker.internal nur aufgelöst, wenn der Container die oben gezeigte host-gateway-Zuordnung erklärt; ohne sie zeigt eine Basis-URL von http://host.docker.internal:8080/v1 nirgendwohin. Die 1-GB-Reservierung für gemeinsam genutzten Speicher ist besonders nützlich für das Indizieren von eingebettetem PostgreSQL; Docker kleiner Standard-/dev/shm kann zu Fehlschlägen führen. Ein benannter Volume bewahrt die Datenbank, wenn der Container neu erstellt wird, und eine Bind-Mount-Alternative muss von uid 1000, dem Benutzer im Image, besessen werden.
HINDSIGHT_API_WORKER_ID sollte über Neuanlegungen hinweg stabil bleiben — Doccers Standard ist der Hostname des Containers, und eine Aufgabe, die bei einem Tod des Containers mitten im Flug war, bleibt unter der alten worker id festgefahren.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Wenn Ihre installierte Hindsight-Version den Health-Check auf einem anderen Pfad aussetzt, inspizieren Sie http://localhost:8888/docs und die Container-Logs. Die Steuerungsfläche ist normalerweise auf http://HINDSIGHT_HOST:9999 verfügbar. Sobald die grundlegende Bereitstellung funktioniert, können Sie auch ihre Embedding- und Reranking-Anbieter auf die Konfiguration in „Lokale Modelle bereitstellen und verdrahten" ausrichten, anstatt die Standardmodelle im Container zu laden.
Stellen Sie die Ports 8888 oder 9999 nicht direkt dem Internet frei. Verwenden Sie ein privates Netzwerk oder einen authentifizierten Reverse-Proxy. Eingebettetes PostgreSQL ist bequem zum Testen, aber eine extern verwaltete Datenbank ist leichter zu sichern und zu warten. Eine Datenbank, die bereits in diesem Volume existiert, wird mit dem Dump und Restore in Eingebettete Datenbank auf einen dedizierten Server verschieben verschoben.
Option B: Hindsight gegen einen bestehenden PostgreSQL-Server
Für eine länger laufende Installation bevorzuge ich, die Hindsight-API, die Datenbank und die Inferenz-Endpunkte getrennt zu halten. Die Hindsight-VM kann klein bleiben, da sie Orchestrierung und HTTP-Dienste ausführt statt schwerer Modelle. Die folgenden Schritte starten gegen einen leeren Server. Eine Datenbank, die bereits im Volume von Option A lebt, wird in Eingebettete Datenbank auf einen dedizierten Server verschieben verschoben.
PostgreSQL und pgvector vorbereiten
Hindsight benötigt PostgreSQL 14 oder neuer und eine Vektor-Erweiterung in der hindsight-Datenbank. Die Erweiterung ist pro Datenbank: Die Installation des Pakets auf dem Server tut nichts, bis CREATE EXTENSION dort ausgeführt wird. Auf einem Debian- oder Ubuntu-PostgreSQL-Server installieren Sie das pgvector-Paket, das der tatsächlichen PostgreSQL-Hauptversion entspricht; beispielsweise auf PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Der Paketname und die Verfügbarkeit hängen von Ihren konfigurierten apt-Repositories ab. Wenn es nicht verfügbar ist, folgen Sie den pgvector-Installationsanweisungen oder installieren Sie ein kompatibles Paket aus dem PostgreSQL-PGDG-Repository. Ändern Sie die PostgreSQL-Hauptversion auf einem geteilten Server nicht blind. Bei den PGDG-PostgreSQL-18-Paketen liefern pg_trgm und btree_gin in postgresql-18. Bei Distro-Paketen sind sie in postgresql-contrib für diese Hauptversion. Die eingebettete Datenbank verwendet beides plus vector.
Erstellen Sie eine dedizierte Rolle und Datenbank als PostgreSQL-Administrator:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
Verbinden Sie sich mit der neuen Datenbank und aktivieren Sie die Erweiterungen:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
Diese Erweiterungen benötigen normalerweise erhöhte Privilegien zur Installation; die Applikationsrolle muss kein Superuser sein. Hindsight verwendet pgvector standardmäßig und wünscht sich 0.8.0 oder neuer für iterative ANN-Scans; ältere Server lehnen diese Einstellung ab. HINDSIGHT_API_VECTOR_EXTENSION kann alternativ pgvectorscale (eine DiskANN-Option, die Hindsight für sehr große Datenbanken dokumentiert) oder vchord auswählen, beides benötigt zusätzliche Paketierung für genau diesen PostgreSQL-Build. Das Wechseln von Algorithmen, nachdem Erinnerungen existieren, stoppt den Start und verlangt nach einer Migration, wählen Sie also vor dem ersten retain. Für eine persönliche Hermes-Datenbank ist pgvector das zu installieren und dann zu stoppen.
Erlauben Sie nur den Hindsight-Host durch pg_hba.conf, beispielsweise:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Setzen Sie PostgressQL listen_addresses entsprechend und verwenden Sie TLS oder ein vertrauenswürdiges privates Netzwerk für Verbindungen zwischen Hosts. Sichern Sie diese Datenbank unabhängig vom Hindsight-Docker-Container. Wenn der Server mit anderen Anwendungen geteilt wird, halten Sie Hindsight in seiner eigenen Datenbank oder setzen Sie HINDSIGHT_API_DATABASE_SCHEMA auf ein Schema, das Sie besitzen; das Standard-Schema ist public.
Hindsight gegen PostgreSQL ausführen
Erstellen Sie compose.yaml auf der Hindsight-VM. Diese Version startet PostgreSQL absichtlich nicht lokal:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Speichern Sie die externe Datenbank-URL in einer Datei namens .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Wenn Ihr Passwort @, :, / oder andere reservierte URL-Zeichen enthält, URL-encodieren Sie es, bevor Sie es in die Verbindungszeichenfolge setzen. Testen Sie, ob die Hindsight-VM den PostgreSQL-Port 5432 erreichen kann und ob pg_hba.conf den Hindsight-Host erlaubt — ein Server, der nur an 127.0.0.1 gebunden ist, verweigert die Verbindung, selbst wenn die URL richtig aussieht. Erlauben Sie dem ersten Start, Datenbank-Migrationen auszuführen; Migrationen werden beim Start ausgeführt, außer Sie setzen HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Mit der API und Datenbank oben, fahren Sie fort mit Modelle für Hindsight wählen und Lokale Modelle bereitstellen und verdrahten, bevor Sie Hermes verbinden.
Modelle für Hindsight wählen
Bereitstellung setzt die API und die Datenbank ins Netzwerk. Die nächste Entscheidung ist, welche Modelle die drei Inferenzrollen füllen: Embeddings für Recall-Kandidaten, einen Reranker, um sie neu zu sortieren, und ein generatives LLM für retain, reflect und Konsolidierung. Eine praktische Standard für einen CPU-Hindsight-Host, dessen GPU bereits mit Konversation beschäftigt ist, ist in-Prozess-Qwen/Qwen3-Embedding-0.6B, in-Prozess-BAAI/bge-reranker-v2-m3 und ein geteilter llama.cpp-Chat-Modell für generative Arbeit.
Embedding-Modelle
Hindsight liest die Embedding-Dimensionalität beim Start und dimensioniert die Datenbank entsprechend, daher ist das Modell, das Sie beim ersten retain wählen, das Modell, das die Datenbank beibehält, bis Sie sie neu aufbauen. Dimensionalität und Instruktionen-Verhalten sind wichtiger als Leaderboard-Rang: Ein stärkerer 8B-Embedder ist keine Migration wert, wenn die Datenbank bereits eine 384- oder 1024-dimensionale ist. Die Zeilen unten sind von leichtesten zu schwersten sortiert; RAM-Zahlen sind approximative geladene Fußabdrücke auf CPU (FP16 / typischer lokaler Load), nicht GGUF-Dateigröße.
| Modell | Params | Dim | Kontext | Geladen | Läufe auf | Notizen |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Hindsight-Standard; in hindsight:latest enthalten. Schnellster lokaler Pfad. Score-Verteilung kalibriert noch viele recall_min_scores-Standards nach dem Verlassen. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | Mittelklassiges Englisch-BGE; sperrt eine 768-dimensionale Datenbank. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Hindsight-dokumentiertes Multilingual-MiniLM; 50+ Sprachen bei der gleichen 384-dimensionale Datenbankbreite wie BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Standard für den onnx-Anbieter; leichter multilingualer CPU-Pfad, wenn Sie einen ONNX-Export haben. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Häufiger Ollama-Embedder; längerer Kontext als klassisches BGE, weiterhin Englisch-first. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 nur Text (Vision/Audio-Türme deaktivieren). 100+ Sprachen + Code; MRL trunciert auf 512/256/128; Instruktionen-Präfixe für Suche vs Dokument. Volle multimodale Ladung ist 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU oder GPU | Starker multilingualer Dual-Encoder; gleiche Breite wie Qwen3-0.6B, daher benötigt ein Wechsel gleicher Dimension noch eine volle Neueinbettung. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | Der Standard dieses Leitfadens. Instruktionsempfindlich (Suchinstruktion auf der Abfrageseite); bequem auf CPU. Lokaler Anbieter wendet die Instruktion automatisch an; OpenAI-kompatible Server benötigen HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Qwen3-Qualitätsstufe; sperrt eine 2560-dimensionale Datenbank. Nicht machbar, wenn die konversationelle GPU bereits gesättigt ist. |
Wie das Modell ausgeführt wird, ist die andere Hälfte der Wahl. Hindsights Embedding-Anbieter, vom einfachsten zu den meisten beweglichen Teilen:
| Anbieter | Wie es läuft | Am besten geeignet für | Notizen |
|---|---|---|---|
local |
In-Prozess-SentenceTransformers; kein Sidecar | Eindeuter Hindsight-Host, CPU-Embedder | Standardpfad. Setzen Sie HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Kein llama.cpp, Ollama oder TEI. |
onnx |
In-Prozess-ONNX-Runtime | Leichtere CPU als Torch; Sie haben bereits einen ONNX-Export | Benötigt hindsight-api-slim[local-onnx] und HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Externer OpenAI-kompatibler oder HF TEI-Endpunkt | Embeddings vom API-Prozess weg; geteilter GPU/CPU-Host | Was „Lokale Modelle bereitstellen und verdrahten" für Ollama / llama.cpp / TEI konfiguriert. Nur wertvoll für das Sidecar, wenn Sie Isolation oder einen anderen Rechner wollen. |
Qwen3-Embedding-0.6B benötigt keinen externen Embedding-Dienst. Auf einem CPU-Hindsight-Host lädt es im API-Prozess mit dem local-Anbieter — Hugging Face lädt die Gewichte beim ersten Start herunter, und der Anbieter wendet die Suchinstruktion des Modells selbst an:
# Compose-Umgebung (oder äquivalente .env-Schlüssel)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Verwenden Sie einen externen OpenAI-kompatiblen Endpunkt nur, wenn Sie den Embedder auf einem anderen Rechner oder vom API-Prozess weg wollen. Ollama ist ein solcher Host:
# Embeddings: Qwen3-Embedding-0.6B auf Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Ersetzen Sie Host, Port und Tag durch das, was ollama list auf Ihrem Inferenz-Rechner zeigt.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX hängt vom Anbieter ab:
| Pfad | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Leer lassen / leer — der In-Prozess-Anbieter wendet Qwen’s Suchinstruktion selbst an | Leer lassen |
| Externes Ollama / llama.cpp / OpenAI-kompatibel | Offizielle Qwen3-Retrieval-Instruktion (echter Zeilenumbruch vor Query:) |
Leer lassen — gespeicherte Erinnerungen bleiben roher Text |
| Server kapselt Eingaben bereits in Qwen’s Vorlage | Beide leer lassen — sonst wird die Instruktion doppelt angewendet | Leer lassen |
Für den externen Pfad setzen Sie:
# Echter Zeilenumbruch vor Query:. Bash $'...' ist der zuverlässige Weg, ihn zu übergeben.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
In Compose YAML benötigt derselbe String einen expliziten \n (oder einen wörtlichen Multiline-Wert). Setzen Sie die Präfixe vor dem ersten retain: Das spätere Ändern bedeutet, dass alte Vektoren und neue Abfragen nicht mehr im selben Raum sitzen.
Zwei Eigenschaften entscheiden mehr als der Leaderboard-Rang. Instruktionsempfindlichkeit: Qwen3-Embeddings wenden eine Suchinstruktion auf der Abfrageseite an; ohne das passende Präfix auf einem OpenAI-kompatiblen Server hören die gespeicherte und die Abfrageseite auf, im selben Raum zu sitzen. Dimensionsperrung: Weil die Breite einmalig beim Start gelesen wird, ist das spätere Wechseln von 0.6B zu 4B eine Datenbank-Migration, keine Konfigurationsänderung — und sogar ein Wechsel gleicher Dimension (BGE-M3 ↔ Qwen3-0.6B, oder EmbeddingGemma 2 ↔ nomic bei 768) ändert den Vektorraum, daher werden Datenbankvektoren nicht automatisch neu berechnet. Planen Sie eine frische Datenbank oder eine manuelle Neueinbettung/Neuindexierung; siehe Export, Import und Migration der Speicherdokument. Nach dem Verlassen von BGE-small, sondieren Sie recall_min_scores gegen die neue Score-Verteilung — Schwellen, die auf BGE-small kalibriert wurden, können für Qwen3-0.6B zu eng sein und den Reranker um Kandidaten bringen. Für Benchmarks und GGUF/Ollama-Hintergrund zu der Qwen3-Familie, siehe Qwen3 Embedding und Reranker Modelle auf Ollama.
Reranking-Modelle
Embeddings rufen einen Kandidatensatz ab; der Reranker bewertet jedes Abfrage/Passage-Paar und sortiert es neu, bevor Hindsight es injiziert. Mit dem local-Anbieter lädt Hindsight einen SentenceTransformers-Cross-Encoder (oder einen generativen Reranker, wo unterstützt). Mit einem externen Cohere-kompatiblen Endpunkt postet es den vollen Cohere-Stil-Body an HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Der Reranker ist optional, aber sobald der Embedder fixiert ist, ist er normalerweise der größte Recall-Qualitäts-Hebel — und, auf CPU, oft der meiste Recall-Uhrzeit-Anteil. Die Zeilen sind von leichtesten zu schwersten sortiert.
| Modell | Params | Typ | Kontext | Läufe auf | Notizen |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-Encoder | 128 | CPU | Hindsight-Standard; in hindsight:latest enthalten. Unter einer Sekunde für ~20 Kandidaten. Als benannter Fallback behalten, falls ein schwereres BGE-Modell zu langsam ist. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-Encoder | 512 | CPU | Gleiche Familie, höhere Genauigkeit; weiterhin englisch-betonter MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-Encoder | 512 | CPU | Hindsight-dokumentierter Multilingual-MiniLM-Reranker. |
BAAI/bge-reranker-base |
278M | Cross-Encoder | 512 | CPU | Moderate Verbesserung gegenüber MiniLM; en/zh. Häufig besprochen; übersprungen, wenn v2-m3 bereits ins Latenz-Budget passt. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-Encoder | 8k | CPU oder GPU | Praktischer Multilingual-Standard auf CPU. Auf einer ~500-Speicher-Datenbank, ~2.6–2.8 s pro Recall bei einem 20-Kandidaten-Untergrenze (~140 ms/Kandidat; ~93–99% der Recall-Zeit). Kandidaten-Grenzen 20/40/80; das Herabsenken der Untergrenze von 20 → 10 halbiert die Rerank-Kosten in etwa. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Generativ (yes-token) | 32k | Bevorzugt GPU | Instruktionsempfindlich, langer Kontext. Kein Drop-in-Cross-Encoder: benötigt recente SentenceTransformers-generative-Reranker-Unterstützung, und llama.cpp /rerank Scoring hat bekannte Falsch-Score-Bugs (hindsight-benchmarks#11). Validieren Sie vor der Adoption. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-Encoder | 8k | Bevorzugt GPU | Starke Multilingual-Qualität; übertrieben für eine persönliche Datenbank mit ein paar hundert Erinnerungen, wenn die GPU bereits voll ist. |
Qwen/Qwen3-Reranker-4B |
4B | Generativ | 32k | GPU | Höherer Qualitäts-Qwen-Kandidat; nicht machbar ohne dedizierte VRAM. |
Qwen/Qwen3-Reranker-8B |
8B | Generativ | 32k | GPU | Familien-Spitzenschnitt; gleiche generative-Scoring-Einschränkungen, noch größer. |
Cloud-API-Reranker (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe und ähnliche) funktionieren in Hindsight, aber senden Speichertext außer Haus. Für eine nur lokale Cross-Domain-Layout sind sie außerhalb des Bereichs.
Zwei operative Einschränkungen dominieren die Wahl. VRAM: Wenn das konversationelle Modell die GPU bereits sättigt (zum Beispiel ein Qwen3.8-27B Q5 auf einer 16-GB-Karte ohne Puffer), ist jede „Bevorzugt GPU"-Zeile von der Tafel und die live Wahl kollabiert zu MiniLM oder BGE-v2-m3 auf CPU. Kandidatenanzahl: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 im externen-Endpunkt-Beispiel unten) begrenzt, wie viele Passagen das Modell neu bewertet; jeder Kandidat ist ein vollständiger Vorwärtsschritt, daher schneiden Sie die Untergrenze, bevor Sie eine Modellstufe springen. Für Qwen3 via llama.cpp muss das GGUF den Ranking-Kopf behalten — ein altes convert_hf_to_gguf.py, das es wegwirft, bewertet jede Passage nahe null — und sogar eine korrekte Konversion benötigt noch einen bekannten gut/beschlecht-Passage-Test, bis der generative Scoring-Pfad bestätigt ist.
Generative LLM-Ebenen
Embedding- und Reranking-Modelle sind keine Ersatz für das generative LLM, das verwendet wird, um Erinnerungen zu extrahieren und zu verarbeiten. Hindsight unterstützt ein Standard-LLM und operationsspezifische Überschreibungen, die denselben llama.cpp-Server oder unabhängige Endpunkte anvisieren können.
| Hindsight-Operation | Zweck | Praktische Modellstufe | Qwen-Beispiele |
|---|---|---|---|
| Retain | Extrahiere Fakten, Entitäten, Entscheidungen und Chronologie | 4B Minimum für Tests; 9B bevorzugt | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Semantische, stichwortbasierte, graphbasierte und zeitliche Abfrage | Kein generatives LLM erforderlich | Qwen3-Embedding-0.6B + Reranker |
| Reflect | Beantworte Fragen durch Synthese abgerufenener Erinnerungen | 9B bis 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Konsolidierung | Harmonisiere und komprimiere verwandte Fakten | 9B bevorzugt | Qwen3.5-9B / Qwen3.8-27B |
| Mental-Model-Refresh | Aktualisiere länger lebende synthetisiertes Verständnis | 9B bis 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Das sind operative Empfehlungen, keine offiziellen Hindsight-Minimum-Parametern. Ein kleines Modell kann eine Portnummer korrekt extrahieren, aber übersehen, dass eine frühere architektonische Entscheidung überholt wurde. Strukturierte-Output-Verlässlichkeit und treue Behandlung von Verneinung sind wichtiger als nominale Parametermenge allein. Hindsights eigene Temperatur-Standards sind es wert, allein zu bleiben — 0.1 für retain, 0.0 für Konsolidierung, 0.9 für reflect — und für retain und Konsolidierung, ist der Nicht-Denken-Alias es wert, zu servieren, wenn Ihr llama.cpp-Build einen hat, da die kleinen Qwen3.5-Checkpoints viele Tokens im Denkmodus verbringen.
Für eine Bereitstellung mit einem vorhandenen Qwen3.8-27B-llama.cpp-Endpunkt, beginnen Sie damit, ihn für generative Hindsight-Aufgaben mit niedriger Parallelität zu teilen:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Später, leiten Sie routinemäßige Extraktion an ein unabhängiges 9B-Modell und reservieren Sie das 27B für schwierige Reflexion:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Das kleinere 4B-Modell ist ökonomisch, aber benötigt Tests; 9B ist ein sinnvoller Qualität/Leistung-Kompromiss. Wenn retain und Konsolidierung ein kleines Modell teilen, senken Sie HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE auf 2 — die Standard-Batch von 8 ist ein langer Prompt für ein kleines Kontextfenster. Qwen3.6-35B-A3B ist attraktiv für einen separaten gut versorgten Inferenz-Server (es ist ein Mixture-of-Experts-Modell mit etwa 3 Milliarden aktiven Parametern, daher budgetieren Sie es als kleines aktives Modell), während ein 27B-dichtes Modell normalerweise für jedes routinemäßige retain-Ereignis unnötig ist. Das Limitieren der Hintergrund-Parallelität schützt das Hermes-Konversationsmodell vor Speicher-Wartungs-Ausbrüchen.
Lokale Modelle bereitstellen und verdrahten
Wenn die In-Prozess-local-Embedding- und Reranker-Einstellungen in „Modelle wählen" ausreichen, können Sie die externen Ollama- und llama.cpp-Unterbereiche überspringen und direkt zur Verdrahtung springen — oder Compose auf die dort gezeigten local-Standards lassen. Externe Endpunkte sind wichtig, wenn der Embedder oder Reranker auf einem anderen Host liegen soll.
Externe Embeddings: Ollama oder llama.cpp
Externe Embeddings sind für Fälle, in denen Sie Qwen3-Embedding-0.6B (oder ein anderes Modell) auf einem separaten Host wollen. Zwei praktische Optionen sind Ollama, das Modellakquise und Serving mit wenig Konfiguration handhabt, und llama.cpp, das präzise Kontrolle über GGUF-Quantisierung, CPU-Threads, Geräteplatzierung und Batching gibt. Modell-Hintergrund und Benchmarks für beide Qwen3-Modelle sind in Qwen3 Embedding und Reranker Modelle auf Ollama.
Qwen3-Embedding-0.6B gibt 1024-dimensionale Vektoren zurück, und Hindsight liest diese Breite beim Start und dimensioniert die Datenbank entsprechend. Eine Datenbank, die mit dem eingebetteten 384-dimensionalen BGE-Modell erstellt wurde, kann dieses Modell nicht aufnehmen — beginnen Sie mit einer leeren Datenbank oder einem leeren Volume und entscheiden Sie das Embedding-Modell vor dem ersten retain. Ein späterer Anbieterwechsel für Embeddings erfordert Neueinbettung gespeicherter Datensätze, selbst wenn beide Modelle die gleiche Dimensionalität verwenden.
Option 1: Ollama für Qwen3-Embedding-0.6B
Installieren Sie Ollama auf dem Inferenz-Host, indem Sie seine offizielle Linux-Installationsdokumentation verwenden, und starten Sie dann das Embedding-Modell:
ollama pull qwen3-embedding:0.6b
ollama serve
Für Remote-Zugriff konfigurieren Sie Ollamas OLLAMA_HOST=0.0.0.0:11434 in seiner Service-Umgebung, starten Sie den Service neu und Firewallen Sie ihn auf die Hindsight-VM — das Verfahren wird in Ollama Remote-Zugriff behandelt. Ein Daemon, der nur an 127.0.0.1 gebunden ist, ist für den Hindsight-Container unsichtbar. Prüfen Sie zuerst den Modellnamen mit ollama list und testen Sie den Standard-Embedding-Endpunkt:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Hindsights OpenAI-Embedding-Anbieter ruft stattdessen Ollamas OpenAI-kompatiblen /v1/embeddings-Endpunkt auf. Verifizieren Sie, dass dieser Endpunkt mit Ihrer Ollama-Version funktioniert, bevor Sie Hindsight konfigurieren. Ollama ist unkompliziert für Embeddings; nehmen Sie nicht an, dass seine API einen kompatiblen Reranking-Endpunkt bietet. Für Reranking, bevorzugen Sie den unten stehenden In-Prozess-local-BGE-Pfad oder einen separaten llama.cpp / TEI-Endpunkt, nachdem Sie Scores validiert haben.
Option 2: llama.cpp für Qwen3-Embedding-0.6B
Laden Sie eine verifizierte Qwen3-Embedding-0.6B-GGUF-Konversion herunter. Verwenden Sie den GGUF-Dateinamen, den Sie tatsächlich heruntergeladen haben:
#!/bin/sh
# start-embedding.sh - Nur-CPU-Embedding-Server
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Qwen3-Embeddings verwenden Last-Token-Pooling, im Gegensatz zum CLS-Pooling, das von einigen BGE-Modellen verwendet wird. Ein nur-CPU-llama.cpp-Build ist vorzuziehen, wenn Sie absolut keine CUDA-Initialisierung auf einer Workstation wollen, deren GPU von einem großen konversationellen Modell besetzt ist. Aktivieren Sie --reranking nicht auf diesem Embedding-Server: diese Kombination ist eine bekannte Methode, um einen Nullvektor zu bekommen.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Eine volle Dimension Qwen3-Embedding-0.6B-Ausgabe sollte 1024 Floats enthalten. Prüfen Sie, dass die GGUF-Konversion und Ihre Hindsight-Abfrage/Dokument-Instruktionen-Behandlung kompatibel sind; instruktionsempfindliche Embedding-Modelle können Genauigkeit verlieren, wenn sie falsch promptet werden.
Reranker: lokales BGE oder Qwen3 via llama.cpp
Reranking unterscheidet sich von Embeddings: Das Modell bewertet jedes Abfrage/Dokument-Paar und gibt einen Relevanzscore zurück. Auf einem nur-CPU-Hindsight-Host — oder wann immer die konversationelle GPU keinen VRAM-Puffer hat — ist der praktische Pfad Hindsights local-Anbieter mit BAAI/bge-reranker-v2-m3 (oder der leichtere MiniLM-Standard). Kein Sidecar ist erforderlich:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B ist ein generativer yes-token-Score, kein klassischer Cross-Encoder. Es kann via llama.cpp mit einer für Ranking entwickelten GGUF-Konversion serviert werden, aber behandeln Sie diesen Pfad als experimentell, bis Sie Scores auf einem bekannten gut/beschlecht-Paar bestätigen: ein altes convert_hf_to_gguf.py, das den Ranking-Kopf wegwirft, bewertet jede Passage nahe null, und llama.cpps nativer /rerank-Pfad hat bekannte Falsch-Score-Berichte für diese Familie.
#!/bin/sh
# start-reranker.sh - GPU oder CPU wie durch --n-gpu-layers ausgewählt
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Setzen Sie --n-gpu-layers 0, um es auf CPU auszuführen. Die GPU-Version benötigt zusätzliche VRAM für Berechnungspuffer und Kontext, nicht nur Modellgewichte; nehmen Sie nicht an, dass die Dateigröße die gesamte GPU-Zuweisung ist.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Das PostgreSQL-Dokument sollte über dem nicht verwandten Dokument rangieren; all-null-Relevanzscores bedeuten, dass das GGUF die falsche Konversion ist, und Recall wird zufällig aussehen, selbst wenn die Fakten gespeichert sind. Prüfen Sie die genaue Form von results[].index und results[].relevance_score: Hindsight erwartet eine Cohere-kompatible Rerank-Antwort, und llama.cpp-Kompatibilität kann sich über Builds hinweg unterscheiden.
Endpunkte in Hindsight verdrahten
Fügen Sie die folgenden Umgebungsvariablen dem Hindsight-Compose-Service hinzu oder speichern Sie sie in seiner .env-Datei. Wählen Sie einen Embedding-Pfad — in-Prozess-local, Ollama oder llama.cpp — nie zwei auf einmal.
# Option A: In-Prozess-Qwen3 auf dem Hindsight-Host (CPU; kein Sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Option B: llama.cpp-Embedding-Service
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option C: Ollama auf einem anderen Host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option: Lokaler BGE-Reranker (kein Sidecar; bevorzugt auf CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Option: llama.cpp-Cohere-kompatibler Rerank-Endpunkt (validieren Sie Qwen3-Scores zuerst)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Die Variablennamen sind anbieterspezifisch, und ein Fehlgriff ist still: HINDSIGHT_API_EMBEDDINGS_BASE_URL ist der falsche Schlüssel, und Hindsight zielt still und heimlich auf OpenAIs eigenen Embedding-Endpunkt statt auf Ihren lokalen Server. Verwenden Sie HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Mit dem Cohere-kompatiblen Reranker-Pfad postet Hindsight den vollen Cohere-Stil-Body an HINDSIGHT_API_RERANKER_COHERE_BASE_URL; wenn das Container-Log eine 404 für /v1/rerank/rerank zeigt, hängt Ihr Build /rerank selbst an und der Wert sollte bei /v1 aufhören.
Für Option B und C, verwenden Sie den HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX-Wert aus Embedding-Modelle (Option A lässt ihn ungesetzt). Testen Sie Abfrage-zu-Passage-Retrieval auf Ihren tatsächlichen Erinnerungen nach dem ersten retain.
Steuern, was sich eingeprägt wird
Mit dem laufenden Stack ist der nächste Fehlermodus normalerweise der Write-Pfad: Hermes standardmäßig auf auto_retain: true, daher kann jeder Gesprächsdurchgang in die Datenbank extrahiert werden. Falsche Vermutungen, verworfene Pläne und explorative Aussagen werden zu durchsuchbaren Fakten, und späterer Recall behandelt sie als Beweise — die Schleife, die in selbst verstärkende Speicher-Schleifen beschrieben ist. Die Erfassungsrichtlinie für Hindsight unter anderen Anbietern wird in Vergleich von Agenten-Speicher-Anbietern zusammengefasst.
Erfassungsmodi, die heute existieren
Es gibt keinen Hermes- oder Hindsight-Schalter mit dem Namen „Sitzungssynthese". Das Plugin behält entweder rohe Gesprächsdurchgänge automatisch bei (optional gebatcht) oder wartet auf einen expliziten hindsight_retain-Tool-Call mit welchem content auch immer Sie ihm geben.
| Modus | Hermes / Hindsight-Einstellungen | Was Sie bekommen |
|---|---|---|
| Kontinuierlich | auto_retain: true, retain_every_n_turns: 1 |
Jeder Durchgang wird behalten und als Transkripttext extrahiert |
| Gebatcht auto | auto_retain: true, retain_every_n_turns erhöhen |
Durchgänge puffern im Plugin; jeder N-te Durchgang sendet eine größere retain-Paylaod dieser roher Durchgänge — weiterhin automatische Extraktion, keine kuratierte Zusammenfassung |
| Explizit nur | auto_retain: false + Tool hindsight_retain |
Nichts wird gespeichert, bis der Agent das Tool mit content (und optionalem context / tags) aufruft |
Gebatcht auto ist keine Sitzungszusammenfassung. Mit retain_every_n_turns > 1 akkumuliert das Hermes-Hindsight-Plugin Durchgänge im Speicher und behält sie als Gesprächs-JSON; bei /new, /reset, /branch und ähnlichen Sitzungswechseln spült es jeden übrigen Puffer unter dem alten Sitzungs-Dokument. Es gibt keinen dedizierten Sitzungs-Ende-Zusammenfasser, und die Leerlauf-Sitzungsabbau hat historisch in der Lage sein, einen ungepufferten Puffer zu verlieren, wenn N > 1 (kein on_session_end-Hook im Plugin). Bevorzugen Sie N: 1, außer Sie akzeptieren diesen Kompromiss.
Kuratiertes „merke diese Sitzung" ist ein Prompt + Tool-Muster, keine Konfigurationsflagge. Setzen Sie auto_retain: false, dann fragen Sie Hermes, die dauerhaften Entscheidungen zusammenzufassen und hindsight_retain mit diesem Text aufzurufen — oder rufen Sie das Tool selbst über den Agenten-Tool-Pfad auf. Datenbank reflect und Konsolidierung sind separate Hindsight-Server-Operationen, die aus dem synthetisieren, was bereits in der Datenbank ist; sie ersetzen keinen Sitzungsende-Write und werden nicht durch einen Hermes-config.json-Schlüssel aktiviert.
Das Setzen von auto_retain auf false deaktiviert die automatische Durchgangsspeicherung. Es fügt keinen menschlichen Genehmigungsdialog vor jedem Write hinzu. Der Agent kann weiterhin hindsight_retain aufrufen, wann immer seine Tools es erlauben; behandeln Sie expliziten retain als bewusste Erfassung, nicht als wartende Queue.
Die Genehmigungs-Queue-Lücke
Ein häufiger Wunsch ist eine wartende Queue von Kandidatenerinnerungen, die Sie überprüfen und genehmigen, bevor sie die Datenbank betreten. Hindsight unter Hermes stellt diesen Vertrag heute nicht bereit. Mnemosyne für Hermes implementiert anbieterspezifische gestufte Writes in einigen Versionen; dieser Pfad ist kein geteilter Hermes-Standard und wendet sich nicht auf das Hindsight-Plugin an. Bis ein Upstream-Genehmigungsfluss existiert, ist das machbare Muster auto_retain: false, bewusster hindsight_retain und Inspektion oder Löschung in der Hindsight-Steuerungsfläche-UI, bevor die nächste Sitzung auf eine schlechte Tatsache verlässt. Es gibt keinen fehlenden write_approval-Schlüssel, den Hindsight in config.json jagen könnte.
Datenbank-Steuern (Missions, Labels, Direktiven, Mental-Modelle)
Menschen nennen die nächste Schicht oft „Feinjustierung". In Hindsight ist es größtenteils Datenbank-Konfiguration, nicht nur Hermes config.json: Missionen und Extraktionseinstellungen steuern, was retain behält; Labels strukturieren Entitäten; Direktiven und Mental-Modelle formen spätere Synthese.
| Steuerung | Wo sie lebt | Wie es hilft |
|---|---|---|
Retain-Mission (retain_mission / Hermes bank_retain_mission) |
Datenbank-Konfiguration | Klare Sprache „Achte auf X, ignoriere Y", in die Extraktion injiziert |
Extraktionsmodus (concise, verbose, custom, …) |
Datenbank-Konfiguration | concise (Standard) behält langfristig wertvolle Fakten; custom ersetzt eingebaute Regeln via retain_custom_instructions |
| Entitäts-Labels | Datenbank-Konfiguration | Kontrolliertes key:value-Vokabular zur Retain-Zeit → Graphen-Links und optionale Tags; verbessert die Retrieval-Struktur, lehnt aber nicht selbst falsche Aussagen ab |
| Direktiven („harte Regeln") | Datenbank-Direktiven-API | Explizite Anweisungen, die während reflect erzwungen werden (Tag-Scope); begrenzen Synthese, keine Write-Genehmigungsschranke |
| Mental-Modelle | Datenbank-Mental-Model-API | Ständige Antworten auf wiederkehrende Fragen, aktualisiert via reflect aus passenden Erinnerungen; abgeleitet, daher vergiften schlechte Quellfakten sie immer noch |
| Reflect / Observations-Mission | Datenbank-Konfiguration | Steuert Synthese und Konsolidierung, nicht den rohen Retain-Feuerhose |
Missionen, concise-Extraktion und Labels reduzieren Rauschen und verbessern Retrieval. Sie ersetzen nicht das Abschalten von Auto-Retain, wenn Genauigkeit wichtiger ist als Vollständigkeit. Bevorzugen Sie eine kurze Retain-Mission, die dauerhafte Projektentscheidungen benennt und Chat-Logistik ignoriert; fügen Sie Entitäts-Labels nur hinzu, wenn Sie eine echte Taxonomie haben; fügen Sie Mental-Modelle für zwei oder drei wiederkehrende Fragen hinzu, nachdem die Datenbank bereits saubere Fakten enthält.
Empfohlenes Hygiene-Profil
Ein konkreter Startpunkt für eine persönliche Hermes-Datenbank:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Setzen Sie auf der Datenbank eine Retain-Mission und lassen Sie die Extraktion im concise-Modus (über die Steuerungsfläche oder die Banks-API). Nach einem expliziten retain, öffnen Sie die UI, bestätigen Sie die Beobachtung und löschen Sie Fehler, bevor die Konsolidierung oder Mental-Model-Refresh ausgeführt wird. Lassen Sie recall_prefetch_method bei recall — reflect verbringt einen Chat-Modell-Call vor jedem Durchgang und injiziert Synthese statt zugrunde liegende Fakten.
Hermes Agent mit Hindsight verbinden
Auf der Hermes-VM, installieren Sie das Katalog-Plugin und führen Sie dann den Setup-Assistenten aus. Wählen Sie Hindsight und den local_external-Modus; das Plugin muss kein eingebettetes PostgreSQL starten oder den Hindsight-Modell-Stack lokal ausführen, und local_embedded würde einen zweiten Hindsight-Daemon neben dem Container starten, den Sie gerade ausgeführt haben.
hermes plugins install hindsight
hermes memory setup hindsight
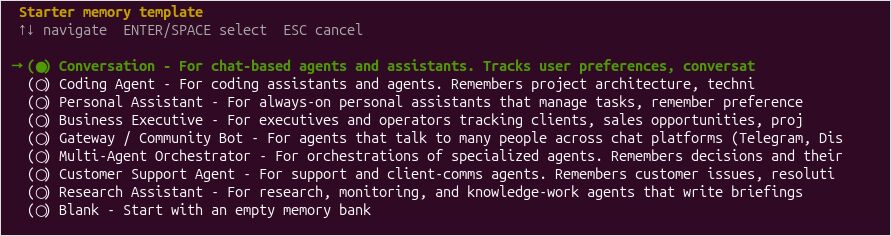
Es gibt eine interessante Menge von Optionen zur Auswahl der Agentenrolle unter Verwendung von Hindsight.
hermes memory status
Die externe Hindsight-Verbindung lebt in ~/.hermes/hindsight/config.json. Eine illustrative Konfiguration, die kontinuierliche Erfassung (Hermes-Standard) beibehält, ist:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Für explizit nur retain und Datenbank-Steuerung, verwenden Sie das Hygiene-Profil in Steuern, was sich eingeprägt wird, statt auto_retain einzuschalten zu lassen. recall_sync: false priorisiert interaktive Reaktionsfähigkeit, kann aber abgerufenen Kontext auf dem folgenden Durchgang injizieren. Verwenden Sie synchronen Recall, wenn die aktuelle Anfrage die neuesten Erinnerungen einbeziehen muss, bevor das Modell anfängt zu antworten. retain_async: true vermeidet das Blockieren gewöhnlicher Antworten, während Erinnerungen verarbeitet werden.
Der Standard des Plugins für Recall ist nur Observations; rohe Welt- und Erfahrungsfakten bleiben in der Datenbank und außer dem Prompt, bis die Konsolidierung eine Observation geschrieben hat, oder bis Sie recall_types auf observation,world,experience verbreitern. Das Verbreitern für die erste Woche und das Beobachten der Steuerungsfläche, dann Verengen, ist eine angemessene Reihenfolge.
Eingebauter Hermes-Speicher bleibt neben dem Anbieter aktiv; das Beibehalten von MEMORY.md und USER.md während Sie lernen, was Hindsight hinzufügt, ist in Ordnung, und der Speicher-System-Artikel ist der Ort, um zu entscheiden, ob die flachen Dateien bleiben sollten.
Starten Sie das Gateway neu, wenn es bereits läuft:
hermes gateway restart
hermes memory status
Der Status sollte Hindsight als aktiven Anbieter identifizieren. Für einen breiteren Befehlsreferenz, einschließlich Hermes’ TUI und Plugin-Befehle, siehe das Hermes Agent CLI-Blitzreferenz.
Speicherverifizieren, nicht nur Installation
Fragen Sie Hermes, eine wegwerfbare Tatsache über ein Testprojekt zu merken, starten Sie eine andere Sitzung und fragen Sie nach dieser Tatsache erneut. Retention ist asynchron standardmäßig und Extraktion wartet auf das Chat-Modell, daher geben Sie dem Haupt-llama.cpp-Server einen Moment, bevor Sie urteilen. Testen Sie dann einen schwierigeren Fall: Sagen Sie Hermes, dass eine frühere Entscheidung sich geändert hat und fragen Sie, welche Entscheidung aktuell ist und warum. Prüfen Sie Hindsights UI und gespeicherte Observations, anstatt vorauszusetzen, dass memory status beweist, dass Ingestion und Recall korrekt sind.
Wenn die Antwort leer zurückkommt, inspizieren Sie die Steuerungsfläche, bevor Sie Modelle ändern. Ein Retain kann erfolgreich sein und für Recall unsichtbar bleiben, während recall_types nur Observations ist und die Konsolidierung nicht ausgeführt wurde — das Verbreitern von recall_types ist der erste Check. Eine verweigerte Verbindung im Embedding-Server-Log bedeutet, dass der Container den Embedding-Port nicht erreichen kann, und all-null-Reranker-Scores bedeuten, dass das GGUF die falsche Konversion ist.
Write-Pfad-Wahlen (auto_retain, Missionen, Genehmigungslücke) werden in Steuern, was sich eingeprägt wird behandelt.
Fehlersuche und operative Notizen
| Symptom | Wahrscheinliche Ursache | Erster Check |
|---|---|---|
| Hermes sagt Anbieter nicht verfügbar | Falsche local_external-URL oder Netzwerkregel |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker startet, PostgreSQL-Fehler | Fehlende Erweiterung, falsche Zugangsdaten oder unzureichender Gemeinspeicher | Container-Logs und pg_extension |
| Embeddings geben 401 oder 404 zurück | Falsche OpenAI-kompatible URL, falscher Umgebungsvariablenname oder Modell-Alias-Abweichung | Direkter /v1/embeddings-Test und Variablennamen |
| Reranking schlägt fehl | Endpunkt- oder Antwortformat-Abweichung, einschließlich verdoppeltem /rerank-Pfad |
Direkter /v1/rerank-Test und Container-Log |
| Recall gibt nichts Nützliches zurück | recall_types auf Observations beschränkt oder null Reranker-Scores |
Steuerungsfläche, dann recall_types, dann Reranker-Konversion |
| Vorhandene Datenbank meldet Dimensionsabweichung | Embedding-Modell geändert | Rebuilden der Vektoren/Reimport mit einem konsistenten Modell |
| Hermes-Antworten werden langsamer | Synchroner Recall oder geteilter LLM-Konkurrenz | Sync-Recall ausschalten; Retain-Parallelität begrenzen |
| Irrelevante Erinnerungen wiederholen sich | Schwache Extraktion, rauschiges Retrieval oder unzureichende Konsolidierung | Inspektion der Observations und Relevanzscores |
| Verbindung zu PostgreSQL wird verweigert | listen_addresses ist noch localhost oder der Client hat den Port des anderen Clusters verwendet |
ss -lntp auf dem Datenbank-Host; starten Sie das Cluster nach dem Ändern von listen_addresses neu |
no pg_hba.conf entry für eine SSL-Verbindung |
Keine host oder hostssl-Zeile für die Client-Adresse oder die Zeile hat kein /32 und wurde übersprungen |
Fügen Sie die Zeile hinzu, laden Sie neu und lesen Sie das PostgreSQL-Log |
pg_restore kann den Dump nicht öffnen |
Der postgres-Benutzer kann das Home-Verzeichnis, das die Datei hält, nicht betreten |
Kopieren Sie den Dump nach /tmp und stellen Sie von dort wieder her |
must be owner of extension btree_gin |
COMMENT ON EXTENSION wurde als Applikationsrolle ausgeführt |
Erstellen Sie die leere Datenbank neu und stellen Sie mit --no-comments wieder her |
PostgreSQL-18-Pakete installiert, pg_lsclusters zeigt nur 14 |
Eine neue Hauptversion erstellt kein Cluster, wenn eines bereits existiert | sudo pg_createcluster 18 main |
Eine praktische kleine Bereitstellung ist 2-4 vCPUs und 4-6 GB RAM für die Hindsight-API-VM, wenn PostgreSQL und alle Inferenz extern sind. Die Festplatten-Zuweisung hängt immer noch vom gewählten Docker-Image und den beibehaltenen Image-Layern ab; weisen Sie zunächst etwa 30-40 GB zu, mit Raum zum Ausbauen. Dimensionieren Sie den PostgreSQL-Host basierend auf dem tatsächlichen Speichervolumen, Speicherleistung und den anderen Datenbanken, die er bedient.
Hindsight-Datenbank sichern und wiederherstellen
Die Speicherdokument ist der einzige Zustand, der wichtig ist, und sie lebt in PostgreSQL. In Option B ist das eine Datenbank, die Sie verwalten; in Option A ist es das eingebettete pg0-Benannt-Volume innerhalb des Containers. Sichern Sie es unabhängig vom Hindsight-Container — das Neuerschaffen des Containers, ohne zuerst das Volume oder die Datenbank aufzunehmen, verwerft die Datenbank, und hermes backup erreicht keine Datenbank, die in einem separaten Dienst läuft.
Option B — externes PostgreSQL. Dumpen Sie die hindsight-Datenbank im Custom-Format und stellen Sie sie dann in eine Scratch-Datenbank wieder her, um das Archiv zu verifizieren, bevor Sie ihm vertrauen:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# In eine Scratch-Datenbank wiederherstellen, um zu beweisen, dass der Dump nutzbar ist
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
Bestätigen Sie die pgvector-Erweiterung und einen Beispiel-Recall in der wiederhergestellten Kopie, bevor Sie das ursprüngliche Dump-Ziel löschen. Bewahren Sie den Dump auf einem anderen Host als die Hindsight-VM und führen Sie dies als PostgreSQL-Administrator (eine Rolle, die Datenbanken erstellen kann) aus statt der Applikationsrolle.
Option A — All-in-one-Container. Die eingebettete Datenbank ist ein Benannt-Volume, daher stoppen Sie den Container und tarren Sie das Volume über ein Wegwerf-Image:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Der Mountpunkt innerhalb des Tar-Containers (/data) ist willkürlich; er aliasiert nur das Benannt-Volume, damit tar es lesen kann. Um auf dasselbe Volume wiederherzustellen, stoppen Sie den Container, leeren Sie das Volume und enttarren Sie das Archiv zurück hinein. Das Verschieben dieser Datenbank auf einen Server, den Sie verwalten, ist der Dump und Restore in Eingebettete Datenbank auf einen dedizierten Server verschieben.
Erstellen Sie einen Snapshot zu drei Momenten statt nach einem Kalenderplan: bevor Sie das Embedding-Modell ändern, bevor ein großes Hindsight- oder PostgreSQL-Upgrade stattfindet und bevor ein reflect- oder Konsolidierungsdurchgang, der die Datenbank neu schreibt, ausgeführt wird. Eine Sicherung, die Sie in eine Scratch-Datenbank wiederhergestellt haben, ist mehr wert als eine, die Sie nur geschrieben haben.
Eingebettete Datenbank auf einen dedizierten Server verschieben
Die All-in-one-Datenbank ist das Benannt-Volume, das in /home/hindsight/.pg0 montiert ist. Das Setzen von HINDSIGHT_API_DATABASE_URL lässt diesen Container die Datenbank öffnen, die in der URL benannt ist, und Migrationen ausführen. Das Volume wird nicht verändert. Verschieben Sie die Zeilen mit pg_dump und pg_restore und behalten Sie denselben Container, indem Sie ihn auf den neuen Server ausrichten.
Der Installationsleitfaden beschreibt eingebettetes pg0 und eine externe URL als zwei Wege, um einen leeren Server zu starten. hindsight-admin Sicherung und Wiederherstellung kopiert Tabellen zwischen Datenbanken; restore trunciert das Ziel-Schema und benötigt, dass die Tabellen zuerst existieren. Export, Import und Migration der Speicherdokument ist die Embedding-Modell-Änderung: dieses Archiv lässt die Vektoren aus und das Ziel berechnet sie neu. Ein Verschieben, das dasselbe Embedding-Modell beibehält, beibehält die Vektoren, und pg_dump ist die Datei, die sie trägt.
Die Hauptversion innerhalb des Containers abgleichen
pg0 lauscht auf 127.0.0.1:5432 innerhalb des Containers. Seine Binärdateien leben unter /home/hindsight/.pg0/installation/<version>/bin, und die Cluster-Daten sind /home/hindsight/.pg0/instances/hindsight/data. Die Rolle, das Passwort und der Datenbankname standardmäßig auf hindsight. Lesen Sie die Serverversion mit diesem Client. Wenn ls /home/hindsight/.pg0/installation einen anderen Build zeigt, verwenden Sie dieses Verzeichnis anstelle von 18.1.0:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
Ein Custom-Format-Dump von diesem Server stellt in dieselbe Hauptversion oder eine neuere wieder her. Ein aktuelles ghcr.io/vectorize-io/hindsight:latest-Image meldet PostgreSQL 18.1. Ubuntu 22.04s Archiv-Paket ist PostgreSQL 14, was ein 18-Archiv nicht laden kann.
Installieren Sie 18 aus dem PostgreSQL-Apt-Repository neben dem Distro-Cluster. Wenn 14/main bereits existiert, erstellt das postgresql-18-Paket kein Cluster:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters sollte 18/main auf dem nächsten freien Port zeigen, 5433, wenn 14 immer noch auf 5432 ist. SELECT version(); auf diesem Port sollte PostgreSQL 18 melden. postgresql-contrib-18 ist ein transitorischer Paketname: apt wählt postgresql-18, und dieses Paket enthält pg_trgm und btree_gin.
Erstellen Sie die Rolle, die Datenbank und die Erweiterungen aus PostgreSQL und pgvector vorbereiten und übergeben Sie -p 5433 an jedem psql, damit die Befehle das 18-Cluster treffen. Die eingebettete Datenbank hat vector, pg_trgm und btree_gin. Ein pgvector-Paket neuer als die Quelle, wie 0.8.7 auf dem Server gegenüber 0.8.5 im Image, akzeptiert den Dump immer noch.
Den Container diesen Port erreichen lassen
Das neue Cluster lauscht auf localhost, bis listen_addresses in /etc/postgresql/18/main/postgresql.conf die LAN-Adresse oder * enthält. Diese Einstellung wird angewendet, wenn das 18-Cluster startet, daher starten Sie es mit sudo pg_ctlcluster 18 main restart neu und prüfen Sie ss -lntp für 0.0.0.0:5433. „Connection refused" von einem anderen Host bedeutet, dass nichts TCP auf dieser Adresse und diesem Port akzeptiert.
In /etc/postgresql/18/main/pg_hba.conf, erlauben Sie den Hindsight-Host. Die Maske ist Teil der Zeile; ohne /32 überspringt PostgreSQL die Zeile beim Start.
host hindsight hindsight HINDSIGHT_HOST_IP/32 scram-sha-256
host matcht die SSL-Verbindungen, die Clients standardmäßig öffnen. Laden Sie mit sudo pg_ctlcluster 18 main reload neu. Die Adresse in einem folgenden „no pg_hba.conf entry … SSL encryption"-Fehler ist die Adresse, die Sie in diese Zeile schreiben sollten. Von Docker aus ist diese Adresse der Host, der den Container ausführt: die Bridge übersetzt die ausgehende Verbindung des Containers in die LAN-Adresse des Hosts.
Dumpen, dann mit dem 18-Client wiederherstellen
Halten Sie Schreiber an und dumpen Sie dann mit der pg0-Binärdatei. Zeilen, die nach pg_dump seinen Snapshot öffnet, behalten, fehlen im Archiv.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
Auf dem Datenbank-Host muss pg_restore die 18-Binärdatei sein. Der 14-Client kann dieses Archiv nicht lesen. Kopieren Sie die Datei zuerst nach /tmp. Der postgres-Systembenutzer kann das Home-Verzeichnis eines anderen Benutzers nicht betreten, daher meldet pg_restore „Permission denied" für einen Dump, den ls -l als für alle lesbar zeigt.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight lässt die wiederhergestellten Tabellen der Applikationsrolle gehören. --no-comments überspringt COMMENT ON EXTENSION, was mit „must be owner of extension btree_gin" fehlschlägt, wenn der Superuser die Erweiterung erstellte und die Applikationsrolle nicht. --single-transaction macht einen fehlgeschlagenen Load rückgängig, daher startet der nächste Lauf von einem leeren Schema aus. Ein Teil-Load, der von einem früheren Versuch übrig geblieben ist, benötigt DROP DATABASE und die drei CREATE EXTENSION-Aussagen erneut vor einem Wiederholungslauf.
Vergleichen Sie SELECT bank_id FROM banks ORDER BY 1 und SELECT count(*) FROM memory_units mit denselben Abfragen, die innerhalb des Containers vor dem Cutover ausgeführt werden.
Den Container schalten und das Volume behalten
Fügen Sie die URL zur Compose-.env von Option B hinzu und verwenden Sie den Port, an den das 18-Cluster tatsächlich gebunden ist:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:URL_ENCODED_PASSWORD@POSTGRES_IP:5433/hindsight
Übergeben Sie es in die Service-Umgebung als HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL}. Lassen Sie HINDSIGHT_API_WORKER_ID unverändert. Bleiben Sie bei ghcr.io/vectorize-io/hindsight:latest, wenn der Dienst HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL oder HINDSIGHT_API_RERANKER_LOCAL_MODEL setzt. latest-slim ist das Option-B-Image für Embedding- und Reranking-Endpunkte, die außerhalb des Containers laufen. Lassen Sie das hindsight-pg0-Volume montiert.
docker compose up -d erstellt den Container neu. Das Log sollte POSTGRES_IP in der „Connecting to database"-Zeile benennen und curl -f http://localhost:8888/health sollte "database":"connected" enthalten. GET /v1/default/banks listet die wiederhergestellten Datenbanken auf. Rufen Sie eine Tatsache ab, die Sie bereits gespeichert haben. Die veröffentlichten API- und UI-Ports bleiben dieselben, daher behalten Hermes und eine Coding-Agenten-Konfiguration ihre bestehende Basis-URL.
Das erneute Starten ohne HINDSIGHT_API_DATABASE_URL verwendet das Volume, das keine Writes erhielt, während die URL gesetzt war. Entfernen Sie das Volume, nachdem dieser Recall erfolgreich war. Verengen Sie pg_hba.conf auf die Einzelhost-Zeile, sobald der Container verbunden hat, und laden Sie neu.
Speicherdokument exportieren, importieren und migrieren
Das Verschieben einer eingebetteten Datenbank auf einen dedizierten Server und das Beibehalten der bereits gespeicherten Vektoren wird in Eingebettete Datenbank auf einen dedizierten Server verschieben behandelt. Die folgenden Schritte sind die Embedding-Modell-Änderung.
Das Ändern des Embedding-Modells ist keine Konfigurationsbearbeitung. Die Vektoren in der Datenbank wurden mit dem alten Modell berechnet, und ein anderes Modell — beispielsweise der eingebettete 384-dimensionale BGE-Embedder gegenüber dem 1024-dimensionalen Qwen3-Embedding-0.6B — schreibt in einen anderen Raum und normalerweise eine andere Breite. Sie können das bestehende Beispiel nicht auf den neuen Embedder umrichten und die alten Vektoren behalten; die Dimensionen müssen durch Neueinbettung jeder Erinnerung mit dem neuen Embedding-Modell neu berechnet werden.
Da der Embedder und seine Konfiguration pro Hindsight-Instanz gesetzt werden, ist der saubere Pfad, eine frische Instanz mit der neuen Embedding-Konfiguration aufzubauen und die Datenbank darin zu migrieren, anstatt Vektoren innerhalb desjenigen neu aufzubauen, das bereits Recall bedient. Die Hindsight-API kann die Datenbank auch verschieben, aber für eine einmalige Änderung ist Export/Import der einfachere und besser inspizierbare Weg:
# Export der Datenbank aus der alten Instanz
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# Import der Datenbank in die neue Instanz
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t verifiziert das Archiv, bevor Sie es zur neuen Instanz schicken. Nach dem Import, richten Sie Hermes auf die api_url der neuen Instanz in ~/.hermes/hindsight/config.json um, starten Sie das Gateway neu und führen Sie die Speicher-Verifizierung von früher aus: eine beibehaltene Tatsache sollte durch den neuen Embedder abrufen. Lassen Sie die alte Datenbank und ihre Vektoren in der alten Instanz, bis die neue funktioniert, damit Sie immer noch einen funktionierenden Fallback haben.
Datenbank überwachen, zurückschneiden und stabil halten
Mit der laufenden Datenbank ist die alltägliche Arbeit, zuzusehen, was das Extraktionsmodell beschlossen hat, zu speichern, und abgeleitete Zustände im Griff zu behalten. Verwenden Sie die Steuerungsfläche-UI (hindsight-embed -p hermes ui start), um Observations, Relevanzscores und Konsolidierungsoutput zu inspizieren, anstatt vorauszusetzen, dass memory status beweist, dass Ingestion und Recall korrekt sind. Duplizierte oder veraltete Erinnerungen sind normalerweise eine schwache Extraktion oder eine unterlaufende Konsolidierung, daher beheben Sie die Extraktionsebene oder den Konsolidierungs-Takt, bevor Sie Retrieval verbreitern.
Zwei Wartungsfallen sind es wert, getestet zu werden, bevor Sie auf die Datenbank vertrauen. Erstens, das Löschen einer Observation garantiert nicht, dass jede abgeleitete Darstellung damit verschwindet — eine reflect-Fakten oder ein Graphen-Edge, die daraus gebaut wurde, kann die Löschung überleben, daher verifizieren Sie Löschung von Ende zu Ende, dieselbe Provenienz-Bedenken, die in selbst verstärkende Speicher-Schleifen behandelt werden. Zweitens, halten Sie HINDSIGHT_API_WORKER_ID über Neuanlegungen hinweg stabil und pinnen Sie ein bestimmtes Image-Tag: eine Aufgabe, die bei einem Tod des Containers mitten im Flug war, bleibt unter der alten worker id festgefahren, und ein wandelndes Tag ist eine schlechte Passform für eine Datenbank, die Sie beizubehalten gedenken.
