
Hermes-Agent-Medaisystem: Wie persistente KI-Speicherfunktionen tatsächlich funktionieren
Gedächtnis ist der Unterschied zwischen einem Werkzeug und einem Partner.
Sie kennen das Spiel. Sie öffnen einen Chat mit einem KI-Agenten, erklären Ihr Projekt, teilen Ihre Präferenzen, erledigen etwas Arbeit und schließen den Tab. Kommen Sie in der folgenden Woche zurück, ist es, als würden Sie mit einem Fremden sprechen – der gesamte Kontext ist verschwunden, jede Präferenz vergessen, das Projekt von Grund auf neu erklärt.
Das ist kein Fehler. So funktionieren Large Language Models (LLMs) per Design. Sie sind zustandslos (stateless): Jede Anfrage ist unabhängig, jede Antwort wird auf Basis des Prompt generiert, den Sie gerade senden, ohne Gedächtnis, ohne Historie und ohne Kontinuität über die Token im aktuellen Kontextfenster hinaus.
Für Einzel-Interaktionen ist das in Ordnung. Stellen Sie eine Frage, erhalten Sie eine Antwort, machen Sie weiter. Aber für Agenten – Systeme, die über Sitzungen hinweg Dinge tun, aus Fehlern lernen und sich mit Ihnen weiterentwickeln sollen – ist die Zustandslosigkeit eine harte architektonische Grenze. Es ist eines der zentralen, ungelösten Probleme in selbstgehosteten KI-Systemen.
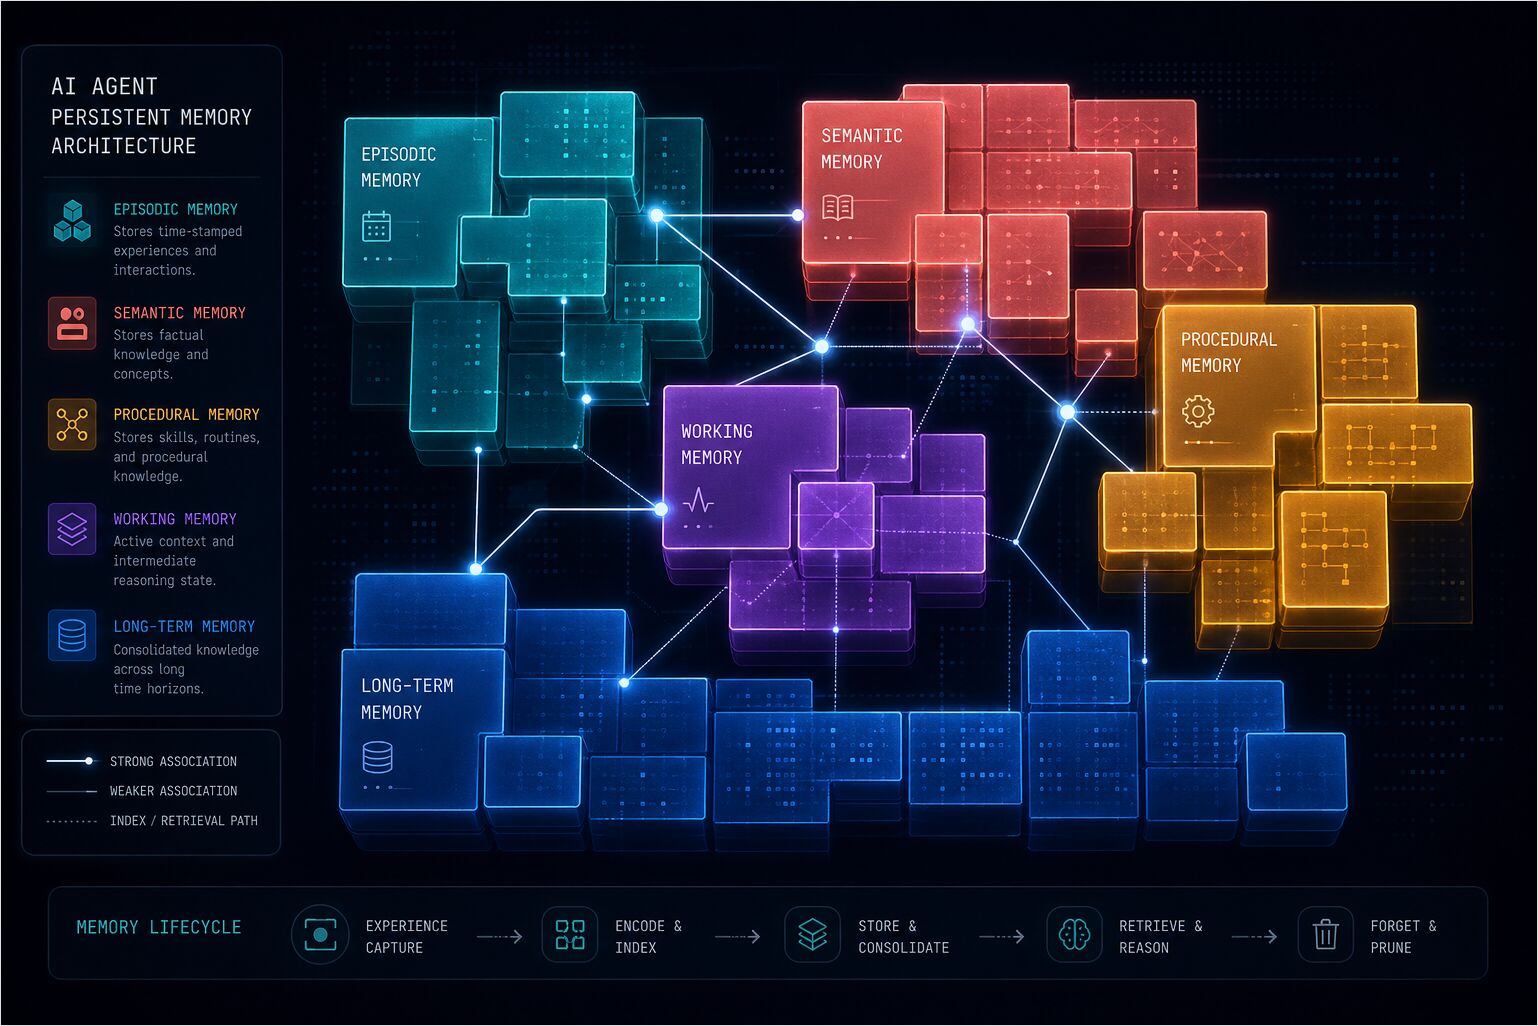
Die Branche hat versucht, dieses Problem zu lösen. LangChain hat Memory-Module hinzugefügt. OpenAI hat Assistenten mit Threads eingeführt. Frameworks wie Letta, Zep und Cognee haben ganze Architekturen um persistentes Gedächtnis herumgebaut. Databricks hat über „Memory Scaling“ publiziert – die Idee, dass die Leistungsfähigkeit von Agenten mit angesammelter Erfahrung steigt. Dedizierte Benchmark-Papiere, Überblicke zu episodischem Gedächtnis und ein schnell wachsendes Ökosystem von Tools sind seit 2024 entstanden, um dem zu begegnen, was zunehmend als eines der zentralen ungelösten Probleme der agentischen KI anerkannt wird.
Die meisten dieser Ansätze teilen ein gemeinsames Problem: Sie behandeln das Gedächtnis als nachträglichen Gedanken – eine Datenbank, die man abfragt, ein Kontextfenster, das man stopft, ein Retrieval-System, das Latenz und Rauschen hinzufügt, statt Klarheit.
Hermes Agent geht einen fundamental anderen Weg. Das Gedächtnis ist nicht etwas, das der Agent abruft, wenn es gebraucht wird. Es ist etwas, das der Agent zu jeder Zeit ist – in den System-Prompt eingebaut, kuratiert, begrenzt und immer aktiv. Es ist klein genug, um schnell zu sein, strukturiert genug, um nützlich zu sein, und diszipliniert genug, um zu wissen, was zu vergessen ist.
Dieser Artikel erklärt genau, wie das funktioniert – die Hermes-spezifische Schicht im übergreifenden Modell aus Gedächtnissysteme in KI-Assistenten und das weitergehende Stack in Architektur von KI-Assistenten. Für Aktivierungs- und Inspektionsbefehle (hermes memory, hermes dump, Log-Tailing) kombinieren Sie es mit dem Hermes Agent CLI Spickzettel. Für die komplementäre Seite von Hermes’ „Langzeitwissen“ – wiederverwendbare Verfahren in SKILL.md statt kuratierter Memory-Dateien – siehe [Hermes Agent Skill Authoring — SKILL.md Struktur und Best Practices](https://www.glukhov.org/de/ai-systems/hermes/authoring-hermes-skill/ “Erstellen Sie Hermes Skills mit YAML-Frontmatter, progressiver Offenlegung, bedingter Aktivierung, Secrets versus Config und Index-Fehlerbehebung.”}).
Teil 1: Das KI-Agenten-Gedächtnisproblem
Warum „einfach Kontext hinzufügen“ für Agenten nicht skalierbar ist
Die offensichtliche Lösung für zustandslose KI ist das Hinzufügen von Kontext. Hängen Sie die vorherige Konversation an. Schließen Sie die Projektdokumentation ein. Senden Sie die gesamte Historie.
Eine Zeit lang funktioniert das. Sie haben ein Kontextfenster von 128K. Sie können viel Text hineinpacken.
Aber Kontext ist kein Gedächtnis – es gibt einen echten und wichtigen Unterschied zwischen beiden. Kontext ist alles, was Ihnen gerade gezeigt wird; Gedächtnis ist das, was Sie aktiv bewahren und mit sich tragen.
Kontext hat keine Kuratierung. Es ist ein Datenabfluss: Wenn es wächst, muss das Modell tausende Token irrelevanter Historie verarbeiten, um die eine Tatsache zu finden, die es braucht. Das kostet Token und Geld, multipliziert die Latenz und stößt irgendwann an die Obergrenze.
Gedächtnis ist kuratiert. Es ist die Destillation von Erfahrung zu etwas Kompaktem und Aktionsfähigem. Es wächst nicht unendlich – es konsolidiert, aktualisiert und vergisst.
Das menschliche Gedächtnis funktioniert genauso. Sie erinnern sich nicht an jede Konversation, die Sie je hatten. Sie erinnern sich an die Teile, die wichtig sind: Mit wem Sie sprechen, woran sie interessiert sind, worüber Sie sich geeinigt haben, was Sie gelernt haben. Der Rest wird entweder vergessen oder ist bei Bedarf durchsuchbar.
Die Forschungslage
Der Bereich KI-Agenten-Gedächtnis hat sich seit 2024 stark ausgedehnt, mit dedizierten Benchmark-Suiten, einer wachsenden Forschungsliteratur und einer messbaren Leistungslücke zwischen verschiedenen architektonischen Ansätzen. Hier ist der aktuelle Stand.
Letta (ehemals MemGPT) war eines der ersten Frameworks, das persistentes Gedächtnis als Erstklass-Bedenken (first-class concern) behandelte und 21,7K GitHub-Stars erreichte. Es verwendet ein OS-inspiriertes dreistufiges Modell: Kerngedächtnis (klein, immer im Kontext), Recall-Gedächtnis (durchsuchbare Gesprächshistorie) und Archivgedächtnis (Langzeit-Kaltarchivierung). Die Erkenntnis, dass nicht alle Gedächtnisse gleich sind, war korrekt. Die Implementierung erfordert jedoch, dass Agenten vollständig innerhalb der Letta-Laufzeitumgebung laufen – die Adoption bedeutet die Adoption der gesamten Plattform, nicht nur einer Gedächtnisschicht.
Zep / Graphiti konzentriert sich auf konversationelles Gedächtnis mit zeitlicher Entitätserfassung – Fakten tragen Gültigkeitsfenster, sodass der Graph weiß, wann etwas wahr war. Es ist stark für Chatbots, die Beziehungsg graphs benötigen, weniger geeignet für autonome Agenten, die Umweltfakten und Projektkonventionen tracken.
Cognee ist für die Wissensextraktion aus Dokumenten und strukturierten Daten entwickelt, mit über 30 Ingestion-Connectors und einem Knowledge-Graph-Backend. Es exceliert bei institutionellem Wissen und RAG-Pipelines, ist aber weniger auf persönliches Agenten-Gedächtnis fokussiert. Siehe Cognee selbst hosten mit lokalen LLMs für einen praktischen Setup-Guide.
Hindsight macht Knowledge-Graph-basiertes Recall mit Entitätsbeziehungen und einem einzigartigen reflect-Synthese-Tool, das Cross-Memory-Synthese durchführt – es kombiniert mehrere Gedächtnise zu neuen Erkenntnissen. Es gehört zu den Top-Performern bei Agenten-Gedächtnis-Benchmarks und ist als Memory-Provider für Hermes Agent verfügbar.
Mem0 verarbeitet die Gedächtnisextraktion serverseitig per LLM-Analyse, mit minimaler Konfiguration. Die Mem0-Forschungspublikation, veröffentlicht auf ECAI 2025 (arXiv:2504.19413), hat zehn verschiedene Ansätze zum KI-Gedächtnis benchmarkt und den selektiven Extraktionsansatz validiert – Speicherung diskreter Fakten, Deduplizierung und Abruf nur dessen, was relevant ist. Mem0 ist auf etwa 48K GitHub-Stars gewachsen und unterstützt 21 Framework-Integrationen. Der Trade-off ist die Cloud-Abhängigkeit und die Kosten.
Databricks’ Forschung zu Memory Scaling führte das Konzept ein, dass die Agentenleistung mit angesammelter Erfahrung steigt. Ihre Architektur hält System-Prompts, Enterprise-Assets und episodische/semantische Erinnerungen auf Organisations- und Benutzerebene, validiert dabei die Idee, dass die Qualität des Gedächtnisses genauso wichtig ist wie die Modellfähigkeit.
Der rote Faden in den meisten Frameworks ist, dass sie das Gedächtnis als Retrieval-Problem behandeln: irgendwo speichern, bei Bedarf abfragen, in den Kontext injizieren. Hermes tut das Gegenteil – das Gedächtnis wird nicht bei Bedarf abgerufen, sondern beim Sitzungsstart injiziert und ist immer präsent. Immer aktiv, immer verfügbar, kuratiert genug, um nützlich zu bleiben.
Teil 2: Architektur
Lesen Sie diesen Teil von oben nach unten – Schichten und Recall/Store pro Runde zuerst, dann was in MEMORY.md und USER.md lebt, dann wie man einen externen Provider anhängt.
Zwei Schichten
Hermes stapelt das Gedächtnis in zwei Schichten:
- Eingebaut —
MEMORY.mdundUSER.md, dateibasiert, immer aktiv. Harte Grenzen von 2.200 Zeichen (Agenten-Notizen) und 1.375 Zeichen (Benutzerprofil). - Ein externer Provider (optional) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory und Gleichgesinnte, die Sie per Konfiguration aktivieren. Nur ein externes Backend läuft gleichzeitig. Es fügt Retrieval und Retention neben den Dateien hinzu; es ersetzt sie nicht.
Das mentale Modell ist additiv – eingefrorene Kerna Dateien plus höchstens ein Plugin. Prefetch- und Sync-Hooks orchestrieren die externe Schicht; die beiden Dateien bleiben separat als Teil des eingefrorenen System-Prompts injiziert.
Laufzeitfluss (Prefetch und Sync)
Der Recall findet vor der Modellantwort statt; die Persistenz nach der Assistenten-Nachricht. In Hermes Agents Memory-Manager entspricht dies Prefetch beim Hereinkommen und Sync beim Hinausgehen. Die Namen unten entsprechen der Implementierungsfläche (MemoryManager, pro-Provider prefetch / sync_turn / queue_prefetch).
User-Nachricht
    |
    v
MemoryManager.prefetch_all(query)        <-- Recall-Phase
    |
    +-- provider.prefetch(query)        <-- jeder externe Provider durchsucht seinen Speicher
    |
    v
Kontext in LLM-Runde injiziert
    |
    v
LLM antwortet (Assistenten-Nachricht)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- Store-Phase
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- Hintergrund-Suche auf die nächste Runde
Eingebaute MEMORY.md und USER.md werden nicht durch prefetch_all geholt – sie sind bereits Teil des eingefrorenen System-Prompts. Externe Backends hängen an prefetch_all / sync_all an; queue_prefetch erlaubt es einem Provider, das Retrieval für die folgende Runde vorzuwärmen, ohne die aktuelle Antwort zu blockieren.
Drei Pfade ins Langzeitgedächtnis
-
Eingebautes
memory-Tool. Das Modell ruftmemorymitadd,replaceoderremoveauf, wenn Anweisungen besagen, dass etwas persistent sein sollte – dauerhafte Fakten, Präferenzen, Korrekturen, Umwelt-Notizen.target='user'wartet USER.md;target='memory'wartet MEMORY.md. Beispielhafte Form:memory(action='add', target='user', content='…'). -
Passive Retention bei externen Providern. Jede Runde ruft das Framework den Sync-Pfad des Providers auf, damit Konversationen chunked, zusammengefasst oder extrahiert werden können, ohne dass das Modell jeden Fakten benennen muss. Das Verhalten variiert je nach Backend – zum Beispiel bündelt Hindsight Runden und führt strukturierte Retention mit Entitäten und Beziehungen aus; Honcho schickt Dialoge durch seine dialektische Pipeline; Mem0- und Supermemory-artige Stacks extrahieren Fakten passiv aus Runden.
-
Provider-spezifische Tools. Wenn das Plugin sie bereitstellt, speichern explizite Schreibvorgänge wie
honcho_conclude,hindsight_retainoderhoncho_profiledauerhafte Schnitte bei Bedarf.
Automatischer Recall versus Provider-Tools
Kerngedächtnis benötigt kein Lese-Tool – es ist bereits im Prompt. Externe Backends fügen entweder automatische Injektion aus Prefetch hinzu (kein separater Recall-Tool-Call für diesen Kontextschnit) oder explizite Retrieval-Tools (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect und Gleichgesinnte), wenn das Modell eine schärfere Abfrage braucht als nur Prefetch.
Recall-Modi (externe Provider)
Plugins unterstützen einen konfigurierbaren Recall-Modus (typischerweise recall_mode neben memory.provider in der Konfiguration), der Token gegen Kontrolle tauscht.
| Modus | Auto-Injektion aus Prefetch | Provider-Tools verfügbar | Typische Passform |
|---|---|---|---|
| context | Ja | Nein | Hände freibehalten, vorhersehbare Kontexte |
| tools | Nein | Ja | Modell wählt, wann abgerufen wird |
| hybrid | Ja | Ja | Reichhaltigster Kontext; höherer Token-Verbrauch |
Wenn kein externer Provider gesetzt ist (memory.provider leer oder nicht gesetzt), gelten nur die eingebauten Dateien und die Sitzungssuche – kein Prefetch/Sync aus einem Plugin.
Pfade auf der Platte und Budgets
Das eingebaute Gedächtnis von Hermes Agent lebt in zwei Dateien.
~/.hermes/memories/MEMORY.md— Persönliche Notizen des Agenten (2.200 Zeichen, ~800 Token)~/.hermes/memories/USER.md— Benutzerprofil (1.375 Zeichen, ~500 Token)
Das ist die gesamte persistente Gedächtnisfläche: zwei Dateien, unter 3.600 Zeichen insgesamt, weniger als 1.300 Token. Es sieht absichtlich klein aus, weil es das ist – und das ist genau die Designabsicht.
MEMORY.md: Die Notizen des Agenten
Hier speichert der Agent alles, was er über seine Umgebung, das Projekt, Tools, Konventionen und gelernte Lektionen erfährt. So sieht es aus:
Users projekt ist ein Go-Mikroservice unter ~/code/gateway, der gRPC + PostgreSQL verwendet
Dieser Rechner läuft mit Ubuntu 22.04, hat Docker und kubectl installiert
User bevorzugt snake_case für Variablennamen und vermeidet camelCase
Das sind keine Logs. Das sind Fakten. Dicht, deklarativer, informationsreich. Kein Zeitstempel, kein Füllmaterial, kein „am 5. Januar hat der User mich gebeten…“
USER.md: Das Benutzerprofil
Hier speichert der Agent alles, was er über Sie weiß.
User ist ein Full-Stack-Entwickler, der sich mit TypeScript, Go und Python auskennt.
User bevorzugt snake_case für Variablennamen und vermeidet camelCase.
User nutzt hauptsächlich Linux Ubuntu 22.04.
User deployt auf AWS mit Terraform.
Identität, Rolle, Präferenzen, technische Fähigkeiten, Kommunikationsstil, Ärgernisse. Das Zeug, das den Agenten Sie gegenüber anders antworten lässt als jedem anderen.
Das eingefrorene Snapshot-Muster
Beim Sitzungsstart werden beide Dateien von der Platte geladen und als eingefroener Block in den System-Prompt injiziert. So sieht es aus:
══════════════════════════════════════════════
MEMORY (Ihre persönlichen Notizen) [7% — 166/2.200 Zeichen]
══════════════════════════════════════════════
Users projekt ist ein Go-Mikroservice unter ~/code/gateway, der gRPC + PostgreSQL verwendet
§
Dieser Rechner läuft mit Ubuntu 22.04, hat Docker und kubectl installiert
§
User bevorzugt snake_case für Variablennamen und vermeidet camelCase
§
══════════════════════════════════════════════
USER PROFILE (wer der User ist) [8% — 110/1.375 Zeichen]
══════════════════════════════════════════════
User ist ein Full-Stack-Entwickler, der sich mit TypeScript, Go und Python auskennt.
§
User bevorzugt snake_case für Variablennamen und vermeidet camelCase.
§
Das Format verwendet Header, Nutzungsprozente, Zeichenzählungen und § (Abschnittszeichen) als Trenner. Einträge können mehrzeilig sein. Es ist so konzipiert, dass es vom Modell parsbar bleibt, während es menschlich lesbar ist.
Warum eingefroren? Prefix-Caching. Der System-Prompt ist über jede Runde in einer Sitzung hinweg derselbe. Indem das Gedächtnis nach dem Sitzungsstart statisch bleibt, kann das Modell die Prefix-Berechnung cachen und nur die variablen Teile verarbeiten – die Konversation. Das ist eine signifikante Performance-Optimierung. Sie berechnen die Attention über dieselben Memory-Token nicht bei jeder Runde neu.
Änderungen, die während einer Sitzung gemacht werden, werden sofort auf der Platte persistiert, erscheinen aber erst beim nächsten Sitzungsstart im System-Prompt. Tool-Antworten zeigen immer den Live-Zustand, aber der „Geist“ des Modells ändert sich nicht mitten in der Sitzung. Das verhindert, dass das Modell seinem eigenen Schwanz hinterherjagt – das Gedächtnis aktualisiert und dann in derselben Konversation auf seine eigene Update reagiert.
Zeichengrenzen als Feature
2.200 Zeichen. 1.375 Zeichen. Das sind keine willkürlichen Grenzen. Das sind Design-Constraints, die Kuratierung erzwingen.
Unbegrenztes Gedächtnis ist eine Last. Es ermutigt zum Einfüttern von allem, nie zu konsolidieren und am Ende zu Rauschen zu werden. Begrenztes Gedächtnis zwingt den Agenten zur Selektivität. Was ist wirklich wichtig? Was brauche ich erneut? Was kann komprimiert werden, ohne Bedeutung zu verlieren?
Wenn das Gedächtnis voll ist, scheitert der Agent nicht einfach schweigend. Er erhält einen Fehler mit aktuellen Einträgen und Nutzung, folgt dann einem Workflow:
- Aktuelle Einträge aus Fehlerantwort lesen
- Entfern- oder konsolidierbare Einträge identifizieren
replaceverwenden, um verwandte Einträge zu kürzeren Versionen zu mergen- Den neuen Eintrag hinzufügen
So bleibt das Gedächtnis nützlich. Es ist keine Datenbank. Es ist eine kuratierte Sammlung von Fakten, die wichtig sind.
Sicherheit: Prompt-Injection-Scanning
Jeder Gedächtniseintrag wird vor der Annahme gescannt. Das System blockiert Prompt-Injection-Versuche, Credential-Exfiltration, SSH-Backdoors und unsichtbare Unicode-Zeichen.
Das Gedächtnis wird auch dedupliziert. Exakte Duplikate werden automatisch abgelehnt. Das verhindert, dass Angreifer versuchen, bösartigen Inhalt durch wiederholte Einsendungen zu injizieren.
Externe Memory-Provider (Aktivierung und Links)
Abgesehen vom eingebauten MEMORY.md und USER.md kann Hermes Agent ein externes Memory-Plugin gleichzeitig anhängen – Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover oder Supermemory – für persistente, cross-sitzungswissende. Nur ein externer Provider ist gleichzeitig aktiv; die zwei Kerna Dateien bleiben daneben geladen (additiv, nicht ersetzend).
Aktivieren und inspizieren Sie Provider mit hermes memory setup, hermes memory status und hermes memory off, oder setzen Sie memory.provider und recall_mode in ~/.hermes/config.yaml. Credential-Muster variieren (zum Beispiel HINDSIGHT_API_KEY, Honcho-Keys unter $HERMES_HOME/honcho.json); verwenden Sie hermes memory setup für interaktives Wiring.
Minimale, nur-eingebaut-YAML-Form:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Aktivierungsbeispiel für ein Backend (tauschen Sie hindsight durch honcho, mem0, supermemory oder andere, die Ihre Installation unterstützt):
memory:
  provider: "hindsight"
Für die vollständige Vergleichstabelle, LLM- und Embedding-Abhängigkeitsnotizen, Provider-Brüche und wie diese Backends zu OpenClaw und anderen Stacks stehen, siehe Agent Memory Provider verglichen. Für einen lokalen, selbstgehosteten Provider mit ungewöhnlich granularen Schreibkontrollen, siehe Mnemosyne für Hermes Agent: Lokale Memory Quickstart – und Self-Reinforcing Memory Loops in AI Agents für das, warum begrenztes, kuratiertes Gedächtnis wie Hermes’ eigener MEMORY.md mehrere Feedback-Loop-Fehlerszenarien durch Konstruktion umgeht.
Für profil-spezifisches Wiring und Produktions-Workflows, siehe Hermes Agent Produktions-Setup. Der AI Systems Memory Hub listet diesen Guide plus verwandte Cognee- und Knowledge-Layer-Artikel.
Teil 3: Wenn das Gedächtnis feuert — Trigger & Entscheidungen
Die häufigste Frage über das Gedächtnis von Hermes Agent ist, wann es tatsächlich etwas speichert.
Die Antwort ist: ständig, aber selektiv. Der Agent verwaltet sein eigenes Gedächtnis über das memory-Tool, und die Entscheidung zu speichern wird durch eine Kombination aus expliziten Signalen und impliziten Mustern getrieben.
Schreib-Trigger: Wann entscheidet sich der Agent zu speichern?
Der Agent speichert Gedächtnis proaktiv. Er wartet nicht darauf, dass Sie ihn bitten. Hier ist, was ihn auslöst.
Benutzerkorrekturen. Wenn Sie den Agenten korrigieren, ist das ein Signal zum Merken. „Mach das nicht noch einmal.“ „Verwende stattdessen das.“ „Merke dir das.“ Das sind explizite Anweisungen, das Gedächtnis zu aktualisieren.
Beispiel: Sie bitten den Agenten, eine Python-Umgebung zu konfigurieren. Er schlägt pip vor. Sie sagen „Ich verwende poetry für alles.“ Der Agent speichert: User bevorzugt den Verwendung des 'poetry' Package Managers für alle Python-Projekte.
Entdeckte Präferenzen. Der Agent beobachtet Muster und leitet Präferenzen ab. Wenn Sie konsistent ein bestimmtes Tool, Framework oder Workflow verwenden, wird es gespeichert.
Beispiel: Nachdem Sie poetry in verschiedenen Projekten mehrfach verwendet haben, speichert der Agent es als Präferenz.
Umweltfakten. Dinge über den Rechner, das Projekt, die installierten Tools. Diese werden durch Exploration entdeckt und als Fakten gespeichert.
Beispiel: Der Agent prüft, was installiert ist, und speichert: Dieser Rechner läuft mit Ubuntu 22.04, hat Docker und kubectl installiert.
Projektkonventionen. Wie das Projekt strukturiert ist, welche Tools es verwendet, welche Muster es folgt. Diese werden durch Code-Inspektion entdeckt und gespeichert.
Beispiel: Users projekt ist ein Go-Mikroservice unter ~/code/gateway, der gRPC + PostgreSQL verwendet.
Abgeschlossene komplexe Workflows. Nach dem Abschluss einer Aufgabe, die 5+ Tool-Calls dauerte, betrachtet der Agent, den Ansatz als Skill zu speichern oder zumindest zu notieren, was funktioniert hat.
Tool-Kuriositäten und Workarounds. Wenn der Agent etwas Nicht-Offensichtliches über ein Tool, eine API oder ein System entdeckt – eine Einschränkung, einen Workaround, eine Konvention – speichert er es.
Was übersprungen wird:
- Triviale oder offensichtliche Informationen
- Dinge, die leicht wiederentdeckt werden können
- Rohe Datenabflüsse
- Sitzungsspezifische Ephemera
- Informationen, die bereits in Kontextdateien (SOUL.md, AGENTS.md) sind
Lese-Trigger: Wann ruft der Agent ab?
Gedächtnis wird nicht abgerufen – es ist immer da. Aber es gibt verschiedene Zugangsebenen.
Sitzungsstart (automatisch). MEMORY.md und USER.md werden in den System-Prompt injiziert. Der Agent hat sie ab dem ersten Token. Keine Abfrage nötig, keine Latenz, kein Tool-Call. Das ist das Kerngedächtnis – immer aktiv.
session_search (bei Bedarf). Wenn der Agent etwas aus vergangenen Konversationen finden muss, das nicht im Kerngedächtnis ist, verwendet er das session_search-Tool. Das fragt SQLite (~/.hermes/state.db) mit FTS5-Volltextsuche und Gemini-Flash-Zusammenfassung ab. Verwenden Sie dies, wenn die Frage klingt wie „wir haben das letzte Woche besprochen“, nicht wie „merke dir diese Tatsache für immer“.
Beispiel: Sie fragen „Haben wir letzte Woche Docker-Netzwerke besprochen?“ Der Agent durchsucht die Sitzungshistorie und liefert eine Zusammenfassung der relevanten Konversation.
Externe Provider-Tools (wenn konfiguriert). Wenn ein externes Memory-Provider aktiv ist, führt das Framework vor jeder Antwort auch einen automatischen Prefetch-Schritt aus (siehe Teil 2). Zusätzliche Tools wie honcho_search, hindsight_recall oder mem0_search sind für gezielte Lookups, wenn der Agent explizites Retrieval wählt – je nach recall_mode können automatische Injektion, Tools oder beide aktiv sein.
Der Entscheidungsbaum
So wiegt der Agent „ist es das wert, erinnert zu werden?“.
Ist es eine Korrektur oder explizite Anweisung?
  JA → Speichere ins Gedächtnis
  NEIN → Ist es eine Präferenz oder ein Muster?
    JA → Speichere ins Benutzerprofil
    NEIN → Ist es ein Umweltfakt oder eine Konvention?
      JA → Speichere ins Gedächtnis
      NEIN → Kann es leicht wiederentdeckt werden?
        JA → Überspringen
        NEIN → Ist es sitzungsspezifisch?
          JA → Überspringen
          NEIN → Speichere ins Gedächtnis
Der Agent überdenkt dies nicht. Er speichert proaktiv, konsolidiert, wenn voll, und vertraut den Zeichengrenzen, die Dinge straff zu halten.
Teil 4: Internes Gedächtnis versus Externe Wissensbasen
Hier passiert oft Verwirrung. Hermes Agent hat internes Gedächtnis (MEMORY.md, USER.md, externe Provider) und externe Wissensbasen (LLM Wiki, Obsidian, Notion, ArXiv, Dateisystem), und sie erfüllen völlig unterschiedliche Rollen. Das ähnelt der Unterscheidung zwischen Retrieval-Augmented Generation (RAG) Pipelines und dem Arbeitsgedächtnis von Agenten – externes Retrieval ist gut für tiefe Wissenslookups, nicht zum Tragen von Identität und Präferenzen. Internes Gedächtnis ist das Gehirn des Agenten – immer aktiv, kuratiert, in jede Sitzung getragen. Externe Wissensbasen sind seine Bibliothek – riesige Referenzressourcen, die bei Bedarf konsultiert werden.
Die Unterscheidung
Internes Gedächtnis (das Gehirn):
- Klein, persistent, in System-Prompt injiziert
- Enthält: Benutzerpräferenzen, Agentenkonventionen, unmittelbare Lektionen
- Immer „im Kopf“ während der Konversation
- Kuratiert, begrenzt, aktiv verwaltet
- Beispiele: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Externe Wissensbasen (die Bibliothek):
- Riesig, nur Referenz, bei Bedarf zugänglich
- Enthält: Dokumente, Papiere, Code, Notizen, Datenbanken
- Über Tools bei Bedarf abgerufen
- Nicht „erinnert“ – nachgeschlagen
- Beispiele: LLM Wiki, Obsidian, Notion, ArXiv, Dateisystem, GitHub
Wie sie zusammenhängen
Der Agent zugreift auf externe Basen über Tools bei Bedarf. Er „erinnert“ sie sich nicht – er schaut sie nach.
LLM Wiki (llm-wiki): Karpathys interlinktes Markdown-Wissensbasis zum Bauen und Abfragen von Domänenwissen. Der Agent verwendet das llm-wiki-Skill zum Lesen, Suchen und Abfragen. Es ist eine Referenzressource, kein Gedächtnis.
Obsidian: Persönliche Notiz-Vaults mit bidirektionalen Links. Der Agent verwendet das obsidian-Skill zum Lesen, Suchen und Erstellen von Notizen. Obsidian ist Teil des breiteren Personal Knowledge Management Ökosystems, auf das Hermes als Bibliotheksressource zugreifen kann.
Notion/Airtable: Strukturierte Datenbanken und Wikis, abgerufen über API. Der Agent fragt sie bei Bedarf ab.
ArXiv: Akademische Papier-Repositorien. Der Agent durchsucht und extrahiert Papiere, wenn er ein Thema recherchiert.
Dateisystem: Projektcode, Dokumentation, Konfigurationen. Der Agent liest Dateien, wenn er an einem Projekt arbeitet.
Das Destillationsmuster
Hier ist die Schlüsselinsicht: Kritisches Wissen aus externen Basen kann in das interne Gedächtnis destilliert werden.
Beispiel: Der Agent liest ein Papier von ArXiv über Memory Scaling für KI-Agenten. Er speichert das gesamte Papier nicht ins Gedächtnis. Er speichert die Kernaussage: Memory Scaling: Agentenleistung steigt mit angesammelter Erfahrung durch User-Interaktion und Geschäftskontext, die im Gedächtnis gespeichert werden.
Die externe Ressource ist riesig. Das interne Gedächtnis ist die Destillation.
Wann welches zu verwenden
Internes Gedächtnis für:
- „Wem helfe ich?“
- „Was bevorzugen sie?“
- „Was haben wir gerade gelernt?“
- „Wie ist das Projekt-Setup?“
- „Welche Tools sind verfügbar?“
Externe Wissensbasen für:
- „Was ist die neueste Forschung zu X?“
- „Was ist in der Dokumentation meines Projekts?“
- „Worüber haben wir letzten Monat gesprochen?“
- „Wie ist die API für diesen Service?“
- „Wie ist die Code-Struktur?“
Der Agent versteht den Unterschied und verwendet jedes entsprechend – er verwechselt das Nachschlagen eines Dokuments nicht mit dem Erinnern von etwas, das er über Sie und Ihre Umgebung gelernt hat.
Teil 5: Wie es tatsächlich funktioniert
Schauen wir uns die Mechanik an.
Das memory-Tool
Der Agent verwaltet das Gedächtnis über ein einzelnes Tool mit drei Aktionen: add, replace, remove.
Es gibt keine read-Aktion – der Gedächtnisinhalt wird automatisch in den System-Prompt injiziert. Der Agent muss es nicht lesen, weil es immer da ist.
add — Fügt einen neuen Eintrag hinzu.
memory(action="add", target="memory",
       content="User läuft macOS 14 Sonoma, verwendet Homebrew, hat Docker Desktop installiert.")
replace — Ersetzt einen vorhandenen Eintrag using Substring-Matching.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="User bevorzugt Light Mode in VS Code, Dark Mode im Terminal")
remove — Entfernt einen Eintrag using Substring-Matching.
memory(action="remove", target="memory",
       old_text="temporäre Projekt-Fakt")
Substring-Matching
replace und remove verwenden kurze, eindeutige Substrings via old_text. Sie brauchen nicht den vollständigen Eintragstext. Das ermöglicht chirurgische Edits, ohne den exakten Inhalt zu kennen.
Wenn ein Substring mehrere Einträge matcht, wird ein Fehler zurückgegeben, der um eine spezifischere Abfrage bittet. Der Agent verfeinert dann seine Abfrage.
Ziel-Speicher: memory versus user
Der target-Parameter bestimmt, welche Datei aktualisiert wird.
memory— Persönliche Notizen des Agenten. Umweltfakten, Projektkonventionen, Tool-Kuriositäten, gelernte Lektionen.user— Benutzerprofil. Identität, Rolle, Zeitzone, Kommunikationspräferenzen, Ärgernisse, Workflow-Gewohnheiten.
Kapazitätsmanagement
Wenn das Gedächtnis >80% voll ist, konsolidiert der Agent. Er mergt verwandte Einträge, entfernt veraltete Fakten und komprimiert Informationen.
Gute Gedächtniseinträge sind kompakt und informationsdicht:
User läuft macOS 14 Sonoma, verwendet Homebrew, hat Docker Desktop installiert. Shell: zsh mit oh-my-zsh. Editor: Neovim mit Telescope-Plugin.
Schlechte Gedächtniseinträge sind vage oder langatmig:
User hat ein Projekt.
Am 5. Januar 2026 bat mich der User, sein Projekt unter ~/code/gateway zu betrachten, das Go mit gRPC und PostgreSQL für die Datenbankschicht verwendet.
Der erste ist dicht und nützlich. Der zweite ist entweder zu vage oder zu langatmig.
Sitzungssuche versus Persistentes Gedächtnis
session_search und persistentes Gedächtnis erfüllen unterschiedliche Zwecke.
| Feature | Persistentes Gedächtnis | Sitzungssuche |
|---|---|---|
| Kapazität | ~1.300 Token insgesamt | Unbegrenzt (alle Sitzungen) |
| Geschwindigkeit | Sofort (im System-Prompt) | Benötigt Suche + LLM-Zusammenfassung |
| Verwendungszweck | Schlüssel-Fakten immer verfügbar | Finden spezifischer vergangener Konversationen |
| Management | Manuell kuratiert vom Agenten | Automatisch — alle Sitzungen gespeichert |
| Token-Kosten | Fix pro Sitzung (~1.300 Token) | Bei Bedarf (abgesucht, wenn nötig) |
Faustregel: Verwenden Sie Gedächtnis für kritische Fakten, die immer im Kontext sein sollten. Verwenden Sie Sitzungssuche für historische Lookups.
Teil 6: Die Philosophie
Warum begrenztes Gedächtnis unbegrenztes Gedächtnis schlägt
Der Impuls ist, das Gedächtnis so groß wie möglich zu machen. Speichere alles. Rufe ab, was du brauchst.
Begrenztes Gedächtnis funktioniert besser. Hier ist der Grund.
Kuratierung erzwingt Qualität. Wenn Sie begrenzten Platz haben, speichern Sie nur das, was wichtig ist. Sie komprimieren, konsolidieren und priorisieren. Unbegrenztes Gedächtnis ermutigt, alles reinzustopfen und nie aufzuräumen.
Geschwindigkeit zählt. 1.300 Token im System-Prompt ist schnell. 100.000 Token, aus einer Datenbank abgerufen, ist langsam. Gedächtnis sollte sofort verfügbar sein, nicht eine Abfrage.
Rauschen degradiert Performance. Mehr Gedächtnis ist nicht besseres Gedächtnis. Es ist rauschigeres Gedächtnis. Das Modell muss Signal von Rauschen unterscheiden, und das kostet Aufmerksamkeit – Aufmerksamkeit, die für die eigentliche Aufgabe ausgegeben werden sollte.
Vergessen ist ein Feature. Menschliches Gedächtnis vergisst. Das ist kein Bug – das ist, wie wir priorisieren. Agenten sollten auch vergessen. Nicht alles verdient es, erinnert zu werden.
Das „Vergessen“-Problem
Agenten müssen Unlernen. Nicht nur vergessen, aber aktiv veraltete Informationen entfernen.
So verarbeitet Hermes Agent es:
remove-Aktion: Löschen Sie Einträge, die nicht mehr relevant sind.replace-Aktion: Aktualisieren Sie Einträge mit neuen Informationen.- Kapazitätsdruck: Wenn das Gedächtnis voll ist, konsolidiert der Agent und entfernt alte Einträge.
- Sicherheitsscan: Blockiert bösartige oder korrupte Einträge.
Vergessen ist kein Fehlschlag – es ist Wartung. Ein Agent, der nicht unlernen kann, wird am Ende so viel Rauschen wie Signal tragen.
Memory Scaling
Databricks führte das Konzept von „Memory Scaling“ ein: Performiert ein Agent mit tausenden Benutzern besser als einer mit einem einzelnen Benutzer?
Ihre Forschung deutet darauf hin, ja, aber mit Vorbehalten. Memory Scaling erfordert:
- Qualitative Extraktion: Nicht alle Interaktionen sind es wert, erinnert zu werden. Der Agent muss Erkenntnisse extrahieren, keine Logs.
- Effektives Retrieval: Abgerufene Erinnerungen müssen relevant sein. Rauschen degradiert Performance.
- Generalisierung: Erinnerungen sollten Muster sein, keine Spezifika. „User bevorzugt Python“ skaliert. „User hat Befehl X um Zeitstempel Y ausgeführt“ tut es nicht.
Das begrenztes Gedächtnis von Hermes Agent unterstützt Memory Scaling natürlich. Indem es Kuratierung erzwingt, stellt es sicher, dass Erinnerungen generalisierbar, kompakt und nützlich sind.
Was das für die Zukunft bedeutet
Gedächtnis wird zum Wettbewerbsvorteil in der agentischen KI – nicht das Modell selbst, sondern das, was das Modell zwischen Sitzungen trägt. Zwei Agenten mit identischen zugrundeliegenden Modellen können sehr unterschiedlich performen: einer erinnert sich an Ihre Präferenzen, Ihre Umgebung und Ihre vergangenen Fehler; der andere startet jedes Mal kalt.
Die Frage ist nicht mehr, ob Agenten persistentes Gedächtnis haben sollten. Das ist entschieden: sie müssen. Die offene Frage ist, wie man dieses Gedächtnis gut gestaltet – was man behält, was man verwirft, wie man es sofort verfügbar macht und wie man verhindert, dass es zu Rauschen wird.
Die Antwort von Hermes Agent ist, das Gedächtnis klein, kuratiert und immer aktiv zu halten – keine Datenbank, die man abfragt, sondern ein Arbeitsmodell des Benutzers, das der Agent in jede Konversation mitnimmt.
Fazit
Das Gedächtnissystem von Hermes Agent ist absichtlich einfach: zwei Dateien, feste Zeichengrenzen, keine Retrieval-Pipeline, keine Vektordatenbank, und keine Latenz pro Abfrage. Was wie eine Einschränkung klingt, ist der ganze Punkt.
Es funktioniert, weil es das Gedächtnis so behandelt, wie ein Gehirn funktioniert, nicht wie eine Datenbank – klein, kuratiert und immer aktiv. Der Agent ruft das Gedächtnis nicht ab, wenn er es braucht; das Gedächtnis ist einfach immer da, in den System-Prompt vom ersten Token jeder Sitzung verwebt.
Externe Memory-Provider erweitern dieses System für Benutzer, die mehr brauchen: Knowledge Graphs, Multi-Agent-Unterstützung, selbstgehosteter Speicher, Enterprise-Features. Aber der Kern bleibt derselbe: begrenzt, kuratiert, immer verfügbar.
Und externe Wissensbasen – LLM Wiki, Obsidian, Notion, ArXiv – erfüllen eine andere Rolle. Sie sind die Bibliothek, nicht das Gehirn. Der Agent schaut sie nach, erinnert sie sich nicht. Kritische Erkenntnisse werden in das interne Gedächtnis destilliert; der Rest bleibt in der Bibliothek.
So erinnert sich ein KI-Agent an Sie. Nicht, indem er alles speichert, sondern indem er sich an das erinnert, was wichtig ist.
Hermes Agent wurde von Nous Research im Februar 2026 veröffentlicht und erreichte bis April 2026 über 64.000 GitHub-Stars (v0.9.0), mit über 242 Mitwirkenden. Es ist Open-Source und verfügbar auf github.com/NousResearch/hermes-agent. Für Installations-, Konfigurations- und Workflow-Guides, siehe die Hermes Agent Übersicht.
